그림 18따라하기관
세계의 문자: 한글 제자 원리와 다른 문자 22종
1446년 해례본은 ㄱ을 혀뿌리가 목구멍을 막는 모양이라고 적었습니다. 그 한글을 쐐기문자부터 점자까지 다른 문자 22종과 나란히 놓았습니다.
이 기기에서는 3D를 띄울 수 없습니다. 아래 안내 단계를 글로 볼 수 있습니다.
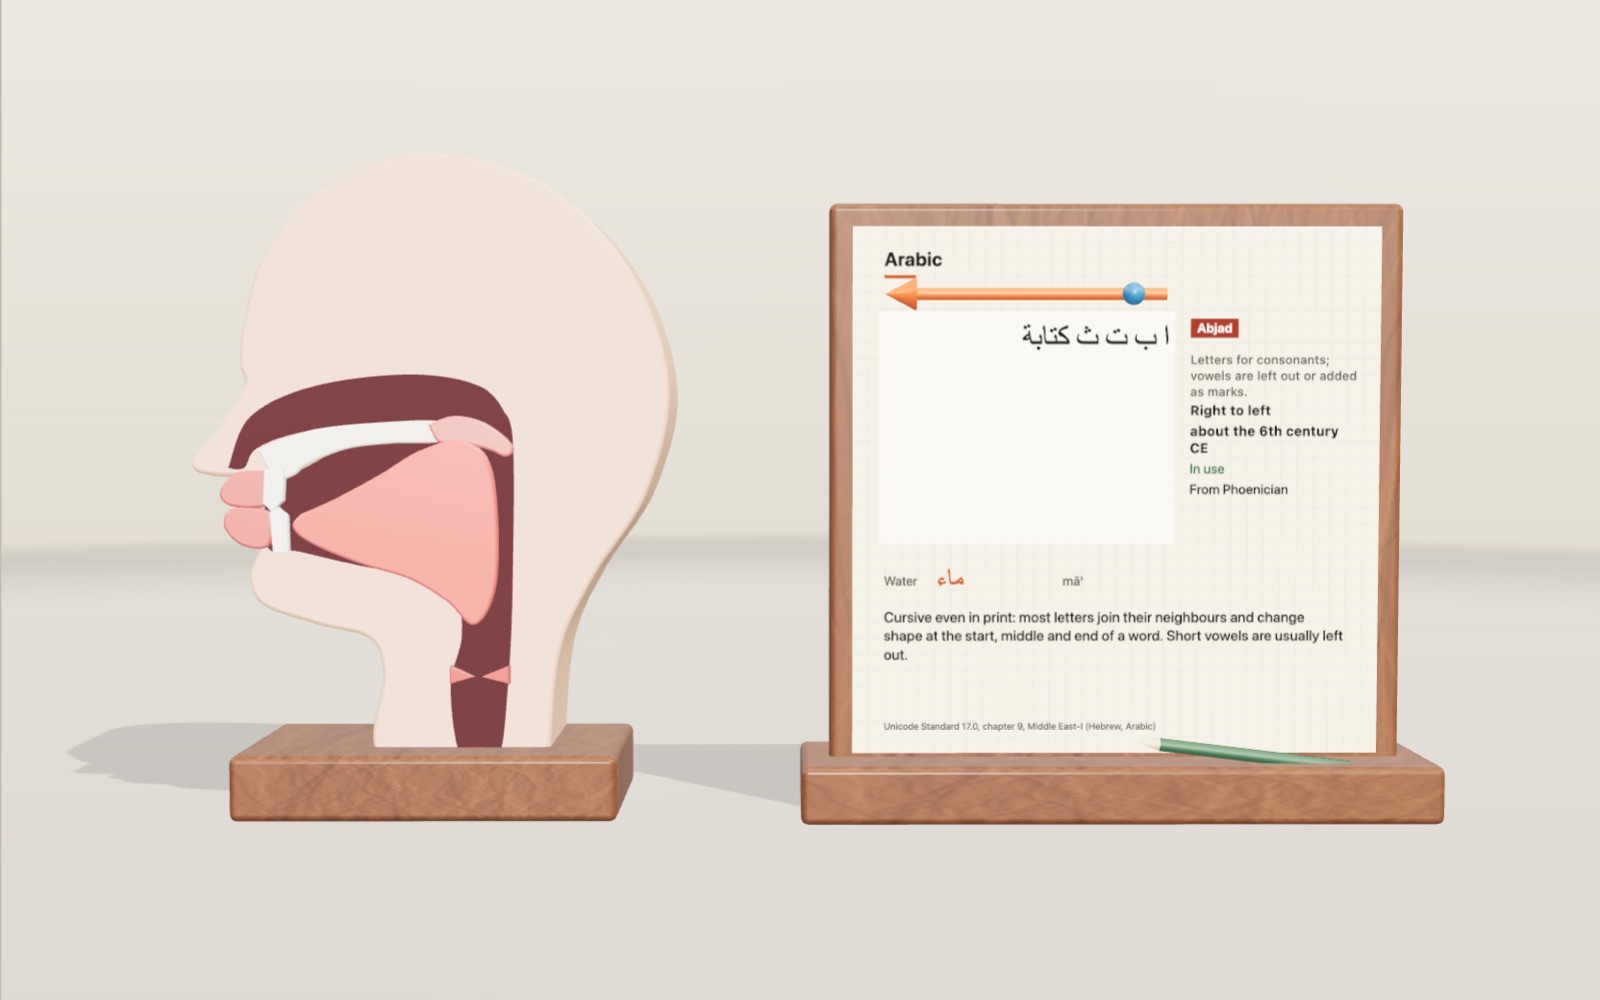
1 / 19 머리 단면과 글자 판왼쪽은 머리를 가운데로 자른 단면이고, 오른쪽은 글자를 쓰는 판입니다. 자음마다 혀와 입술, 여린입천장이 움직이고, 그 자음 글자가 단면 위에 주황색으로 겹쳐 나타납니다.
끌어서 돌리고, 휠이나 두 손가락으로 확대하세요.
이 전시에서 볼 수 있는 것
「강」이라고 천천히 말해 보세요. 첫소리를 낼 때 혀의 뒷부분이 입천장 뒤쪽에 붙어 숨을 잠깐 막습니다. 그 소리를 적는 글자가 ㄱ이고, 1446년에 새 문자를 알린 책은 ㄱ의 모양이 바로 이 움직임을 그린 것이라고 설명합니다.
무대 왼쪽에는 해부도처럼 머리를 가운데로 자른 단면이 있습니다. 입술, 앞니, 딱딱한 입천장, 그 뒤에 늘어진 여린입천장, 혀, 그리고 성대까지 이어지는 목구멍이 보입니다. 기본 자음 다섯 개 가운데 하나를 고르면 혀와 입술, 여린입천장이 그 소리를 낼 때의 자리로 움직이고, 그 글자가 주황색 관 모양으로 단면 위에 겹쳐 나타납니다. 「숨의 흐름」을 켜면 숨이 어디로 가는지도 보입니다. ㄱ에서는 혀 뒤에서 막히고, ㄴ과 ㅁ에서는 코로 나가며, ㅅ에서는 좁은 틈으로 빠져나갑니다.
오른쪽은 글자를 쓰는 판이고, 장면이 열두 개입니다. 여섯은 한글을 따라갑니다. 기본 자음 다섯, 획을 더해 만든 글자, 모음, 음절 조합, 획순과 따라 쓰기, 그리스·키릴 문자 표입니다. 나머지 여섯은 다른 문자로 시야를 넓힙니다. 세계 문자 23종의 카드, 그 가운데 22개 문자로 쓴 「물」, 13개 문자로 바꾼 내 이름, 한자 옆에 놓은 가나, 세 시대의 한자, 그리고 머리 단면 자리에 3D로 나오는 쓰는 재료 다섯 가지입니다. 따라 쓸 수 있는 한글, 그리스, 키릴 문자와 한자, 가나는 글꼴로 찍은 것이 아닙니다. 글자마다 손으로 쓰는 순서와 방향대로 획의 좌표를 적어 두고 그것으로 그립니다. 그래서 판이 여러분이 그은 획도 하나하나 확인할 수 있습니다. 다른 문자들은 글꼴로 찍고, 드문 문자에는 작은 글꼴 파일을 씁니다.
다섯 글자는 발음 기관을 본떴습니다
그리스 문자는 페니키아 문자를 고쳐 쓴 것이고, 라틴 문자는 그리스 문자에서 나왔습니다. 글자 모양이 오랜 세월 물려받고 바뀌면서 굳어진 것입니다. 한글은 만든 사람들이 왜 그런 모양을 골랐는지 글로 남겼다는 점이 다릅니다. 그 책이 「백성을 가르치는 바른 소리」라는 뜻의 『훈민정음』이고, 풀이가 붙은 해례본이 글자마다 만든 방법을 설명합니다.
자음은 기본 모양 다섯에서 출발합니다. 소리를 낼 때 가장 중요한 일을 하는 발음 기관의 모양을 그린 것입니다. 국립국어원은 이렇게 정리합니다.
| 글자 | 1446년의 분류 | 본뜬 모양 |
|---|---|---|
| ㄱ | 아음(어금닛소리) | 혓등이 여린입천장에 닿는 모양 |
| ㄴ | 설음(혓소리) | 혀끝이 윗니 바로 뒤의 잇몸에 닿는 모양 |
| ㅁ | 순음(입술소리) | 윗입술과 아랫입술이 다물어진 모양 |
| ㅅ | 치음(잇소리) | 이의 모양 |
| ㅇ | 후음(목구멍소리) | 목구멍의 모양 |
ㄱ에 대한 해례본의 원문은 「象舌根閉喉之形」, 혀뿌리가 목구멍을 막는 모양을 본떴다는 뜻입니다. 모형처럼 얼굴을 왼쪽으로 향하게 하면 맞아떨어지는 모습이 잘 보입니다. 혀가 입천장 아래를 따라 뒤로 가다가 뒤쪽에서 아래로 꺾입니다. 가로로 가다 아래로 꺾이는 선, 그것이 ㄱ입니다. ㄴ에서는 혀끝이 앞쪽 잇몸에 세로로 붙고, 혀의 몸통이 거기서 뒤로 이어집니다. 세로로 내려와 오른쪽으로 꺾이는 선입니다.
ㅁ은 앞에서 본 다문 입이라 네모입니다. ㅅ은 뾰족한 이, ㅇ은 열린 목구멍인 동그라미입니다. ㅇ은 오늘날 음절 첫머리에서 아무 소리도 내지 않는 유일한 기본자이기도 합니다. 「우유」의 두 ㅇ은 초성 자리를 채우기만 합니다.
소리가 세지면 획을 더했습니다
다섯 글자만으로는 말을 다 적을 수 없으니 나머지 글자는 기본자에서 만들었습니다. 규칙은 간단합니다. 같은 자리에서 나는 소리가 더 세면 획을 하나 더합니다. ㄴ이 ㄷ이 되고, ㄷ이 ㅌ이 됩니다. ㅁ은 ㅂ을 거쳐 ㅍ으로, ㅅ은 ㅈ을 거쳐 ㅊ으로, ㅇ은 ㆆ을 거쳐 ㅎ으로 갑니다. 어금닛소리는 ㄱ에서 ㅋ으로 한 단계만 있습니다.
판의 두 번째 장면에서는 줄마다 이런 글자 가족이 하나씩 놓여 있고, 새로 더한 획은 주황색으로 그려집니다. 재생을 누르면 줄이 차례로 바뀌면서 글자가 앞 글자에 이어 그려집니다.
이 규칙을 따르지 않는 글자가 셋 있습니다. ㆁ(지금은 받침 ㅇ으로 적는 콧소리), ㄹ, ㅿ은 획을 더하지 않고 모양을 따로 만들었습니다. 1446년 해례본은 이들을 모양을 달리한 글자라고 부릅니다.
글자를 늘리는 방법이 하나 더 있습니다. 예사소리 글자를 옆으로 두 번 쓰면 된소리 글자 ㄲ, ㄸ, ㅃ, ㅆ, ㅉ이 됩니다. 국립국어원은 예사소리, 거센소리, 된소리의 관계(ㄱ, ㅋ, ㄲ)가 글자 모양에 그대로 드러난다고 설명합니다. 거센소리는 획 하나를 더하고, 된소리는 같은 글자를 나란히 씁니다.
모음은 하늘, 땅, 사람에서 나왔습니다
모음은 다른 생각에서 출발했습니다. 기본 글자 셋이 동양 철학에서 만물의 바탕으로 여긴 세 가지를 나타냅니다. 둥근 점 ·는 하늘, 평평한 ㅡ는 땅, 꼿꼿이 선 ㅣ는 그 사이에 선 사람입니다.
나머지 기본 모음은 모두 이 셋의 조합입니다. 점을 ㅡ 위에 놓으면 ㅗ, 아래에 놓으면 ㅜ입니다. ㅣ 오른쪽에 놓으면 ㅏ, 왼쪽에 놓으면 ㅓ입니다. 점을 두 개 찍으면 ㅛ, ㅠ, ㅑ, ㅕ가 되는데, 같은 모음 앞에 짧은 「ㅣ」 소리가 붙은 이중 모음입니다. 1446년 판본에서는 이 점이 정말 둥근 점이었습니다. 세월이 지나면서 지금 쓰는 짧은 획이 되었고, 판의 모음 장면은 두 모양을 위아래로 나란히 보여 줍니다.
더 복잡한 모음도 다시 글자를 합쳐 만들었습니다. ㅗ와 ㅏ를 합치면 ㅘ, ㅜ와 ㅓ를 합치면 ㅝ입니다. ㅐ와 ㅔ도 한글이 처음 만들어졌을 때는 두 소리가 이어지는 모음이었기 때문에 ㅏ, ㅓ에 ㅣ를 붙인 모양입니다. 점 모음 ·는 지금 쓰지 않습니다. 그 글자가 나타내던 소리가 우리말에서 없어졌기 때문입니다.
글자를 모아 한 음절로 씁니다
알파벳은 보통 글자를 한 줄로 늘어놓습니다. 한글도 자음 글자와 모음 글자가 따로 있지만, 음절마다 한 덩어리로 모아 씁니다. 「꿀벌」을 ㄲㅜㄹㅂㅓㄹ로 적지 않고 두 덩어리로 적는 것과 같습니다.
한 덩어리에는 초성, 중성, 종성의 세 자리가 있습니다. 어디에 놓일지는 모음이 정합니다. ㅏ처럼 세로로 선 모음이면 초성이 왼쪽에, ㅗ처럼 가로로 누운 모음이면 위에, ㅘ처럼 둘을 합친 모음이면 왼쪽 위 모서리에 들어갑니다. 종성은 늘 아래에 놓입니다. 음절 조합 장면에서는 세 자리가 세 가지 색 점선으로 표시되고, 고를 때마다 덩어리가 다시 그려집니다.
숫자로 확인하기
오늘날 맞춤법은 초성 글자 19개, 중성 글자 21개, 받침 글자 27개를 씁니다. 받침은 홑받침 16개와 ㄺ 같은 겹받침 11개입니다. 받침이 없는 경우까지 치면 마지막 자리의 선택지는 28가지입니다.
유니코드 표준은 가능한 음절을 모두 글자 하나씩으로 정해 두고 정해진 순서로 늘어놓았습니다. 그래서 어떤 음절이든 번호를 계산할 수 있습니다.
번호 = 0xAC00 + (초성 × 21 + 중성) × 28 + 종성
「한」은 초성 ㅎ이 18번, 중성 ㅏ가 0번, 종성 ㄴ이 4번입니다. 그래서 44032 + (18 × 21 + 0) × 28 + 4 = 54620이고, 16진수로 U+D55C입니다. 같은 식으로 전체 개수도 나옵니다. 19 × 21 × 28 = 11,172개입니다. 판은 여러분이 만든 음절마다 이 계산을 보여 주고, 구석의 안내 창에는 컴퓨터가 그 번호에서 찾은 글자가 나옵니다.
획순과, 판이 획을 확인하는 방법
한글은 위에서 아래로, 왼쪽에서 오른쪽으로 한 획씩 씁니다. 판의 획순도 이 원칙을 따릅니다. ㄹ은 위쪽 꺾임, 가운데 가로획, 아래쪽 꺾임 순서이고, 「한」은 초성, 중성, 종성 순서로 씁니다. 몇몇 글자는 교재마다 조금 다르게 가르칩니다(ㅈ을 두 획으로도, 세 획으로도 가르칩니다). 그러니 이 판의 획순은 널리 쓰는 방식 가운데 하나로 보시면 됩니다.
판 위에 획을 그으면, 그 획과 판이 기대하는 획을 각각 길이를 따라 고르게 32개 점으로 다시 나눕니다. 그리고 짝이 되는 점 사이 거리의 평균을 구합니다. 평균이 쓰는 칸 너비의 7.5 %(음절 전체를 쓸 때는 6 %)보다 작으면 맞은 획입니다. 한쪽을 거꾸로 뒤집었을 때만 맞으면 방향을 반대로 그은 것이고, 지금 차례의 획보다 뒤에 올 획과 더 잘 맞으면 순서를 건너뛴 것입니다. ㅇ처럼 동그라미인 획은 시작점을 모두 바꿔 가며 비교하므로, 시작 자리가 틀린 것과 방향이 틀린 것을 구별합니다. 틀린 획은 빨갛게 나타났다 사라지고, 안내 창이 어느 경우인지 알려 줍니다.
그리스 문자와 키릴 문자
마지막 장면은 그리스 대문자 12자와 같은 소리를 적는 키릴 문자를 나란히 놓았습니다. 유니코드 표준은 키릴 문자를 9세기에 그리스 문자를 바탕으로 만든 문자라고 설명합니다. 지금도 모양이 같은 짝이 많습니다. Α와 А, Γ와 Г, Π와 П, Φ와 Ф가 그렇습니다. 달라진 짝도 있습니다. Δ는 발이 달린 Д가 되었고, Λ는 Л이 되었으며, Σ의 소리는 С로 적습니다. Ρ와 Р처럼 모양은 같아도 라틴 문자로 옮기면 r이 되는 짝도 있습니다.
짝마다 그리스 문자를 파란색으로 먼저, 이어서 키릴 문자를 빨간색으로 한 획씩 그립니다. 그리스 대문자와 키릴 대문자에는 공식으로 정한 획순이 따로 없어서, 여기서는 오른손으로 쓰기 자연스러운 순서를 썼습니다.
모형에서 단순하게 한 것
머리 단면은 촬영 자료가 아니라 그림입니다. 혀는 조절점 열세 개로 된 윤곽이 정해진 다섯 모양 사이를 오가지만, 실제 혀는 끊임없이 모양이 바뀝니다. 여린입천장은 경첩 하나로 움직이고, 목구멍에는 후두덮개와 성대만 그렸습니다.
글자와 발음 기관의 대응은 1446년의 설명이지 측정 결과가 아닙니다. ㄱ을 두고 해례본은 「혀뿌리」라고 했고, 오늘날의 설명은 대개 혓등이 여린입천장에 닿는다고 하며, 모형은 뒤의 모습을 보여 줍니다. 국립국어원 누리집에 실린 글에서도 ㅁ, ㅂ, ㅍ의 관계처럼 가획만으로는 설명하기 어려운 경우가 있다고 짚습니다. 판의 글자는 획을 따라가기 쉽도록 굵기가 일정한 단순한 모양으로 그렸습니다. 손글씨나 붓글씨의 굽고 가늘어지는 획은 담지 않았습니다.
짧은 역사
세종은 1443년 겨울에 정음 28자를 만들었습니다. 『훈민정음』 해례본은 1446년 음력 9월에 목판으로 찍은 책 한 권입니다. 모두 33장으로, 세종이 직접 쓴 서문과 글자의 소리를 밝힌 예의 4장, 그리고 정인지를 비롯한 집현전 학자 여덟 명이 쓴 해례 29장으로 되어 있습니다. 해례는 글자를 만든 원리(제자해), 초성, 중성, 종성, 글자를 합치는 법(합자해), 쓰임의 보기(용자례)로 나뉩니다.
이 책은 1940년 경상북도 안동의 한 집안에서 발견되었습니다. 1962년 12월 20일 국보로 지정되었고, 서울 성북동의 간송미술관이 소장하고 있습니다. 1997년 10월에는 유네스코 세계기록유산에 올랐습니다. 처음 28자 가운데 ·, ㆆ, ㆁ, ㅿ 네 글자는 지금 맞춤법에서 쓰지 않습니다. 그래서 오늘날 배우는 기본 자모는 24자입니다.
문자 23종을 움직이는 방식으로 나누기
「문자 23종」을 누르면 판이 비교 카드로 바뀝니다. 목록은 기원전 3200년 무렵 우루크에서 점토에 눌러 쓴 쐐기문자부터 1829년 파리에서 나온 점자까지 이어집니다. 카드마다 문자의 유형, 쓰는 방향, 출처가 밝힌 가장 이른 연대, 지금도 쓰는지, 알려진 경우 어느 문자에서 나왔는지, 견본 글자, 「물」을 적은 모양, 짧은 설명이 나옵니다. 조작 칸의 「문자」 막대로 한 칸씩 넘길 수 있고, 무대 아래 도감에는 23종이 모두 거르기 단추와 함께 있습니다.
색 배지는 유형입니다. 기호 하나가 무엇을 적는지 알려 주므로 가장 먼저 볼 곳입니다.
알파벳은 자음과 모음을 따로 글자로 적습니다. 목록에서는 그리스 문자가 처음으로 이렇게 했고, 라틴, 키릴, 아르메니아, 조지아 문자와 룬이 같은 생각을 따랐습니다. 아브자드는 자음만 적고 모음은 대부분 뺍니다. 페니키아 문자는 자음 글자 22개가 전부였습니다. 히브리 문자와 아랍 문자도 지금까지 이 방식입니다. 읽는 사람이 언어를 알기 때문에 모음을 채워 읽고, 어린이 책이나 경전, 낯선 낱말에는 점이나 작은 부호를 더하기도 합니다. 유니코드 표준은 히브리 문자의 모음 점을 예배용 글이 아니면 보통 생략한다고 적었습니다.
아부기다는 자음 글자마다 모음이 하나 들어 있고 부호로 그 모음을 바꿉니다. 데바나가리의 क는 ka이고, ि를 붙이면 कि, ki가 되며, 비라마를 붙이면 모음이 없어집니다. 타이, 티베트, 벵골 문자도 같은 브라흐미 계열이라 큰 틀이 같습니다. 에티오피아 문자는 모양이 다른 아부기다입니다. 자음마다 모음에 따라 일곱 모양이 있고, 기본 글자에 짧은 획이나 고리를 붙여 만듭니다. ለ, ሉ, ሊ, ላ가 le, lu, li, la입니다.
음절 문자는 음절 하나에 기호 하나이고, 기호 안에서 자음과 모음이 갈라지지 않습니다. 이 전시에서는 일본 가나와 세쿼이아의 체로키 문자가 여기에 듭니다. 체로키 문자는 지금 85자이고, 처음에는 86자였습니다. 가나는 두 벌 모두 기본 글자가 46자입니다.
표어 문자는 낱말 전체를 적는 기호와 소리를 적는 기호를 섞어 씁니다. 쐐기문자, 이집트 상형문자, 한자, 마야 문자가 여기에 들고, 그래서 기호가 수백에서 수천 개에 이릅니다. 한자 가운데 많은 글자가 뜻을 알려 주는 부분과 소리를 알려 주는 부분으로 이루어져 있습니다.
한글에는 자질 문자라는 이름을 따로 붙였습니다. 기본 자음 다섯은 혀나 입술의 자리를, 더한 획은 더 센 소리를, 점과 가로줄과 세로줄은 모음을 나타내서 글자 모양에 소리를 내는 방법이 적혀 있기 때문입니다. 점자에는 점자 부호라고 적었습니다. 두 줄에 놓인 볼록한 점 여섯 개가 64가지 무늬를 만들고, 유니코드 표준은 무늬마다 정해진 뜻이 없고 언어마다 따로 정한다고 설명합니다.
줄은 어느 쪽으로 나아갈까요
판에 나온 문자 대부분은 왼쪽에서 오른쪽으로 쓰지만 모두 그렇지는 않습니다. 비교 카드를 열면 판 앞에 주황색 화살표가 서고, 파란 구슬이 쓰는 방향으로 화살표를 따라 움직입니다.
페니키아, 히브리, 아랍 문자는 오른쪽에서 왼쪽으로 씁니다. 아랍 문자는 하나가 더 있습니다. 인쇄할 때도 이어 쓰기 때문에 대부분의 글자가 다음 글자와 붙고, 같은 글자도 낱말의 처음, 가운데, 끝에서 모양이 다릅니다. 이집트 상형문자는 어느 쪽으로도 쓸 수 있었고, 사람과 새와 동물 기호는 줄이 시작하는 쪽을 바라봅니다. 읽는 사람이 기호와 얼굴을 마주하는 셈입니다. 판에서는 상형문자 줄을 오른쪽에서 왼쪽으로 쓰므로 기호를 좌우로 뒤집어 그렸습니다. 「방향 바꿔 보기」를 켜면 줄이 왼쪽에서 오른쪽으로 바뀌고, 기호도 새 시작점을 보도록 돌아섭니다.
몽골 문자는 위에서 아래로 쓰고, 다음 줄은 오른쪽에 이어집니다. 드문 방식입니다. 한국, 중국, 일본의 세로쓰기 책은 줄이 오른쪽에서 왼쪽으로 넘어갑니다. 세로쓰기 문자에서는 화살표가 아래를 가리키고, 견본 아래의 짧은 화살표가 줄이 넘어가는 쪽을 보여 줍니다. 판은 몽골 문자를 조판 프로그램과 같은 방법으로 그립니다. 줄을 가로로 짠 다음 시계 방향으로 4분의 1 바퀴 돌립니다. 몽골 문자 글꼴이 그렇게 쓰도록 만들어져 있습니다.
「방향 바꿔 보기」는 모든 문자에서 작동합니다. 실제로 그렇게 쓰는 방법이 아니라 무엇이 달라지는지 보여 주려고 넣었습니다. 라틴 문자를 오른쪽에서 왼쪽으로 늘어놓으면 읽을 수는 있어도 낱말이 모두 어색해 보입니다. 아랍 문자를 한 글자씩 반대로 놓으면 이음이 끊어지는데, 아랍 글씨의 모양이 글자 자체보다 글자 사이의 이음에 얼마나 많이 들어 있는지 알 수 있습니다.
같은 낱말을 22개 문자로
「한 단어」는 「물」을 뜻하는 낱말을 22개 문자로 나란히 놓습니다. 문자마다 지금 주로 적는 언어나 쓰이던 때의 언어로 적고, 아래에 라틴 문자 표기를 달았습니다. 영어 water 옆에 러시아어 вода, 힌디어 पानी, 타이어 น้ำ, 암하라어 ውሃ, 체로키어 ᎠᎹ가 있습니다. 쐐기문자는 수메르어 a를 기호 하나 𒀀로 적습니다. 상형문자는 물결 세 줄입니다. 점자는 water를 다섯 칸으로 적습니다.
스물두 칸을 함께 보면 유형이 한눈에 보입니다. 표어 문자는 낱말 하나에 기호 한두 개면 됩니다. 알파벳은 글자 네다섯 개가 필요합니다. 아브자드는 페니키아 문자와 히브리 문자에서 모음 없이 m-y-m만 적습니다. 마야 문자는 유니코드에 아직 기호가 없어 이 화면에서 뺐습니다. 마야 카드에는 대신 유니코드에 들어 있는 마야 숫자를 그렸습니다. 점 하나가 1, 막대 하나가 5, 조개 모양이 0입니다.
내 이름을 다른 문자로 쓰기
「이름 쓰기」는 이름을 13개 문자로 바꿔 씁니다. 라틴 문자나 한글로 쓰면 됩니다. 먼저 이름을 짧은 소리 목록으로 바꿉니다. 한글은 국어의 로마자 표기법 글자 표로 한 글자씩 옮기므로 마주환은 majuhwan이 됩니다. 라틴 문자는 sh, ch, th, ph, ng, ee, oo 같은 두 글자 묶음 표로 읽습니다. 그다음 문자마다 그 소리를 자기 방식으로 적습니다.
적는 방식에서 문자의 유형이 드러납니다. 가타카나와 에티오피아 문자는 자음과 모음을 한 기호에 담아야 하므로 Maria가 가타카나로 マリア, 에티오피아 문자로 ማሪያ가 됩니다. 데바나가리는 자음에 모음 기호를 붙여 मारिया로 쓰고, 모음이 없는 자음에는 비라마를 붙입니다. 아랍 문자와 히브리 문자는 자음을 적고 모음 자리에 긴 모음 글자를 씁니다. 외국 이름을 적을 때 흔히 쓰는 방식이고, 히브리 문자는 낱말 끝에서 ם, ן, ף, ץ 같은 끝 글자로 바꿉니다. 그리스 문자와 키릴 문자는 거의 한 글자씩 대응합니다. 점자는 라틴 글자 앞에 대문자 부호를 붙여 적습니다.
판에는 이것이 규칙 표로 바꾼 결과이고 실제 표기와 다를 수 있다고 분명히 적어 두었습니다. 소리 바뀜 규칙 없이 로마자로 옮긴 한국 이름은 어색할 수 있고, 표기법 표대로라면 Kim은 Gim이 됩니다. 나라마다 굳어진 이름 표기는 어떤 표로도 맞힐 수 없습니다. 이 도구는 문자가 움직이는 방식을 보여 주려는 것이지 여권에 쓸 이름을 만들려는 것이 아닙니다.
한자에서 나온 가나, 시대에 따라 바뀐 한자
「가나의 뿌리」는 가나 15자를 각각이 나온 한자 옆에 놓습니다. 히라가나는 글자 전체를 흘려 쓴 모양에서 나왔습니다. あ는 安에서, い는 以에서, か는 加에서 왔습니다. 가타카나는 글자의 한 부분을 땄습니다. ア는 阿의 왼쪽, イ는 伊의 왼쪽이고, エ는 江에서 물 수 변을 뗀 모양입니다. 짝은 모리오카의 가나 기원 사전을 인용한 간사이 대학 논문의 표를 따랐습니다. 아래 과제 하나가 이 가운데 여섯 쌍을 맞추는 것입니다.
「한자 변천」은 여섯 글자를 세 단계로 그립니다. 기원전 1300~1050년 무렵 상나라 갑골의 모양, 소전 모양, 해서입니다. 日은 안에 표시가 있는 동그라미에서 가운데 줄이 있는 네모가 됩니다. 水는 양쪽에 물방울이 튀는 구불구불한 강에서 시작합니다. 해서에서는 강이 갈고리가 있는 가운데 획이 되고, 물방울이 양옆의 획이 되었습니다. 갑골문과 소전 그림은 이 모형을 위해 단순하게 다시 그린 것이라 어느 한 유물이 아니라 모양의 생각을 보여 줍니다.
붓으로 쓰는 획순
획순 화면에 둘째 줄이 생겼습니다. 한자 여덟 자와 가나 열두 자입니다. 획순이 움직이는 동안 붓이 펜 끝을 따라가고, 「획순 되감기」로 획을 손으로 앞뒤로 넘겨 볼 수 있습니다. 水는 네 획입니다. 갈고리가 있는 가운데 획, 왼쪽 부분, 오른쪽 위의 짧은 획, 오른쪽 아래로 길게 뻗는 획 순서입니다. 木은 가로획, 세로획, 그리고 양쪽으로 내리긋는 두 획 순서입니다. 山은 가운데가 먼저이고, 왼쪽과 밑을 한 획으로 그은 다음 오른쪽입니다.
이 글자들도 판 위에서 따라 쓸 수 있습니다. 한글과 같은 비교 방법으로 획마다 자리, 방향, 순서가 맞는지 확인합니다. 「붓」을 끄면 보통 펜 굵기로 볼 수 있습니다.
무엇에 글자를 썼을까요
「쓰는 재료」를 누르면 머리 단면 자리에 물건 다섯 가지가 하나씩 나오고, 판이 각각을 설명합니다.
가장 오래된 것은 점토판입니다. 쐐기문자는 우루크 같은 도시에서 빵과 맥주 배급을 적는 장부로 시작했고, 대영박물관은 3,000년 넘게 쓰였다고 설명합니다. 서기는 자른 갈대 끝을 젖은 점토에 눌렀습니다. 누를 때마다 쐐기 자국이 남아서 기호가 쐐기 묶음이 되었고, 쐐기문자에 곡선이 거의 없는 것도 그 때문입니다. 모형의 점토판에는 줄 친 일곱 줄에 쐐기 묶음이 있고 옆에 갈대가 놓여 있습니다.
파피루스 두루마리는 이집트에서 왔습니다. 파피루스 줄기를 얇게 갈라 두 겹으로 엇갈려 놓고 눌러 말린 뒤, 낱장을 이어 붙여 두루마리로 만들었습니다. 모형은 검은 먹과 붉은 먹으로 상형문자 줄을 쓴 한 장과 옆에 말린 나머지를 보여 줍니다.
죽간은 종이보다 훨씬 먼저 한자를 실었습니다. 좁은 대나무 조각에 위에서 아래로 쓰고 끈으로 나란히 엮었습니다. 칭화 대학이 가진 전국 시대(기원전 475~221년) 죽간에는 70편이 넘는 글이 있고, 그 가운데 60편 넘게가 2,000년 넘도록 사라졌던 글입니다. 세로줄이 오른쪽에서 왼쪽으로 넘어가는 옛 한자 책의 방향은 죽간 묶음에서 자연스럽게 나옵니다.
양피지 코덱스는 짐승 가죽을 접어 쪽을 만들고 등을 묶은 책입니다. 4세기에 쓴 그리스어 성경 시나이 사본이 남아 있는 가장 이른 예 가운데 하나이고, 영국도서관은 이것을 양피지 코덱스 한 점으로 목록에 올려 두었습니다. 본문은 낱말 사이를 띄우지 않은 대문자로 쓰여 있고, 모형의 쪽도 그렇게 그렸습니다.
마지막은 금속 활자입니다. 글자 하나를 금속 덩이 하나에 부어 만들고, 판에 짜 넣고, 먹을 묻혀 종이에 찍습니다. 활자 면의 글자는 모두 좌우가 뒤집혀 있어서 모형도 뒤집힌 면을 보여 줍니다. 유네스코는 『직지』가 1377년 7월 청주 흥덕사에서 금속 활자로 찍혔다고 기록하고, 하권은 프랑스 국립도서관에 있습니다.
나라가 문자를 바꿀 때
무대 아래 사건 목록에는 문자를 바꾼 일이 여럿 있습니다. 1928년 11월 1일 튀르키예는 법률 제1353호로 튀르키예어를 아랍 문자 대신 라틴 문자로 적게 했고, 11월 3일 관보에 실었습니다. 한때 아랍 문자로 쓰던 인도네시아어와 말레이어는 지금 라틴 문자를 쓰고, 아제르바이잔어는 키릴 문자에서 튀르키예식 라틴 문자로 옮겼습니다. 베트남어는 성조 부호가 많은 라틴 문자, 쯔꾸옥응으(chữ Quốc ngữ)로 씁니다. 이 표기는 선교사들의 작업에서 자랐고, 1651년 로마에서 찍은 알렉상드르 드 로드의 사전이 이 표기를 썼습니다.
문자는 그대로 두고 덜어 낸 경우도 있습니다. 일본의 2010년 상용한자표는 일상에 쓰는 한자를 2,136자로 정했고, 한글은 현대 맞춤법에서 네 글자를 빼서 오늘 배우는 기본 글자 24자가 되었습니다. 새 문자도 계속 생깁니다. 세쿼이아는 1821년 체로키 음절 문자를 완성했고, 몇 해 뒤 체로키 회의가 두 언어로 찍는 신문 「체로키 피닉스」에 이 문자를 썼습니다. 제임스 에번스는 1830년대 말 앨곤퀸 계열 언어를 위한 음절 문자를 만들었고, 지금은 이누크티투트어 사용자들이 씁니다.
모든 문자를 표준 하나에
23장의 카드에 나온 글자는 마야 문자를 빼면 모두 유니코드 문자입니다. 2025년 9월 9일에 나온 유니코드 17.0에는 159,801자가 들어 있습니다. 새로 생긴 CJK 확장 J가 한자 4,298자를 더해 유니코드의 한자는 10만 자를 넘었습니다. 한글 음절은 특별합니다. 유니코드는 11,172개 블록을 하나하나 늘어놓는 대신 식으로 다시 만들 수 있는 순서로 두었고, 음절 조합 화면이 그 식을 보여 줍니다.
모양을 바꾸는 규칙이 있는 문자는 글자 목록만으로는 부족합니다. 아랍 글자는 이어져야 하고, 데바나가리 자음은 모음 기호나 다른 자음과 합쳐져야 하며, 몽골 글자는 자리에 따라 모양이 바뀌고, 타이 모음 기호는 자음의 위, 아래, 앞, 뒤에 붙습니다. 판은 이 일을 브라우저의 글자 엔진에 맡깁니다. 대부분의 기기에 없는 드문 문자는 SIL 오픈 폰트 라이선스로 공개된 Noto 글꼴에서 여기 그리는 글자만 잘라 낸 작은 파일을 불러옵니다. 모두 합쳐 약 116 KB입니다.
직접 해 보기
조작 칸 아래에 과제가 일곱 개 있습니다. 목록에서 오른쪽에서 왼쪽으로 쓰는 문자 세 개를 고르세요. 네 문자 가운데 자음만 적는 문자를 고르는 과제도 있습니다. 음절 조합에서 「닭」을 만들어 보세요. 종성이 겹받침 ㄺ이고, 유니코드 식으로 구하면 U+B2ED입니다. 가나 여섯 자를 나온 한자와 짝지으세요. 다섯 문자 가운데 가장 오래된 것을 고르세요. 水를 획순대로 따라 쓰세요. 두 음절 이상인 이름을 쓰고 에티오피아 문자로 바뀐 모양을 읽어 보세요. 끝낸 과제는 이 기기에 표시가 남습니다.
자주 묻는 질문
ㄱ은 왜 혀 뒷부분의 모양이라고 하나요?
해례본은 ㄱ이 혀뿌리가 목구멍을 막는 모양을 본떴다고 적었습니다. 얼굴을 왼쪽으로 두고 옆에서 보면 혀가 입천장 아래를 따라 뒤로 가다가 뒤에서 아래로 꺾이는데, 이것이 ㄱ의 가로획과 세로획입니다.
ㅇ은 소리가 없나요?
음절 첫머리에서는 소리가 없습니다. 「우유」처럼 초성 자리를 채우기만 합니다. 받침으로 쓰일 때는 「강」의 끝소리처럼 콧소리가 납니다. 1446년에는 이 콧소리를 ㆁ이라는 글자로 따로 적었고, 나중에 ㅇ과 합쳐졌습니다.
한글로 쓸 수 있는 음절은 몇 개인가요?
유니코드에는 19 × 21 × 28 = 11,172개의 완성형 음절이 들어 있습니다. 대부분은 실제 낱말에 나오지 않지만, 판에서는 어느 것이든 만들어 볼 수 있습니다.
지금 쓰지 않는 네 글자는 어떻게 되었나요?
점 모음 ·는 그 글자가 적던 소리가 우리말에서 사라지면서 쓰지 않게 되었습니다. ㆆ, ㆁ, ㅿ도 지금 표준 맞춤법에는 없습니다. 오늘날 맞춤법의 기본 자모는 24자입니다.
획순은 정해져 있나요?
위에서 아래로, 왼쪽에서 오른쪽으로 쓴다는 원칙은 어느 교재나 같습니다. 몇몇 글자는 조금씩 다르게 가르치기 때문에, 판은 자기가 보여 주는 순서만 받아들이고 순서가 어긋나면 알려 줍니다.
그리스 문자와 키릴 문자는 왜 닮았나요?
키릴 문자가 9세기에 그리스 문자를 바탕으로 만들어졌기 때문에 대문자 가운데 그리스 문자 모양을 그대로 지닌 것이 많습니다. 유니코드 표준에 따르면 남아 있는 가장 오래된 키릴 문자 기록은 10세기 고대 교회 슬라브어 필사본입니다.
판은 획이 틀렸는지 어떻게 판단하나요?
여러분이 그은 획과 기대하는 획에서 각각 고르게 32개 점을 뽑아 비교합니다. 평균 거리가 칸 너비의 7.5 %보다 작으면 맞은 것으로 봅니다. 같은 비교를 거꾸로 하거나 뒤에 올 획과 해 보면, 방향을 뒤집었는지 순서를 건너뛰었는지 알 수 있습니다.
제가 조합한 음절도 따라 쓸 수 있나요?
네. 음절 조합 장면에서 글자를 만든 뒤 「이 글자 따라 쓰기」를 누르면 됩니다. 판이 초성, 중성, 종성 순서로 획순을 보여 줍니다.
가장 오래된 문자는 무엇인가요?
여기 나온 문자 가운데에서는 쐐기문자와 이집트 상형문자가 가장 오래되었고, 둘 다 기원전 3200년 무렵입니다. 판은 대영박물관을 따라 쐐기문자를 우루크의 장부에서 시작한 것으로 적었습니다. 다섯 가운데 가장 오래된 것을 고르는 과제에서는 상형문자가 보기에 없으므로 쐐기문자가 답입니다.
아브자드와 아부기다는 어떻게 다른가요?
아브자드는 자음을 적고 모음은 빼거나 덧붙이는 부호로 적습니다. 히브리 문자와 아랍 문자가 그렇습니다. 아부기다도 자음에서 출발하지만 자음마다 모음이 들어 있고 부호가 그 모음을 바꿉니다. 데바나가리 क는 ka, कि는 ki입니다. 아브자드는 글자만 보고 모음을 알 수 없고, 아부기다는 언제나 알 수 있습니다.
왜 어떤 문자는 오른쪽에서 왼쪽으로 쓰나요?
방향은 오래전에 정해져 어미 문자에서 딸 문자로 이어졌습니다. 페니키아 문자가 오른쪽에서 왼쪽으로 썼고, 히브리 문자와 아랍 문자가 그 방향을 지켰습니다. 그리스 글은 한동안 줄마다 방향을 바꿔 쓰다가 왼쪽에서 오른쪽으로 자리 잡았고, 라틴 문자와 키릴 문자가 그 방향을 물려받았습니다. 판은 문자마다 보통 쓰는 방향으로 보여 주고, 「방향 바꿔 보기」로 반대 모습을 볼 수 있습니다.
상형문자는 왜 돌아서 있나요?
사람과 동물 상형문자는 줄이 시작하는 쪽을 봅니다. 유니코드는 왼쪽에서 오른쪽으로 쓰는 줄에 맞게 왼쪽을 보는 모양으로 담고 있습니다. 판은 줄을 오른쪽에서 왼쪽으로 쓰므로 기호마다 좌우를 뒤집어 시작점을 보게 했습니다.
「물」 화면에 마야 문자는 왜 없나요?
마야 기호는 아직 유니코드에 들어가지 않아서 표준 방식으로 입력하거나 저장할 수 없습니다. 마야 숫자만 들어 있습니다. 그래서 마야 카드에는 글자 대신 숫자를 그렸습니다.
내 이름이 맞게 적힌 건가요?
정확하지는 않을 가능성이 큽니다. 이 도구는 문자마다 규칙 표로 소리를 다시 적을 뿐, 그 나라에서 굳어진 이름 표기를 알지 못합니다. 한글 이름은 소리 바뀜 규칙 없이 로마자로 옮깁니다. 결과는 각 문자가 낱말을 어떻게 짜는지 보여 주는 것이지 번역이 아닙니다.
용어
- 초성, 중성, 종성: 한글 음절 덩어리의 세 자리. 첫소리, 가운뎃소리, 끝소리입니다.
- 기본자: 발음 기관을 본뜬 자음 다섯 개와 모음 ·, ㅡ, ㅣ 세 개.
- 가획: 같은 자리에서 나는 더 센 소리를 적으려고 획을 하나 더하는 것.
- 이체자: 획을 더하지 않고 모양을 따로 만든 ㆁ, ㄹ, ㅿ.
- 여린입천장: 입천장의 뒤쪽 말랑한 부분. 내려가면 숨이 코로 나갑니다.
- 해례: 1446년 책에서 글자를 만든 원리와 쓰는 법을 풀이한 부분.
- 완성형 음절: 한글 음절 덩어리 하나를 유니코드 글자 하나로 정한 것.
- 아브자드: 자음만 적고 모음은 대부분 빼는 문자. 히브리 문자, 아랍 문자.
- 아부기다: 자음 글자마다 모음이 들어 있고 부호로 바꾸는 문자. 데바나가리, 에티오피아 문자.
- 음절 문자: 음절 하나에 기호 하나인 문자. 가나, 체로키 문자.
- 표어 문자: 낱말을 적는 기호와 소리를 적는 기호를 섞어 쓰는 문자. 쐐기문자, 한자.
- 코덱스: 두루마리와 달리 낱장을 접어 등을 묶은 책.
- 활자: 글자 하나를 덩이 하나로 만들어 판에 짜 넣고 다시 쓰는 인쇄 도구.
- 전자(轉字): 한 문자의 글자를 다른 문자의 글자로 옮겨 적는 일.
출처
- 국가유산청 국가유산포털, 「국보 훈민정음」. https://www.heritage.go.kr/heri/cul/culSelectDetail.do?ccbaCpno=1111100700000 (2026년 10월 16일 확인)
- 국가유산청, 「한국의 세계기록유산: 훈민정음 해례본」. https://www.heritage.go.kr/heri/html/HtmlPage.do?pageNo=4_4_2_1&pg=%2Funesco%2FMemHeritage%2FMemHeritage_01.jsp (2026년 10월 16일 확인)
- 국립국어원, 「알고 싶은 한글: 한글의 구성」(초성 19자, 중성 21자, 받침 27자). https://www.korean.go.kr/hangeul/principle/001.html (2026년 10월 16일 확인)
- 국립국어원, 「알고 싶은 한글: 자음」. https://www.korean.go.kr/hangeul/principle/002.html (2026년 10월 16일 확인)
- 국립국어원, 「알고 싶은 한글: 모음」. https://www.korean.go.kr/hangeul/principle/003.html (2026년 10월 16일 확인)
- 국립국어원, 「알고 싶은 한글」 강창석, 제자 원리의 한계에 관한 글(ㅁ, ㅂ, ㅍ). https://www.korean.go.kr/hangeul/short/004g.html (2026년 10월 16일 확인)
- 국립국어원 온라인가나다, 「훈민정음 창제 원리」(제자해의 ㄱ, ㆁ 풀이). https://www.korean.go.kr/front/onlineQna/onlineQnaView.do?mn_id=&pageIndex=1&qna_seq=336058 (2026년 10월 16일 확인)
- 국립국어원, 「알기 쉽게 풀어 쓴 훈민정음」(해례본 현대어역과 영어 번역). https://www.korean.go.kr/front/etcData/etcDataView.do?etc_seq=693&mn_id=46&pageIndex=3 (2026년 10월 16일 확인)
- 유니코드 컨소시엄, The Unicode Standard 16.0 3장 3.12절 Conjoining Jamo Behavior. https://www.unicode.org/versions/Unicode16.0.0/core-spec/chapter-3/ (2026년 10월 16일 확인)
- 유니코드 컨소시엄, The Unicode Standard 16.0 7장 Europe I(그리스 문자, 키릴 문자). https://www.unicode.org/versions/Unicode16.0.0/core-spec/chapter-7/ (2026년 10월 16일 확인)
- 유니코드 컨소시엄, 코드 차트 Greek and Coptic, Cyrillic. https://www.unicode.org/charts/PDF/U0370.pdf , https://www.unicode.org/charts/PDF/U0400.pdf (2026년 10월 16일 확인)
- Unicode Consortium, Unicode 17.0.0 (159,801 characters, CJK Extension J). https://www.unicode.org/versions/Unicode17.0.0/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 7, Europe-I (Latin, Greek, Cyrillic, Armenian, Georgian). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-7/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 8, Europe-II (Linear A, Runic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-8/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 9, Middle East-I (Hebrew, Arabic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-9/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 10, Middle East-II (Phoenician). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-10/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 11, Cuneiform and Hieroglyphs. https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-11/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 12, South and Central Asia-I (Devanagari, Bengali). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-12/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 13, South and Central Asia-II (Tibetan, Mongolian). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-13/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 16, Southeast Asia-I (Thai). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-16/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 18, East Asia (Han, Hiragana and Katakana, Hangul). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-18/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 19, Africa (Ethiopic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-19/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 20, Americas (Cherokee, Canadian Aboriginal Syllabics). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-20/ (2026년 10월 18일 확인)
- Unicode Standard 17.0, chapter 21, Notational Systems (Braille). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-21/ (2026년 10월 18일 확인)
- British Museum, How to write cuneiform. https://www.britishmuseum.org/blog/how-write-cuneiform (2026년 10월 18일 확인)
- The Metropolitan Museum of Art, Heilbrunn Timeline, The Origins of Writing. https://www.metmuseum.org/essays/the-origins-of-writing (2026년 10월 18일 확인)
- British Museum, Everything you ever wanted to know about the Rosetta Stone. https://www.britishmuseum.org/blog/everything-you-ever-wanted-know-about-rosetta-stone (2026년 10월 18일 확인)
- British Museum, Hieroglyphs resources. https://www.britishmuseum.org/hieroglyphs-resources (2026년 10월 18일 확인)
- Smithsonian National Museum of Asian Art with Smarthistory, Oracle Bone, Shang Dynasty (S2012.9.445). https://smarthistory.org/oracle-bone/ (2026년 10월 18일 확인)
- Israel Antiquities Authority, The Leon Levy Dead Sea Scrolls Digital Library. https://www.deadseascrolls.org.il/ (2026년 10월 18일 확인)
- UNESCO Memory of the World, Hunminjeongum Manuscript. https://www.unesco.org/en/memory-world/hunminjeongum-manuscript (2026년 10월 18일 확인)
- UNESCO Memory of the World, nomination form, Hunmin Chongum (Hangul Day set in 1946). https://media.unesco.org/sites/default/files/webform/mow001/republic_of_korea_hunmin_chongum.pdf (2026년 10월 18일 확인)
- UNESCO Memory of the World, Baegun hwasang chorok buljo jikji simche yojeol (vol. II). https://www.unesco.org/en/memory-world/baegun-hwasang-chorok-buljo-jikji-simche-yojeol-volii-second-volume-anthology-great-buddhist-priests (2026년 10월 18일 확인)
- UNESCO Memory of the World, The King Ram Khamhaeng Inscription. https://www.unesco.org/en/memory-world/king-ram-khamhaeng-inscription (2026년 10월 18일 확인)
- US National Library of Medicine, Native Voices timeline, 1821: Sequoyah's syllabary. https://www.nlm.nih.gov/nativevoices/timeline/270.html (2026년 10월 18일 확인)
- US National Park Service, Kennesaw Mountain, Cherokee Language. https://www.nps.gov/kemo/learn/historyculture/cherokeelanguage.htm (2026년 10월 18일 확인)
- New York Public Library, Cherokee syllabary developed by Sequoyah (85 characters, originally 86). https://www.nypl.org/events/exhibitions/galleries/beginnings/item/15807 (2026년 10월 18일 확인)
- American Foundation for the Blind, Louis Braille online museum, Books in Braille (1829). https://afb.org/about-afb/history/online-museums/life-and-legacy-louis-braille/braille-nvents-his-code/books (2026년 10월 18일 확인)
- Resmî Gazete (Official Gazette of Türkiye), issue 1030, 3 November 1928, Law 1353 on the Turkish letters. https://www.resmigazete.gov.tr/arsiv/1030.pdf (2026년 10월 18일 확인)
- Dinh-Hoa Nguyen, Alexandre de Rhodes' dictionary (1651), Papers in Linguistics 19 (1986). https://doi.org/10.1080/08351818609389247 (2026년 10월 18일 확인)
- Agency for Cultural Affairs, Japan, Jōyō kanji table (2,136 characters, 2010). https://www.bunka.go.jp/kokugo_nihongo/sisaku/joho/joho/kijun/naikaku/kanji/ (2026년 10월 18일 확인)
- Saxon State and University Library Dresden (SLUB), Codex Dresdensis, digital copy. https://digital.slub-dresden.de/werkansicht/dlf/2967/1 (2026년 10월 18일 확인)
- Saturno, Stuart and Beltrán, Early Maya writing at San Bartolo, Guatemala, Science 311 (2006). https://doi.org/10.1126/science.1121745 (2026년 10월 18일 확인)
- Kansai University, Wakumon 34, table of hiragana and katakana source characters (after Morioka 2006). http://www2.kansai-u.ac.jp/shkky/wakumon/no-34/03lihong.pdf (2026년 10월 18일 확인)
- British Library, Codex Sinaiticus, Add MS 43725 (parchment codex, 4th century). https://searcharchives.bl.uk/catalog/032-002169711 (2026년 10월 18일 확인)
- Tsinghua University, Tsinghua bamboo slips (Warring States, 475 to 221 BC). https://www.tsinghua.edu.cn/en/info/1245/14429.htm (2026년 10월 18일 확인)
- Noto fonts (Cuneiform, Egyptian Hieroglyphs, Phoenician, Runic, Ethiopic, Tibetan, Mongolian, Cherokee), SIL Open Font License 1.1, subsets in this exhibit. https://github.com/notofonts (2026년 10월 18일 확인)
- 이 페이지의 계산: 음절 번호는 0xAC00 + (초성 × 21 + 중성) × 28 + 종성으로, 획 비교는 획마다 32개 점으로 다시 나눠 계산했습니다.
함께 보면 좋은 전시
점자와 수기 신호, 해상 깃발 읽는 법
점자의 점 하나는 지름 1.5 mm이고, 세로 3개 가로 2개 점이 만드는 64가지 모양을 한글, 영어, 일본어, 악보 점자가 함께 씁니다.
재봉틀은 어떻게 한 땀을 만들까
재봉틀 바늘은 천을 통과하지 않습니다. 땀마다 갈고리가 윗실을 끌고 북알 둘레를 한 바퀴 돌아 나옵니다.
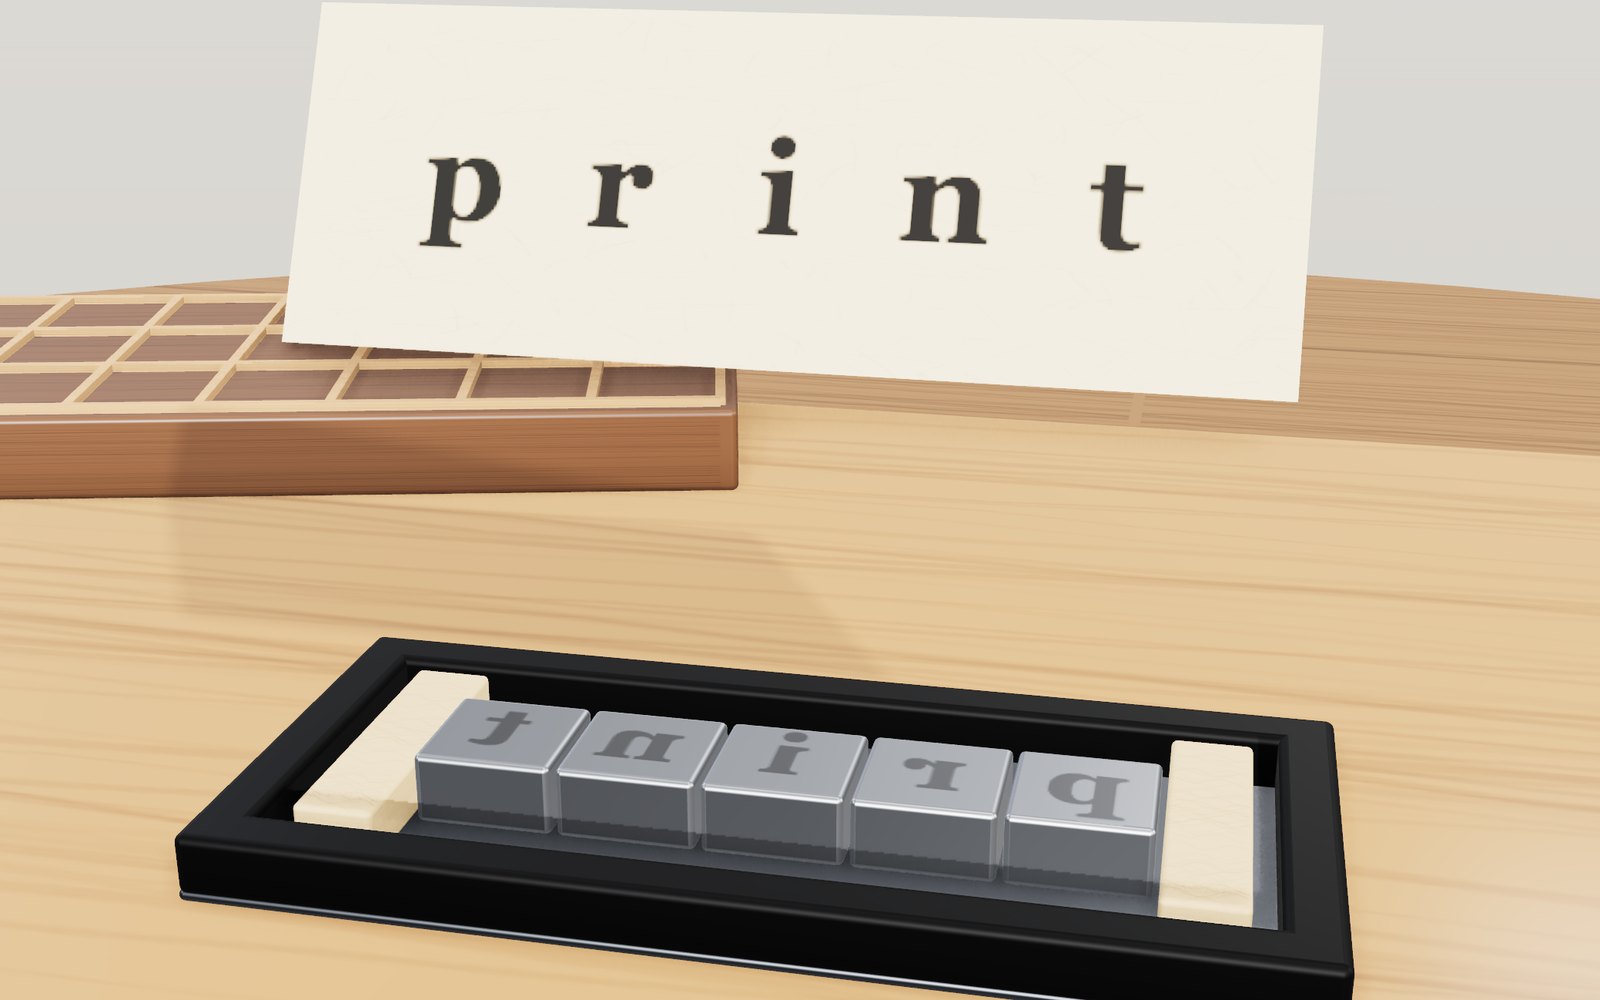
금속활자와 인쇄기
활자에는 글자가 거꾸로 새겨져 있습니다. 먹을 묻혀 종이를 누르고 뒤집으면 글자가 바로 읽힙니다.
수동 타자기 원리와 글쇠에서 종이까지의 움직임 보기
파이카 타자기에서는 글자든 띄어쓰기든 마침표든 한 번 칠 때마다 캐리지가 똑같이 2.54 mm씩 왼쪽으로 갑니다.
3D 프린터 원리와 출력 따라 하기
20 mm 정육면체를 0.2 mm 층으로 쌓으면 정확히 100층이고, 층마다 폭 0.4 mm 노즐이 선을 그립니다.
종이접기 20가지, 단계별로 따라 접기
학은 접는 동작이 30번쯤, 컵은 여섯 번이면 됩니다. 평평하게 접힌 어느 점에서나 산접기와 골접기 수는 꼭 2 차이 납니다.