図 26しくみ館
論理ゲートで足し算をするしくみ:和と桁上げ
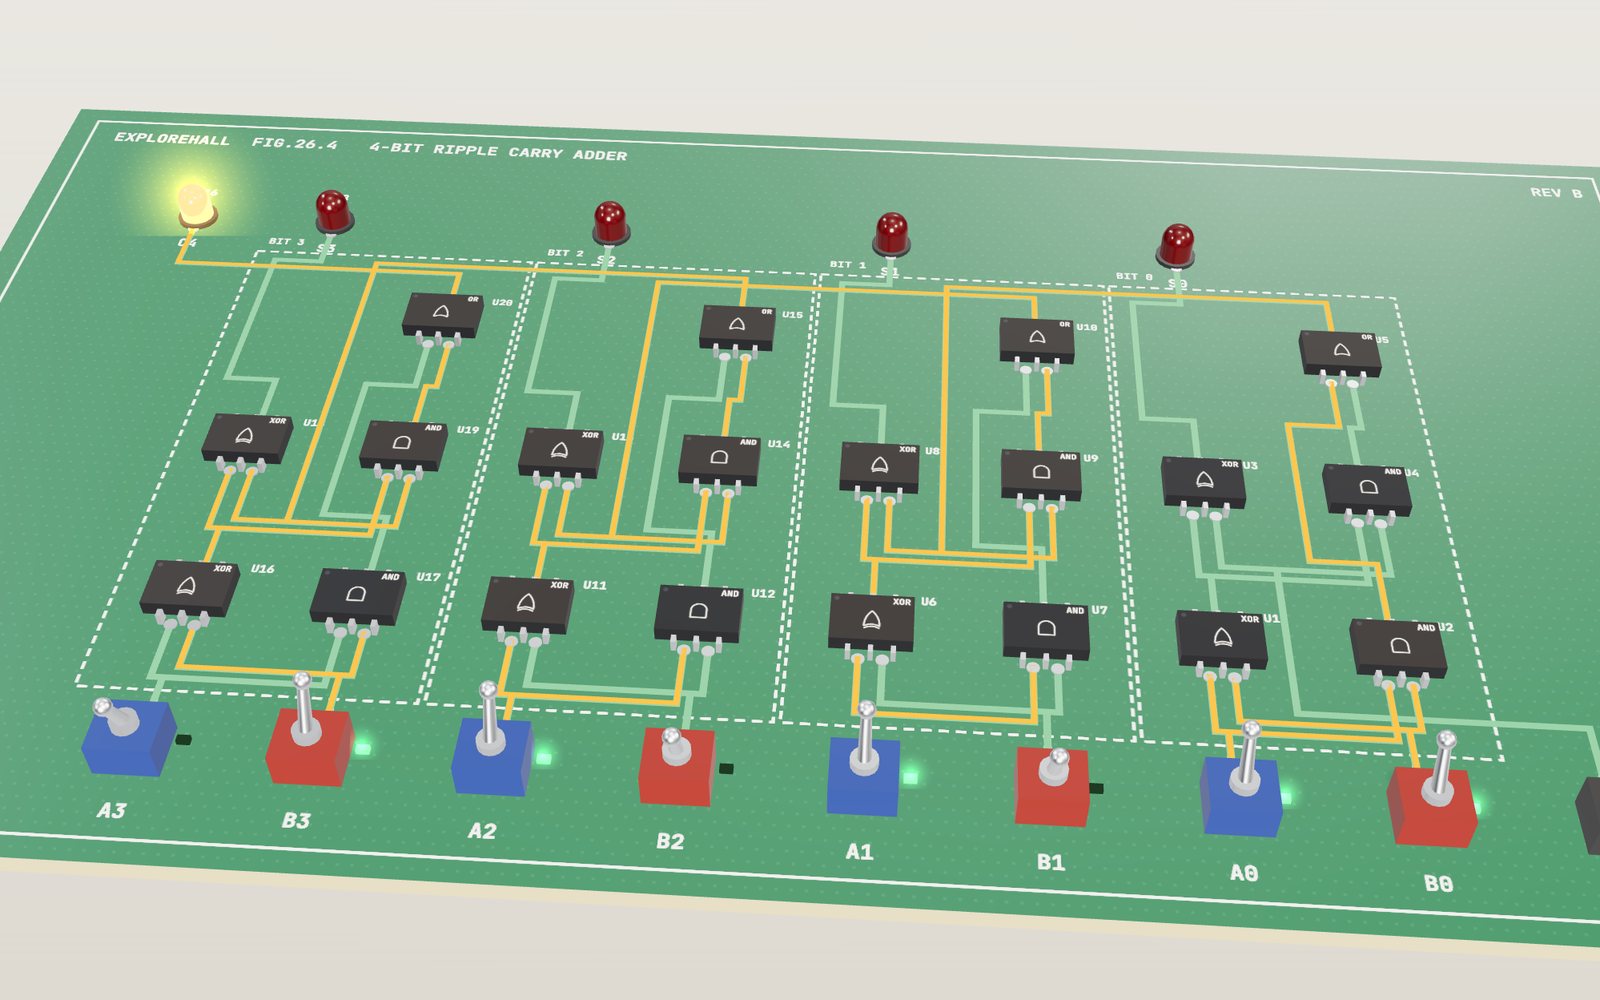
この基板で 7 と 9 を加えるにはゲート 20 個を使い、スイッチを切り替えてからゲート遅延 8 回後に最後の桁上げが届きます。
この端末では 3D を表示できません。下の解説のステップを文章で読むことができます。
1 / 20 2 つの 4 ビット数と LED 5 個手前の列は 2 つの 4 ビット数です。ここでは A が 0111 (7)、B が 1001 (9) です。光が 20 個のゲートを通り、LED が 10000、つまり 16 になるまでを追います。スイッチでビットを変えたり、「回路」スライダーで別の回路を選んだりできます。
ドラッグで回転、ホイールか二本指で拡大します。
スイッチだけで 7 と 9 を加える
論理ゲートは各桁の和のビットと桁上げのビットを作り、二進数を加えます。全加算器は前の桁からの桁上げも受け取ります。リプルキャリー加算器では、桁上げがゲートを順に通ってから最終的な答えが安定します。
紙の上なら 7 + 9 は 1 行で済みます。一の位に 6 を書き、1 を繰り上げれば答えは 16 です。しかしコンピュータには紙もなく、数という概念もありません。あるのはオンかオフになるスイッチです。スイッチの集まりは、どうやって 7 と 9 から 16 を出すのでしょうか。
上の基板では、その仕組みを段階ごとに調べ、さらに先へ進めます。最初は 4 ビットリプルキャリー加算器です。手前には 0 から 15 の数 A と B を入力する 8 個のビットスイッチ、奥には 20 個の論理ゲートと結果を示す 5 個の LED があります。スイッチを変えると 1 を伝える銅配線が光り、「ゲート遅延」スライダーで設定した速さで光がゲートを進みます。隅のパネルには入力と LED の値を二進数と十進数で同時に表示します。
「回路」スライダーでは、同じ種類のゲートチップで作った 15 種類を選べます。単一ゲート、半加算器、全加算器、4 ビットと 8 ビットのリプルキャリー加算器、桁上げ先見加算器、加減算器、比較器、マルチプレクサ、7 セグメントデコーダ、SR ラッチ、D フリップフロップ、カウンタ、小さな ALU、NAND ゲート 4 個のパズルです。いずれも同じシミュレーションで動くため、ゲート数と安定までの時間を比較できます。
2 種類の数字で書く数
十進数の各桁は、右の桁の 10 倍の値を持ちます。一、十、百という関係です。二進数も同じですが、10 倍ではなく 2 倍です。各桁の値は 1、2、4、8 なので、4 ビットで 0 (0000) から 15 (1111) まで表せます。基板では A0 が一の位、A3 が八の位で、各スイッチの下に小さく重みを印刷しています。
7 は 4 + 2 + 1 なので 0111、9 は 8 + 1 なので 1001 です。和の 16 には値が 16 の第 5 桁が必要で、答えは 10000 です。その第 5 桁が桁上げ LED の C4 です。和が 15 を超えると、この LED がなければ表示できません。
二進数が電子回路に向くのは、配線が明確に異なる 2 状態のどちらかになればよいからです。3 V と 3.5 V を見分けず、「高い」と「低い」だけを区別します。そのほうが毎秒数十億回も確実に動作させやすくなります。
スイッチとして使うトランジスタ
「回路」を「単一ゲート」にし、モデルの下で「導線」を選びます。スイッチ X はジャンパ線を通して LED を電源につなぎ、LED はスイッチどおり、1 で点灯、0 で消灯します。
次に「トランジスタ」を選びます。モデルは 3 本の脚を持つ NPN トランジスタです。中央の脚であるベースに小さな電流を流すと、残るコレクタとエミッタの間にずっと大きな電流が流れ、LED が点灯します。ベース電流を止めると LED は消えます。指ではなく電気で切り替えるスイッチになったわけです。
これは単純化であり、モデルにもそう記しています。実際のトランジスタはアナログ部品で、ある範囲ではベース電流を増やすとコレクタ電流も増えます。論理回路は完全なオフとオンだけを使い、中間状態をできるだけ速く通過するよう設計します。そのためスイッチとして扱えます。
対になるトランジスタから作るゲート
スイッチで別のスイッチを制御できれば、条件に応じた動作を作れます。現在のチップは MOSFET というトランジスタを使います。n チャネル型は入力が高いと導通し、p チャネル型は低いと導通します。CMOS 論理は両者を組み合わせ、一方の回路網で出力を電源電位へ、もう一方で接地電位へ引きます。どの入力でも導通するのは片方だけです。静止しているゲートにはほぼ電流が流れません。Fairchild の Chih-Tang Sah と Frank Wanlass が 1963 年に示したこの性質のおかげで、電話に数十億個のトランジスタを収めても溶けずに済みます。
トランジスタを数えると、ゲートごとのコストは同じではありません。
| ゲート | 働き | CMOS トランジスタ数 |
|---|---|---|
| NOT | 入力を反転 | 2 |
| NAND | 両入力が 1 のときだけ 0 | 4 |
| NOR | 両入力が 0 のときだけ 1 | 4 |
| AND | NAND の後に NOT | 6 |
| OR | NOR の後に NOT | 6 |
| XOR | 入力が異なると 1 | ここで使う基本構成では 12 |
最初に習う AND のほうが NAND より部品を多く使います。CMOS では n チャネル回路網が出力を低くするため、反転型のゲートが自然な構成です。n チャネル型 2 個を直列にすると、両入力が 1 のときだけ出力を下げる NAND になり、並列なら NOR になります。AND にはさらにインバータが必要です。「チップごとのトランジスタ数」をオンにすると各チップに数を表示し、「単一ゲート」では 7 種類と導線を順に調べられます。
NAND には別の性質もあります。NAND だけで NOT (両入力をつなぐ)、AND (NAND と NOT)、OR (両入力を先に反転) を含むあらゆる論理を作れます。最後の回路はこの性質を使うパズルです。操作欄の下で NAND ゲート 4 個の入力を選び、正しく配線すると 4 行すべてで出力が XOR と一致します。
半加算器:和は XOR、桁上げは AND
XOR の真理値表を見ます。二進数では 0 + 0 = 0、0 + 1 = 1、1 + 0 = 1、1 + 1 = 10 です。最後はこの桁が 0、次の桁への桁上げが 1 です。各答えの右端は XOR の列と一致します。桁上げが 1 になるのは最終行だけで、これは AND です。
同じ 2 ビットを XOR と AND に入力すれば加算できます。この組合せが半加算器です。「半加算器」の基板では単独で置かれ、4 ビット加算器では各ビットの最初のブロックになります。A と B がともに 1 なら、XOR は和 0、AND は桁上げ 1 を出します。
全加算器:3 ビットを受けて 2 ビットを出す
一の位なら半加算器で足りますが、それより上の桁には A のビット、B のビット、右から来る桁上げの 3 つがあります。全加算器は半加算器 2 個と OR で加えます。基板では各ビットに次の名前を使います。
- p = A xor B、g = A and B (最初の半加算器)
- S = p xor C、t = p and C (2 個目の半加算器が入力桁上げ C を加算)
- 出力桁上げ = g or t
OR に 2 つの 1 が同時に入ることはありません。A と B がともに 1 なら p は 0 で、t は 1 になれません。OR は、その桁が桁上げを生成した場合 (g) と、受け取った桁上げを伝えた場合 (t) をまとめるだけです。全加算器の真理値表は 8 行ですべてを網羅し、最大の 1 + 1 + 1 = 3 は桁上げ 1、和 1 になります。
1 ビットあたり 5 ゲートを 4 ビット分使うので、4 ビット加算器は 20 ゲートです。各全加算器の出力桁上げを左隣の入力桁上げにつなぐのは、筆算で 1 を繰り上げる操作と同じです。この鎖がリプルキャリーという名前の理由です。動作中は隅の真理値表で各ビットが使う行を示すため、ビット 0 が 1 1 0 にあり、ビット 3 が 0 1 1 で待つ様子が見えます。
桁上げが遅い理由
ゲートは瞬時には応答しません。入力が変わってから出力が変わるまでの短い時間をゲート遅延、または伝播遅延と呼びます。モデルでは全ゲートを正確に 1 単位とし、スライダーでその単位を 0.05 から 2.4 秒へ引き伸ばして観察できます。
0 + 0 の状態から 7 + 9 を入力すると、次のようになります。
| ゲート遅延 | 変化 |
|---|---|
| 1 | 最初の段の XOR と AND が新しい入力に反応します。ビット 0 (1 + 1) が g = 1 を作ります。 |
| 2 | ビット 1 への桁上げがオンになります。ビット 1、2、3 の和は、まだ 1 です。 |
| 3 から 4 | ビット 1 が桁上げを加え、和が 0 に戻り、出力桁上げがオンになります。 |
| 5 から 6 | ビット 2 で同じことが起きます。 |
| 7 から 8 | ビット 3 が 0 になり C4 が点灯します。LED は 10000、つまり 16 を示します。 |
桁上げを伝えるには各ビットでゲート遅延 2 回が必要です。t を作る AND に 1 回、出力桁上げを作る OR に 1 回です。4 ビットを通る最後の桁上げは遅延 8 回後に届きます。4 ビット基板の最悪値は 9 回で、n = 4 ビットに対する 2n + 1 と一致します。「各チップの遅延」をオンにすると最後に出力が変わった時点を表示し、桁上げの経路に沿って 2、4、6、8 と増えます。
この 8 回の間、LED には誤った答えも現れます。遅延 6 回の時点では 01000、つまり 8 と表示されることがあります。故障ではなく、桁上げが届く前の和を示しています。実回路にもグリッチと呼ぶ一時的な誤出力があり、プロセッサは最も遅い経路を待つ一定時間が過ぎてから加算器を読みます。この待ち時間はクロック速度を決める要因のひとつです。「タイミング図」では安定前に上下する出力波形として同じ現象を確認できます。
8 ビット基板では時間の負担が明確です。同じ全加算器 8 個、計 40 ゲートで、255 + 1 の桁上げは全ビットを通り、遅延 16 回後に安定します。4 ビットの 15 + 1 の 2 倍です。同じ作りの 64 ビット加算器なら最悪で 129 回必要です。1 回ずつ見るには「遅延ごとに進行」をオンにし、モデルの下の「次の遅延」を押します。
桁上げを先に計算する
高速加算器は桁上げの連鎖を待ちません。全加算器の各桁は g = A and B が 1 なら桁上げを生成し、p = A xor B が 1 なら受け取った桁上げを伝播します。この 2 信号は全桁で同時にゲート遅延 1 回後に準備できます。それを使うと各桁上げを展開できます。
- C1 = g0 + p0 C0
- C2 = g1 + p1 g0 + p1 p0 C0
- C3 = g2 + p2 g1 + p2 p1 g0 + p2 p1 p0 C0
- C4 = g3 + p3 g2 + p3 p2 g1 + p3 p2 p1 g0 + p3 p2 p1 p0 C0
C2 は、ビット 1 が桁上げを生成するか、ビット 0 が生成したものをビット 1 が伝えるか、ビット 1 と 0 がともに入力桁上げを伝えると、ビット 2 に桁上げが入るという意味です。各式は AND の列と OR で作れるので、桁上げは遅延 3 回、和はその 1 回後に届きます。「4 ビット桁上げ先見加算器」は 26 ゲートで実現します。15 + 1 はリプル方式の 8 回に対して 4 回で安定し、パネルの表には各ビットの P、G、桁上げを表示します。
代償は AND の規模です。C4 でもすでに 5 入力 AND と 5 入力 OR が必要で、ビットを増やすほど項も増えます。そのため大きな加算器では、4 ビットの小さな先見ブロックと、ブロック間の第 2 段の先見を組み合わせます。IBM の Gerald Rosenberger は 1957 年に二進桁上げ先見加算器を特許出願しました。Charles Babbage も 1 世紀前に同じ問題に気づき、解析機関用に桁上げを予測する機構を設計しました。現在は高速桁上げ付き 4 ビット加算器が市販部品で、Texas Instruments は SN74LS283 を今も掲載しています。
同じ加算器で引く
コンピュータには別の減算器が必須ではありません。負数の一般的な表現である 2 の補数では、−B は「B の全ビットを反転して 1 を加える」と表せます。つまり A − B は A + (not B) + 1 です。
「加減算器」は B の前に各ビット 1 個の XOR を加えます。SUB がオフなら B をそのまま通し、オンなら反転します。同じ SUB 線が入力桁上げにも入り、余分な 1 を加えます。5 − 7 では B = 0111 が 1000 になり、0101 + 1000 + 1 = 1110 を計算します。1110 は符号付き 4 ビット数なら −2、符号なしなら 14 です。後者も 5 − 7 + 16 = 14 という意味で正しい値です。同じビットでも読み方で意味が変わり、パネルは両方を示します。
符号付き 4 ビット数の範囲は −8 から 7 なので、収まらない答えもあります。緑の V LED は最上位ビットへの入力桁上げと出力桁上げの XOR で、両者が異なると点灯します。SUB がオフの 7 + 1 では 0111 + 0001 = 1000 が −8 と読まれるため点灯します。先頭の XOR 列に遅延 1 回、最後の V ゲートにもう 1 回必要で、最悪値は 11 回です。
2 つの数を比較する
回路はどうやって 9 が 5 より大きいと判断するのでしょうか。書いた数字と同じく、異なる最上位桁を見ます。「比較器」ではビットごとに判断します。A > B は A が 1 で B が 0、つまり B にインバータを付けた AND です。A < B は逆で、どちらも真でなければ等しく、両者の NOR で求めます。
次に上位を優先します。ビット 3 が大きいと示すか、ビット 3 が等しくビット 2 が大きいと示すか、ビット 3 と 2 が等しくビット 1 が大きいと示すか、と続けます。4 つの AND 項を OR でまとめる形は桁上げ先見と同じです。1001 と 0101 は最上位の相違がビット 3 で A が 1 なので、A > B がゲート遅延 4 回後に点灯します。最悪は 5 回、ゲートは 29 個です。TI SN74LS85 は同じ機能を 1 パッケージに収め、複数チップで長い数を比べる入力も備えます。
入力を選び、数字を描く
さらに 2 つの回路も、AND を OR にまとめる形を使います。
マルチプレクサは選ぶ回路です。4 対 1 の基板は D0 から D3 のデータ入力と選択ビット 2 個を持ちます。各データを、選択ビットまたはその反転とともに 3 入力 AND に入れると、どの設定でも通る AND は 1 個だけとなり、OR がそのデータを Y に渡します。7 ゲート、遅延 3 回です。プロセッサのレジスタファイルからテレビの入力切替まで、複数信号のどれかを 1 本に通す場所で使います。
デコーダは描く回路です。7 セグメント表示器には a から g の棒状 LED があり、数字ごとに点灯箇所が異なります。1 は b と c、8 は 7 本すべてです。各セグメントについて点灯する数字を列挙し、AND 項を OR で結ぶ積和に簡単化できます。このデコーダはその方法で作り、インバータ 4 個、共用 AND 項 28 個、OR 7 個の計 39 ゲートで、スイッチから点灯まで遅延 3 回です。0 から 9 のほか十六進数の A から F も描きます。TI SN74LS47 は 0 から 9 用の市販部品です。
記憶する回路
ここまでの回路は忘れます。入力を変えると出力も変わり、過去には依存しません。記憶にはループが必要です。
SR ラッチは NOR ゲート 2 個が互いの出力を受けます。S と R がともに 0 なら Q = 1 または Q = 0 の直前の状態を、電源がある間保ちます。S を 1 にすると Q は 1、R を 1 にすると 0 になります。Q をセットして S を戻しても Q は 1 のままです。8 トランジスタで作る 1 ビットの記憶です。
ラッチには禁止入力があります。S と R がともに 1 なら両出力は 0 で、同時に解除すると両ゲートが競合します。両ゲートの遅延が等しいこのモデルでは安定せず、遅延ごとに出力がそろって反転し、パネルにも表示します。実物は完全に対称ではないため片方が勝ちますが、どちらになるか、いつ決まるかは予測できません。これを準安定状態と呼び、通常動作で起きないよう設計します。
D フリップフロップは、ある瞬間だけデータを取り込むことでこの問題を避けます。基板は 7474 チップの 6 NAND 構成です。クロックが低い間も高い間も D が何度変わっても Q は変わりません。CLK が 0 から 1 になる瞬間だけ D を取り込み、次の立ち上がりまで保持します。D と CLK をランダムに変える 49,152 ステップでは、毎回この規則に従いました。
クロックパルスを数える
フリップフロップ 4 個を並べ、現在値に 1 を加える小さな回路を付け、結果を D 入力へ戻します。クロックパルスごとに次の数を読み込みます。「4 ビットカウンタ」は 30 ゲート、内訳はフリップフロップの NAND 24 個と加算用 6 個でこれを実現します。ビット 0 は常に反転し、ビット 1 はビット 0 が 1 のとき、ビット 2 は 1 と 0 がともに 1 のとき、ビット 3 は下の 3 ビットがすべて 1 のとき反転します。
「クロックパルス」を押すと順序が見えます。立ち上がりが 4 個へ同時に届き、遅延 2 回後に出力が変わり、次のパルスより十分早く加算回路が次の数を用意します。全ビットが同じエッジで変わるため同期カウンタと呼び、TI SN74LS161A も同類です。1111 の次は 0000 に戻ります。40 パルスの試験では 0 から 15 を数えて繰り返し、取りこぼしはありませんでした。
同じ部品で作る ALU
プロセッサの算術論理演算装置は、実際に計算する回路です。「4 ビット ALU」は 59 ゲートでその考えを示します。各ビットで A + B、A − B、A AND B、A OR B を並列に求め、2 つの演算ビットで出力するものを選びます。選択はマルチプレクサと同じ AND と OR の構成です。演算 00 は加算、01 は加減算器の XOR 列を使う減算、10 は AND、11 は OR です。
4 結果は常にすべて計算し、演算ビットは表示するものだけを選びます。実際の ALU も同様で、ここでの最長経路は加算器単独より長いゲート遅延 13 回です。12 AND 10 では 1100 と 1010 に共通するのはビット 3 だけなので、答えは 1000、つまり 8 です。
ゲート遅延はどれくらいか
モデルは遅延の回数を数えますが、実物ではナノ秒で測ります。Texas Instruments の NAND ゲートは、SN74HC00 が 4.5 V で代表値 9 ns、旧型 SN74LS00 が 9 から 10 ns、SN74AC00 が 5 V で約 5 ns です。リレーは約 100 万倍遅く、Omron G5V-1 の仕様書は動作時間を最大 5 ms としています。
これを最長経路に掛けます。4 ビットリプルキャリー加算器は遅延 9 回なので、74HC00 相当なら約 81 ns で安定し、毎秒 1200 万回の加算が可能です。リレーなら同じ回路に 45 ms かかります。操作欄の下では、選択中の回路でこの計算を行います。現代のプロセッサが 64 ビット数を毎秒数十億回加えられるのは、ゲートが数千倍速く、桁上げ先見を使うからであり、論理が違うからではありません。
各回路を確かめる
基板の全回路は、可能な全入力について真理値表と照合しました。4 ビット加算器は 512 通りすべてで A + B + C0 を出し、262,144 通りの入力変化すべてで遅延 9 回以内に正解へ安定しました。8 ビットは 131,072 通りの和と 400,000 回のランダムな変化を確認しました。先見加算器は 4 回、加減算器は 11 回、比較器は 5 回、マルチプレクサとデコーダは 3 回以内です。ALU は 1,048,576 通りすべての変化で 13 回以内でした。記憶回路は、ラッチのセット・保持・リセット、フリップフロップのランダムなクロックとデータ、カウンタの 40 パルスを試しました。
基板で次の例を確かめられます。
- リプル加算器の 15 + 1:4 つの桁上げが伝わり、遅延 8 回後に 10000 になります。
- 先見加算器の 15 + 1:同じ答えが遅延 4 回後に出ます。
- 5 + 2:どの桁にも桁上げがなく、遅延 2 回後に 0111 (7) が出ます。
- 加減算器の 5 − 7:1110、つまり −2 です。
実物のチップとの違い
- 全ゲートの遅延は同じです。実物では XOR は NAND より遅く、多数の入力を駆動するゲートは単一入力を駆動するものより遅く、温度と電源電圧でも変わります。
- 導線の通過時間は長さに関係なくゲート遅延の 0.85 倍です。実基板の短い配線はほぼ瞬時ですが、チップ内の長い配線はゲートより遅いこともあります。
- 信号は完全な 0 か 1 です。実際の電圧には立ち上がりと立ち下がりの時間があり、この基板には雑音、発熱、ファンアウトの制限がありません。
- 1 チップに 1 ゲートです。実際の論理チップは NAND 4 個やインバータ 6 個を 1 パッケージに収め、ここで省いた電源端子、デカップリングコンデンサ、プルアップ抵抗も必要です。
- 実験台のトランジスタは単一のバイポーラスイッチとして描き、チップ上のトランジスタ数は CMOS のものです。
Boole の代数からリレー加算器へ
1854 年に George Boole は The Laws of Thought を出版しました。論理命題を掛け算や足し算に似た演算で組み合わせ、1 と 0 が特別な役割を持つ代数です。機械ではなく推論の本でした。
回路につながったのは 1937 年です。MIT の修士課程の Claude Shannon は A Symbolic Analysis of Relay and Switching Circuits を書き、直列と並列のスイッチが Boole の代数と同じ規則に従うため、試行錯誤でなく代数で回路を設計・簡単化できると示しました。最終章の例には二進加算器もあります。論文の内容は 1938 年の Transactions of the American Institute of Electrical Engineers に掲載され、Alfred Noble Prize を受賞しました。
同じ年、Bell Labs の George Stibitz はリレーで実演用加算器を作り、組み立てた台所のテーブルにちなみ Model K と名づけました。10 年後の 1947 年 12 月、William Shockley が率いる Bell Labs のグループで John Bardeen と Walter Brattain が初めて動作するトランジスタを作りました。3 人は「半導体の研究およびトランジスタ効果の発見」により 1956 年のノーベル物理学賞を共同受賞しました。
リレーから数十億のトランジスタへ
初期の大型計算機は、利用できるスイッチを使いました。Konrad Zuse の 1941 年の Z3 はリレー 2,300 個、1944 年に完成した Harvard Mark 1 は 3,500 個を使い、長さ 50 フィートのカム軸で同期しました。Bletchley Park で 1944 年初めから動いた Colossus は真空管 2,500 本で切り替えました。University of Pennsylvania が 1946 年 2 月に発表した ENIAC は 18,000 本を必要とし、30 × 50 フィート、約 9 × 15 メートルの部屋を占めました。MIT の 1956 年の TX-0 は、トランジスタ製の最初の汎用プログラム可能計算機で、各トランジスタを真空管のように交換できる差込み式の「ボトル」に収めました。
次にゲートはシリコン上へ移りました。Fairchild は 1961 年、トランジスタ 4 個と抵抗 5 個のフリップフロップを、初期のプレーナ集積回路のひとつとして発表しました。Texas Instruments の TTL 論理チップ 7400 シリーズは 1966 年から安いプラスチック製パッケージで売られ、まもなく論理回路市場の半分以上を占めました。NAND 4 個入りの SN7400 など多くの部品は今も販売されています。1968 年の Apollo 7 で初飛行した Apollo Guidance Computer は、主に 3 入力 NOR 2 個を収める同一型チップを、各機に数千個使いました。
Gordon Moore は 1965 年、チップの部品数が毎年倍増すると予測し、後に 2 年ごとへ修正しました。1971 年の Intel 4004 はトランジスタ 2,300 個で 4 ビットプロセッサ全体を 1 チップに収めました。Computer History Museum の年表では 2,250 個です。2020 年の Apple M1 は約 700 万倍の 160 億個、2024 年の NVIDIA Blackwell GPU は 2080 億個を搭載します。内部の演算は今も、この基板と同じ加算器、マルチプレクサ、フリップフロップが担います。
よくある質問
コンピュータが十進数でなく二進数を使うのはなぜですか?
配線は高低の 2 状態、トランジスタは完全なオンとオフだけを区別すれば済みます。10 状態より 2 状態のほうが確実に見分けられ、Boole の代数が 2 状態の回路を正確に記述します。
半加算器と全加算器はどう違いますか?
半加算器は 2 ビットを加え、和と桁上げを出します。全加算器は 3 ビット、つまり 2 つの数字と入力桁上げを加えます。半加算器 2 個と OR ゲートで作ります。
リプルキャリー加算器と呼ぶのはなぜですか?
各全加算器は右隣からの桁上げを待ってから、自分の出力桁上げが確定します。桁上げが水面の波紋のようにビットを順に伝わるためです。
4 ビットリプルキャリー加算器にはどれくらい時間がかかりますか?
このモデルでは各ビットが桁上げにゲート遅延 2 回を加えます。最悪は 9 回で、7 + 9 は 8 回後に安定します。1 回が 9 ns の 74HC00 型ゲートなら約 81 ns です。
LED が一瞬違う数を示すのはなぜですか?
各ゲートには伝播遅延があり、桁上げはビットを順に進むためです。届くまでは古い桁上げを使った和が出ます。この一時的な誤出力をグリッチと呼びます。クロックで動く回路は最も遅い経路が終わってから読み取ります。
和が 15 を超えるとどうなりますか?
和の 4 ビットは 0 から 15 しか示せません。第 5 LED の C4 は最上位からの桁上げで、値は 16 です。これを含めると 15 + 15 + 1 = 31 まで表示できます。
同じ回路で引き算もできますか?
はい。B の全ビットを反転し、入力桁上げをオンにすると、2 の補数で A − B を求めます。「加減算器」は各ビットに XOR を 1 個使い、プロセッサも同じ方法で加算器を両用します。
NAND が万能ゲートと呼ばれるのはなぜですか?
NAND だけであらゆる論理関数を作れます。両入力を結べば NOT、NAND の後に NOT を置けば AND、反転した 2 入力を NAND に入れれば OR です。NOR も同じ性質を持ちます。基板のパズルでは NAND 4 個で XOR を作ります。
AND が NAND より多くのトランジスタを使うのはなぜですか?
CMOS で接地側へ引くのは n チャネル型です。2 個を直列にすると、両入力が 1 のときだけ出力を下げ、4 トランジスタで反転型の NAND になります。AND はさらにインバータが必要で 6 個です。
桁上げ先見加算器は常に優れていますか?
高速ですが、ビット数が増えるとゲート数も入力数も増えます。4 ビット先見基板は 26 個、リプル基板は 20 個です。大きな加算器では、小さな先見ブロックを第 2 段の先見で結びます。
ラッチとフリップフロップはどう違いますか?
ラッチは入力が変わると応答し、SR ラッチは直ちにセットとリセットを行います。フリップフロップはクロックのエッジでだけ変わるため、回路全体がパルスごとに足並みをそろえて進みます。
基板の 4 ビット加算器にはトランジスタがいくつ必要ですか?
CMOS として数えると 168 個です。XOR 8 個に各 12、AND 8 個に各 6、OR 4 個に各 6 です。ALU は 418 個です。Intel 4004 はプロセッサ全体に約 2,300 個を使いました。
用語
- ビット:0 または 1 の二進数字です。
- 論理ゲート:AND、OR、NOT、NAND、NOR、XOR など、入力の決まった関数を出力する回路です。
- 真理値表:すべての入力の組合せと対応する出力の一覧です。
- トランジスタ:小さな電流や電圧で大きな電流を制御する半導体部品で、論理回路ではスイッチにします。
- CMOS:n チャネルと p チャネルの MOSFET を組み合わせ、静止中はほぼ電流を流さない論理回路です。
- 半加算器:XOR と AND で 2 ビットを加えます。
- 全加算器:半加算器 2 個と OR で 2 ビットと桁上げを加えます。
- 桁上げ:ある桁の和が 2 以上のとき、次の桁に渡す 1 です。
- ゲート遅延:入力が変わってから出力が変わるまでの時間で、伝播遅延とも呼びます。
- リプルキャリー加算器:各桁の桁上げを次へ入力する全加算器の鎖です。
- 桁上げ先見:生成信号 g と伝播信号 p から桁上げを並列に求める高速な方法です。
- 2 の補数:負数の一般的な表現で、−B は B の全ビットを反転して 1 を加えます。
- マルチプレクサ:選択ビットに応じて複数入力のひとつを出力に通す回路です。
- デコーダ:二進数を、数字の 7 セグメントなど各出力の信号に変える回路です。
- ラッチ:電源がある間 1 ビットを保つゲートのループです。
- フリップフロップ:クロックのエッジでだけ入力を取り込む記憶回路です。
- ALU:算術論理演算装置で、加算、減算、ビットの論理演算を行うプロセッサの部分です。
参考資料
- University of Victoria, CENG 465, Ripple Carry and Carry Lookahead Adders (half and full adders, ripple carry, carry lookahead, gate delays). https://www.ece.uvic.ca/~fayez/courses/ceng465/lab_465/project1/adders.pdf (checked 17 October 2026)
- Google Patents, US 2,966,305, Gerald B. Rosenberger (IBM), Simultaneous carry adder (filed 16 August 1957). https://patents.google.com/patent/US2966305A/en (checked 17 October 2026)
- Doron Swade, Charles Babbage and Computational Method, The Rutherford Journal 3 (successive carriage in the Difference Engines, anticipating carriage in the Analytical Engine). https://www.rutherfordjournal.org/article030106.html (checked 17 October 2026)
- MIT Libraries, DSpace@MIT, Claude E. Shannon, A symbolic analysis of relay and switching circuits (S.M. thesis). https://dspace.mit.edu/handle/1721.1/11173 (checked 17 October 2026)
- Golomb, Berlekamp, Cover and others, Claude Elwood Shannon (1916–2001), Notices of the AMS 49(1), 2002 (the 1938 paper and the Alfred Noble Prize), via Stanford ISL. https://isl.stanford.edu/~cover/papers/paper117.pdf (checked 17 October 2026)
- Computer History Museum, Timeline of Computer History: 1937 (Stibitz's "Model K" relay adder, built on his kitchen table). https://www.computerhistory.org/timeline/1937/ (checked 18 October 2026)
- Project Gutenberg, George Boole, An Investigation of the Laws of Thought (1854), full text. https://www.gutenberg.org/ebooks/15114 (checked 16 October 2026)
- Computer History Museum, 1947: Invention of the Point-Contact Transistor (Bardeen and Brattain, December 1947). https://www.computerhistory.org/siliconengine/invention-of-the-point-contact-transistor/ (checked 17 October 2026)
- The Nobel Prize, The Nobel Prize in Physics 1956. https://www.nobelprize.org/prizes/physics/1956/summary/ (checked 16 October 2026)
- University of Texas at Austin, J. A. Abraham, VLSI Design lecture 3, Implementing Logic in CMOS (CMOS NAND, NOR, compound gates, transmission-gate multiplexer). https://www.cerc.utexas.edu/~jaa/vlsi/lectures/3-2.pdf (checked 18 October 2026)
- Cornell University, ECE 4740, lecture 14, Pass Transistors and Transmission Gates (AND as 6 transistors in static CMOS, XOR cost). https://cpb-us-w2.wpmucdn.com/sites.coecis.cornell.edu/dist/4/81/files/2019/06/4740_lecture14-pass-transistors.pdf (checked 18 October 2026)
- Computer History Museum, The Silicon Engine, 1963: Complementary MOS Circuit Configuration is Invented. https://www.computerhistory.org/siliconengine/complementary-mos-circuit-configuration-is-invented/ (checked 18 October 2026)
- Computer History Museum, The Silicon Engine, 1963: Standard Logic IC Families Introduced (TI 7400 series from 1966). https://www.computerhistory.org/siliconengine/standard-logic-ic-families-introduced/ (checked 18 October 2026)
- Computer History Museum, The Silicon Engine, 1960: First Planar Integrated Circuit is Fabricated (Micrologic flip-flop, March 1961). https://www.computerhistory.org/siliconengine/first-planar-integrated-circuit-is-fabricated/ (checked 18 October 2026)
- Computer History Museum, The Silicon Engine, 1965: "Moore's Law" Predicts the Future of Integrated Circuits. https://www.computerhistory.org/siliconengine/moores-law-predicts-the-future-of-integrated-circuits/ (checked 18 October 2026)
- Computer History Museum, The Silicon Engine, 1971: Microprocessor Integrates CPU Function onto a Single Chip (4004, 2,300 transistors). https://www.computerhistory.org/siliconengine/microprocessor-integrates-cpu-function-onto-a-single-chip/ (checked 18 October 2026)
- Computer History Museum, Timeline of Computer History: 1941 (Z3, 2,300 relays), 1944 (Harvard Mark 1, 3,500 relays), 1956 (TX-0), 1968 (Apollo Guidance Computer), 1971 (4004, 2,250 transistors). https://www.computerhistory.org/timeline/1944/ (checked 18 October 2026)
- The National Museum of Computing, Colossus (2,500 valves, working in February 1944). https://www.tnmoc.org/colossus (checked 18 October 2026)
- Penn Engineering, University of Pennsylvania, ENIAC (18,000 vacuum tubes, announced February 1946). https://www.seas.upenn.edu/about/history-heritage/eniac/ (checked 18 October 2026)
- Smithsonian National Air and Space Museum, Integrated Circuit, Dual 3 Input, Apollo Guidance Computer. https://airandspace.si.edu/collection-objects/integrated-circuit-dual-3-input-apollo-guidance-computer/nasm_A20170004000 (checked 18 October 2026)
- Texas Instruments, SN74HC00 data sheet (typical propagation delay 9 ns at 4.5 V). https://www.ti.com/lit/ds/symlink/sn74hc00.pdf (checked 18 October 2026)
- Texas Instruments, SN74LS00 data sheet (typical delays 9 ns and 10 ns). https://www.ti.com/lit/ds/symlink/sn74ls00.pdf (checked 18 October 2026)
- Texas Instruments, SN74AC00 data sheet (typical delays 6 ns and 4.5 ns at 5 V). https://www.ti.com/lit/ds/symlink/sn74ac00.pdf (checked 18 October 2026)
- Texas Instruments, product pages for SN74LS283, SN74LS85, SN74LS47, SN74LS161A and SN7400. https://www.ti.com/product/SN74LS283 (checked 18 October 2026)
- Omron, G5V-1 relay data sheet (operate time 5 ms maximum). https://omronfs.omron.com/en_US/ecb/products/pdf/en-g5v_1.pdf (checked 18 October 2026)
- Apple Newsroom, Apple unleashes M1 (16 billion transistors, 10 November 2020). https://www.apple.com/newsroom/2020/11/apple-unleashes-m1/ (checked 18 October 2026)
- NVIDIA Newsroom, NVIDIA Blackwell Platform Arrives to Power a New Era of Computing (208 billion transistors, 18 March 2024). https://nvidianews.nvidia.com/news/nvidia-blackwell-platform-arrives-to-power-a-new-era-of-computing (checked 18 October 2026)
- Calculations on this page: the gate models were worked through for every input of every combinational circuit and every change between two inputs (sampled for the 8-bit adder). Worst settle times: 4-bit ripple 9, 8-bit ripple 17 by path length (16 seen), lookahead 4, adder-subtractor 11, comparator 5, multiplexer 3, decoder 3, ALU 13 gate delays.
ほかの展示
トランジスタのしくみ
160 億個のトランジスタを載せたチップは、その一つひとつを、下のシリコンに触れることのないゲートにかける数ボルトでオンとオフに切り替えています。
自転車のギアのしくみ:坂を登りやすい組み合わせ
50 × 11 ではペダル 1 回転で 9.57 m、34 × 32 では 2.24 m 進みます。
エニグマ暗号機を分解して試すローターシミュレーター
ローター I-II-III、AAA に合わせたエニグマで A を 5 回押すと、ランプは B、D、Z、G、O と灯ります。
黒電話のしくみ:ダイヤルのパルスと交換機
回転ダイヤルは各数字を、毎秒 10 回の短い回線電流の断続として送ります。0 を回すと 10 パルスが出ます。
地図投影法のしくみ:大きく見えるグリーンランド
メルカトル図法ではグリーンランドがアフリカより大きく見えますが、実際はアフリカが約 14 倍の大きさです。
折り鶴の折り方
折り鶴は切り込みのない正方形 1 枚から折られ、2 枚の翼と首と尾は正方形の四つの角です。