FIG. 102Sentidos
Código QR: como funciona a leitura
Cubra 30 % de um código QR com a mão e um celular ainda o lê. Cubra um canto e a leitura deixa de funcionar.
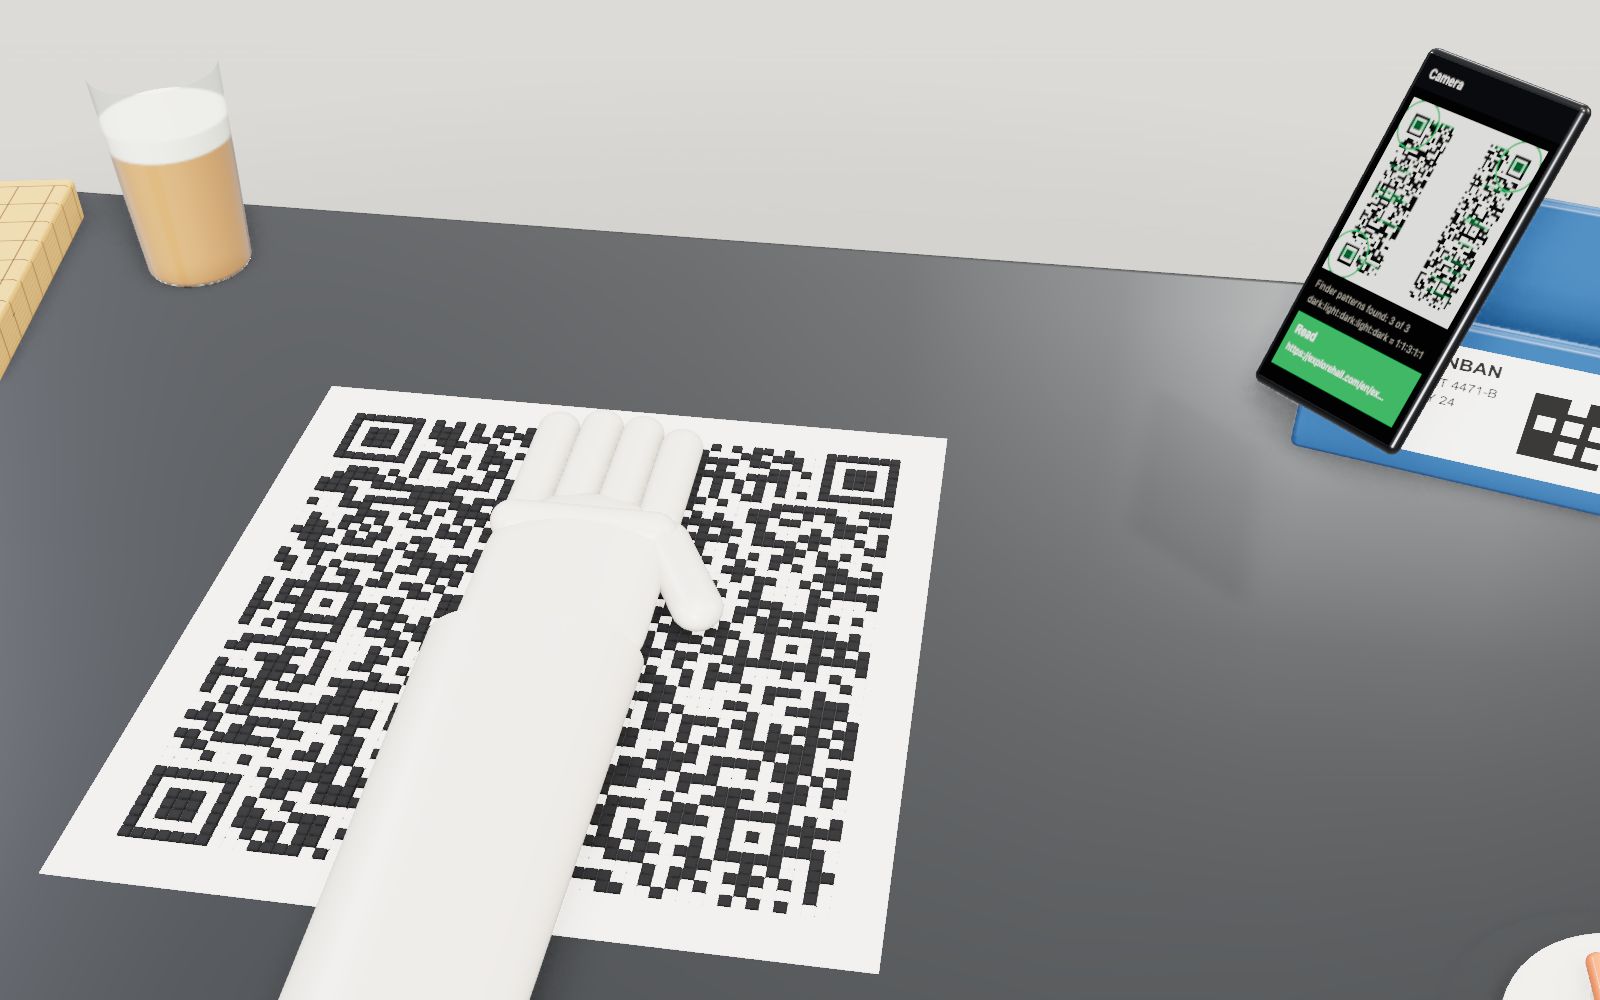
Este dispositivo não consegue mostrar o modelo 3D. Abaixo, você pode ler as etapas do guia em texto.
1 / 20 30 % sob uma mãoEste é seu texto como um código QR no nível H, versão 9: 53 x 53 módulos. Uma mão de manequim desliza sobre ele. Observe o painel e o celular à direita: o código continua legível enquanto a mão cobre cerca de 30 % dos módulos.
Arraste para girar. Use a rolagem ou o gesto de pinça para ampliar.
Um código que você pode cobrir com a mão
Aponte um celular para um código QR e ele faz a leitura em um instante, mesmo que um adesivo tenha descolado, um canto esteja amassado ou um polegar esteja na frente. Tente fazer o mesmo com o código de barras de uma caixa de cereal e o caixa apita para você. A diferença não está na câmera. Um código QR carrega palavras-código adicionais que permitem ao leitor reconstruir o que não consegue enxergar, além de três marcas que permitem ao leitor encontrá-lo em qualquer ângulo antes mesmo de começar.
A cena começa com o seu próprio texto, ou o endereço desta página, transformado em um código QR no nível H, versão 9: um quadrado de 53 por 53 módulos sobre uma mesa da galeria. Uma mão de manequim desliza sobre ele a partir da borda e para ao cobrir 16 das 53 colunas. São 848 dos 2809 módulos, 30,2 % do símbolo. O painel continua indicando Leitura possível, e o celular à direita continua encontrando o código e exibindo o seu texto. Cada um dos 8 blocos de correção de erros do símbolo está então no seu limite: 12 palavras-código incorretas em cada um, e 12 é o máximo que um bloco desse tamanho consegue corrigir. Aumente a cobertura em mais uma coluna, para 32,1 %, e a leitura deixa de funcionar.
Depois, rasgue um canto. O triângulo rasgado representa apenas 3,2 % do símbolo, muito menos do que a mão cobria, mas nada pode ser lido. O restante desta página explica por que essas duas coisas acontecem, com os números usados na cena. Eles vêm das regras da ISO/IEC 18004, a norma internacional do código QR, e do que a DENSO WAVE, empresa que o desenvolveu em 1994, publicou sobre o seu projeto.
O símbolo na mesa não é uma figura de um código QR. Ele é codificado na página a partir do texto da caixa, módulo por módulo, com a mesma aritmética Reed-Solomon que um driver de impressora usaria, e é lido de volta por um decodificador que segue as etapas de referência da norma. Você pode salvar o símbolo sem danos como uma imagem e lê-lo com o seu próprio celular. O codificador foi verificado com dois leitores independentes e com um segundo codificador: em 160 combinações de versão e nível, as matrizes eram idênticas módulo por módulo.
Como usar a cena
Digite na caixa na parte inferior da cena e o símbolo será reconstruído enquanto você digita. O painel no canto superior esquerdo mostra primeiro o resultado (Leitura possível, ou Leitura impossível com o motivo), depois a versão e o tamanho, o nível de correção de erros, a máscara e seus pontos de penalidade, o modo e o número de bits de que seu texto precisa, as palavras-código, quanto está coberto e quantas palavras-código estão agora incorretas. As pequenas barras abaixo são os blocos de correção de erros: cada uma vai se enchendo conforme suas palavras-código incorretas se aproximam do que pode corrigir e fica vermelha quando ultrapassa esse limite.
A tela do celular à direita mostra o que uma câmera faria com a imagem: uma linha vermelha percorre a imagem de cima para baixo, marcas verdes mostram todas as linhas em que as faixas correspondem a 1:1:3:1:1, e círculos mostram se os três padrões de posição foram encontrados. Abaixo, o celular exibe o texto ou o motivo pelo qual desistiu.
Nos controles, Versão define a menor versão a usar (o codificador aumenta o símbolo se o seu texto não couber), Correção de erros escolhe L, M, Q ou H, e Máscara força uma das oito máscaras em vez daquela com menos pontos de penalidade. Largura da cobertura e Posição da cobertura movem a mão, e Cobertura a substitui por uma tira de papel ou fita preta. Elevação por função ergue os módulos em camadas conforme o que fazem; Cor por função os colore sem elevá-los. Ordem de colocação desenha o caminho seguido pelos bits e colore as palavras-código por bloco. Mostrar máscara tinge os módulos que a máscara inverte. Rotação gira o símbolo sobre a mesa. Comparação coloca um código de barras EAN-13 ou um símbolo Micro QR no cavalete, ou pendura as versões 1 a 40 na parede. Zona de silêncio remove a margem branca.
Pintura permite arrastar sobre o símbolo com tinta, corretivo, um furo ou uma borracha. Rasgar um canto e Manchas de óleo são maneiras rápidas de danificá-lo. Hora atual preenche o símbolo com a hora atual e o redesenha a cada segundo. Clique em qualquer módulo para ver o que ele é: sua linha e coluna, sua função e, nos módulos de dados, o bloco, a palavra-código e o bit a que pertence. Alguns módulos e alguns objetos na mesa abrem cartões ocultos.
Abaixo dos controles você encontrará seu texto escrito como bits, as palavras-código de cada bloco em hexadecimal, uma tabela dos quatro níveis para a versão atual, as oito máscaras lado a lado, uma tabela de versões, 12 tarefas, 46 casos, cartões que começam com Na verdade, uma coleção e links para exposições relacionadas.
Quadrados em três cantos
A parte mais difícil de ler um código bidimensional não são os dados. É encontrar o código em uma imagem de câmera cheia de outras coisas, descobrir sua orientação e o tamanho de cada módulo. Um código de barras é fácil de encontrar: um laser ou uma linha de pixels só precisa atravessá-lo. Um código matricial precisa ser encontrado em duas dimensões.
A resposta da DENSO WAVE foram os três quadrados nos cantos, que a norma chama de padrões de posição. Cada um tem 7 por 7 módulos: um anel escuro, um anel claro e um centro escuro de 3 por 3. Uma linha que passa pelo centro em qualquer direção atravessa escuro, claro, escuro, claro, escuro com larguras de 1, 1, 3, 1 e 1. A proporção não muda quando o código é girado, ampliado ou reduzido, ou visto em ângulo, de modo que um leitor pode percorrer linhas de pixels, guardar os últimos cinco trechos escuros e claros e testar se correspondem.
Por que essa proporção? Segundo a DENSO WAVE, os desenvolvedores reduziram imagens e caracteres impressos em folhetos, revistas e caixas de papelão a padrões de preto e branco e contaram quais proporções apareciam. A que aparecia menos em material impresso era 1:1:3:1:1. Em uma entrevista de 2024 publicada pela DENSO, Masahiro Hara, que liderou o trabalho, disse que encontrá-la levou cerca de seis meses, fotografando jornais e revistas página por página e deixando um software de medição funcionando durante a noite.
O celular na cena faz exatamente isso com os pixels que vê. Ele percorre cada linha, conta os trechos e aceita cinco trechos cujas larguras estejam a até meio módulo de 1:1:3:1:1. Para cada correspondência, verifica a mesma proporção na vertical, passando pelo meio do trecho central. As correspondências que concordam se tornam centros candidatos. Ele então precisa de três deles, e aquele que forma um ângulo reto entre os outros dois é o canto superior esquerdo. Esse ângulo também informa ao leitor quanto o código está girado. Gire o símbolo com Rotação e observe os círculos acompanharem os cantos.
Uma região dos dados pode formar as mesmas faixas por acaso. Os leitores rejeitam essas ocorrências isoladas porque a grade que elas implicam não se ajusta. A cena só considera um padrão de posição encontrado quando a detecção cai sobre o verdadeiro.
Separadores, margem e a mesa escura
O teste 1:1:3:1:1 só funciona se o anel escuro externo tiver claro dos dois lados. Dentro do símbolo, isso é garantido pelos separadores: um anel claro com um módulo de largura ao redor de cada padrão de posição. Fora do símbolo, esse é o papel da zona de silêncio, uma margem clara que a norma exige que tenha quatro módulos de largura em todos os lados.
Na cena, o símbolo é impresso em uma folha de papel cuja margem tem exatamente quatro módulos. A mesa embaixo é de ardósia escura. Desative Zona de silêncio e a margem do papel desaparece, de modo que o anel externo de cada padrão de posição se une diretamente à mesa escura. Uma linha que passa por um padrão de posição agora é lida como um longo trecho escuro seguido de claro, escuro, claro e escuro: o primeiro trecho tem muitos módulos de largura e a proporção falha. O celular não encontra nenhum padrão de posição e o painel indica Leitura impossível, falta um padrão de posição. Nada nos dados mudou.
As orientações de impressão da DENSO WAVE incluem a margem no tamanho da etiqueta. Seu exemplo usa 50 caracteres alfanuméricos no nível M, o que exige a versão 3 (29 módulos; a versão 2 no nível M comporta apenas 38). Com uma impressora de 400 dpi e 4 pontos por módulo, o módulo tem 0,254 mm, o símbolo tem 7,366 mm e, com 8 módulos de margem, a área da etiqueta é um quadrado de 9,398 mm de lado. Códigos Micro QR, que têm apenas um padrão de posição, precisam de uma margem de dois módulos em vez de quatro.
Uma régua impressa no código
A linha 6 e a coluna 6 de todo código QR vão de um padrão de posição ao seguinte, alternando escuro e claro. São os padrões de sincronização. Eles informam ao leitor onde fica cada coluna e linha, o que importa quando a impressão foi esticada, o papel está ondulado ou a câmera vê o código em ângulo. Um leitor que conhece as posições dos padrões de posição pode estimar o tamanho do módulo, mas contar os módulos alternados fornece o número exato de módulos entre esses padrões.
O número de módulos também informa a versão. A versão V tem 17 + 4V módulos de lado, portanto a versão 1 tem 21 por 21 e a versão 40 tem 177 por 177. Na cena, o símbolo sempre ocupa os mesmos 30 cm de papel, de modo que o módulo diminui conforme a versão aumenta: 5,7 mm na versão 9, 1,7 mm na versão 40.
Como os padrões de sincronização ficam dentro do símbolo, também ocupam módulos que poderiam guardar dados. Na versão 1, os padrões funcionais (padrões de posição, separadores, sincronização, informações de formato e o módulo escuro) deixam 208 módulos para palavras-código: 26 palavras-código de 8 bits.
Alvos para papel curvado
O primeiro código QR de 1994, hoje chamado Modelo 1, não tinha outras referências. A DENSO WAVE diz que o Modelo 1 chegava à versão 14, com 73 por 73 módulos e 1167 dígitos. O Modelo 2, que é o código QR usado hoje, acrescentou padrões de alinhamento para que códigos impressos em superfícies curvas, ou vistos em ângulo acentuado, ainda pudessem ser lidos. Também estendeu a faixa até a versão 40 e 7089 dígitos.
Um padrão de alinhamento é um pequeno alvo de 5 por 5: um anel escuro, um anel claro e um módulo central escuro. A versão 1 não tem nenhum. As versões 2 a 6 têm um, perto do canto inferior direito, as versões 7 a 13 têm seis, e a quantidade cresce até 46 nas versões 35 a 40. Seus centros ficam em uma grade de linhas e colunas listadas na norma; as mesmas posições são usadas para linhas e colunas, e os três lugares em que se sobreporiam a um padrão de posição são omitidos. A cena calcula essas posições a partir da versão: na versão 9, são 6, 26 e 46, o que dá 3 x 3 = 9 lugares menos 3 = 6 padrões.
Um leitor que encontrou os três padrões de posição conhece três cantos do código. O quarto canto não é marcado, por isso o leitor o estima e depois procura o padrão de alinhamento mais próximo para corrigir a estimativa. Com esse quarto ponto, pode desfazer a perspectiva de uma foto inclinada. Em um símbolo grande, vários padrões de alinhamento permitem ao leitor acompanhar uma página abaulada.
Quinze bits que dizem como ler o restante
Antes que um leitor possa ler qualquer dado, precisa saber duas coisas: o nível de correção de erros e qual das oito máscaras foi aplicada. Elas ocupam 5 bits: 2 para o nível (L é 01, M é 00, Q é 11 e H é 10) e 3 para o número da máscara.
Esses 5 bits são protegidos com muito mais força que os dados. São estendidos a 15 bits com um código BCH, os códigos corretores de erros encontrados por Bose e Ray-Chaudhuri em 1960 e, independentemente, por Hocquenghem em 1959. Os 10 bits de verificação são o resto da divisão dos 5 bits, deslocados 10 posições à esquerda, pelo polinômio x^10 + x^8 + x^5 + x^4 + x^2 + x + 1. Quaisquer duas das 32 palavras-código possíveis de 15 bits diferem em pelo menos 7 bits, de modo que um leitor pode escolher a mais próxima mesmo quando 3 bits estão incorretos.
Os 15 bits recebem então uma operação XOR com o padrão fixo 101010000010010. Sem isso, o nível M com a máscara 0 seria composto de 15 módulos claros, e o leitor não conseguiria distinguir as informações de formato do papel em branco.
As informações de formato são escritas duas vezes: uma ao redor do padrão de posição superior esquerdo e outra dividida entre os outros dois, com 8 bits ao lado do padrão superior direito e 7 ao lado do inferior esquerdo. Se uma cobertura esconde uma cópia, a outra ainda funciona. Clique em um módulo de formato na cena e o cartão oculto se abre; rasgue o canto superior esquerdo e apenas uma cópia sobrevive, mas a essa altura o padrão de posição também já desapareceu.
Ao lado da cópia inferior esquerda fica um módulo que é escuro em todo código QR: o módulo escuro, na linha 4V + 9 e coluna 8. Ele pertence à área de formato e não carrega nenhuma informação.
Versões 1 a 40
Símbolos pequenos não precisam declarar sua versão: o leitor conta os módulos. Em um símbolo grande, um pequeno erro na estimativa do tamanho do módulo produziria uma contagem incorreta, por isso, a partir da versão 7, a versão é escrita explicitamente. Seis bits do número da versão são estendidos a 18 com outro código BCH, gerado por x^12 + x^11 + x^10 + x^9 + x^8 + x^5 + x^2 + 1, e colocados duas vezes, como um bloco de 6 por 3 ao lado do padrão de posição superior direito e um bloco de 3 por 6 ao lado do inferior esquerdo. A versão 7 é escrita como 000111110010010100 e a versão 40 como 101000110001101001. Aqui também é possível corrigir 3 bits incorretos.
Quanto uma versão comporta depende do nível e do tipo de caracteres. As tabelas da DENSO WAVE dão, para a versão 1 no nível L, 41 dígitos, 25 caracteres alfanuméricos, 17 bytes ou 10 kanji, e, para a versão 1 no nível H, 17 dígitos, 10 caracteres alfanuméricos, 7 bytes ou 4 kanji. No outro extremo, a versão 40 no nível L comporta 7089 dígitos, 4296 caracteres alfanuméricos, 2953 bytes ou 1817 kanji. O codificador desta página reproduz esses números, e a tabela do laboratório os fornece para cada versão no nível atual, com a largura impressa para qualquer tamanho de módulo que você informar.
A DENSO WAVE sugere não exigir que celulares leiam dados demais: fornece cerca de 271 bytes, versão 10 no nível L, como um valor prático para câmeras de celular, dependendo do modelo. Pendure as versões na parede com Comparação para ver por quê. No tamanho de módulo da mesa, a versão 40 tem mais de um metro de largura.
Do texto aos bits
O texto que você digita não entra no código como letras. Entra como um fluxo de bits construído com segmentos, e cada segmento começa com um indicador de modo de 4 bits.
O modo numérico (0001) agrupa três dígitos de cada vez em 10 bits, porque 1000 combinações cabem em 1024. Um último grupo de dois dígitos ocupa 7 bits, e um único dígito, 4. O modo alfanumérico (0010) abrange 45 caracteres: os dígitos, as letras maiúsculas, o espaço e $ % * + - . / :. Ele agrupa dois caracteres em 11 bits como 45 x primeiro + segundo, porque 45 x 45 = 2025 cabe em 2048, e um último caractere isolado em 6 bits. O modo byte (0100) usa 8 bits por byte. O modo kanji (1000) pega um caractere Shift JIS de dois bytes e o comprime em 13 bits, razão pela qual o código QR conseguia carregar texto japonês de forma compacta desde o início.
Depois do indicador de modo vem uma contagem de caracteres. Seu comprimento depende do modo e da versão: nas versões 1 a 9, são 10 bits para numérico, 9 para alfanumérico, 8 para byte e 8 para kanji; versões maiores usam contagens mais longas. Depois vêm os caracteres. No final, o codificador acrescenta até 4 bits zero como terminador, zeros até o próximo limite de byte e, depois, os bytes de preenchimento 11101100 e 00010001 (236 e 17), alternadamente, até preencher a capacidade de dados.
A norma apresenta um exemplo resolvido: os oito dígitos 01234567 na versão 1, nível M. Modo 0001, contagem 0000001000 (oito), depois 012 como 0000001100, 345 como 0101011001 e 67 como 1000011. Com o terminador e o preenchimento, as 16 palavras-código de dados são, em hexadecimal, 10 20 0C 56 61 80 EC 11 EC 11 EC 11 EC 11 EC 11. O codificador desta página produz exatamente esses bytes e as palavras-código de correção de erros que a norma lista depois deles.
O modo byte não diz em qual conjunto de caracteres os bytes estão. As edições da norma a partir de 2006 tornam ISO 8859-1 o padrão; a primeira edição, de 2000, usava um conjunto japonês de 8 bits. Para outros textos, o codificador pode acrescentar um cabeçalho ECI (Interpretação Estendida de Canal, modo 0111) com o número 26, que significa UTF-8. A cena o acrescenta sempre que seu texto contém algo além de ASCII simples, de modo que coreano ou emojis chegam intactos. Digite kana japonês e o codificador muda para o modo kanji, com 13 bits por caractere em vez dos 24 em UTF-8.
O laboratório mostra seu próprio texto dividido nesses segmentos com suas contagens de bits. Uma URL em letras maiúsculas pode usar o modo alfanumérico e economizar quase um terço dos bits, uma das razões pelas quais alguns códigos impressos usam endereços em maiúsculas.
Reed-Solomon em um código QR
As palavras-código de dados são seguidas de palavras-código de correção de erros de um código Reed-Solomon, o código que Irving Reed e Gustave Solomon descreveram em cinco páginas em 1960. A DENSO WAVE o descreve como um método matemático usado em CDs de música, desenvolvido inicialmente contra ruído na comunicação com satélites e sondas planetárias, que corrige no nível dos bytes e é adequado para erros que ocorrem em rajadas.
A aritmética acontece em um corpo de 256 elementos, um para cada valor de byte. Somar dois bytes é fazer XOR. Multiplicá-los usa uma tabela construída a partir do polinômio x^8 + x^4 + x^3 + x^2 + 1, que a norma fixa para o código QR. Um bloco de palavras-código de dados é lido como os coeficientes de um polinômio, multiplicado por x^n e dividido por um polinômio gerador que tem as n raízes 1, a, a^2 até a^(n-1). O resto fornece as n palavras-código de correção de erros. O bloco inteiro, dados mais resto, é então um múltiplo do gerador, por isso sua avaliação resulta em zero em cada uma das n raízes.
Um leitor avalia o bloco recebido nessas raízes. Se cada resultado, chamado síndrome, for zero, o bloco está sem erros. Caso contrário, as síndromes contêm informações suficientes para encontrar até n/2 palavras-código incorretas e seus valores corretos. O decodificador desta página faz isso em três etapas que são padrão na teoria de codificação: o algoritmo Berlekamp-Massey encontra o menor polinômio localizador de erros (Massey, 1969), uma busca de Chien testa cada posição para encontrar suas raízes (Chien, 1964), e a fórmula de Forney fornece a magnitude de cada erro (Forney, 1965).
Há mais uma regra. Nos símbolos menores, um decodificador que corrigisse todos os n/2 erros chegaria com frequência demais a um bloco errado, mas válido. A norma, portanto, reserva algumas palavras-código como proteção contra decodificação incorreta: a versão 1 reserva 3 no nível L, 2 em M, 1 em Q e 1 em H, a versão 2-L reserva 2 e a versão 3-L reserva 1. Um bloco pode então corrigir (n - p)/2 palavras-código, em que p é o número reservado. A versão 1-L tem 7 palavras-código de correção de erros, mas corrige 2, não 3. O laboratório lista p ao lado do número que cada bloco consegue corrigir.
Uma palavra-código está incorreta tanto se um de seus bits estiver errado quanto se todos os oito estiverem. É por isso que os códigos Reed-Solomon são adequados para manchas e rasgos: danos que cobrem uma região de módulos estragam algumas palavras-código inteiras em vez de muitos bits espalhados.
Blocos e entrelaçamento
Acima das menores versões, as palavras-código são divididas em blocos, e cada bloco recebe suas próprias palavras-código de correção de erros. A versão 9 no nível H tem 292 palavras-código em 8 blocos. Quatro blocos têm 12 palavras-código de dados e quatro têm 13, cada um com 24 palavras-código de correção de erros, o que dá 100 palavras-código de dados e 192 de correção de erros. Cada bloco pode corrigir 12 palavras-código incorretas, portanto o símbolo como um todo pode corrigir 96 de suas 292 palavras-código.
Os blocos não são colocados um após o outro. Primeiro vem a primeira palavra-código de dados de cada bloco, depois a segunda de cada bloco, e assim por diante, seguidas da mesma forma pelas palavras-código de correção de erros. Ative Ordem de colocação e as cores mostram isso: palavras-código vizinhas no papel pertencem a blocos diferentes. Uma mancha do tamanho de algumas palavras-código, portanto, custa a cada um de vários blocos uma ou duas palavras-código, em vez de custar todas elas a um só bloco.
É isso que a mão da abertura mostra. As 16 colunas sob a mão alteram 96 palavras-código, 12 em cada um dos 8 blocos. O entrelaçamento distribui os danos de maneira tão uniforme que os 8 blocos atingem seu limite no mesmo momento. Mais uma coluna acrescenta palavras-código incorretas a cada bloco e todos falham juntos.
Pinte uma única mancha de tinta e observe as barras sob o painel: normalmente vários blocos sobem um pouco. A tarefa Sobrecarregar um bloco pede que você faça exatamente um bloco falhar enquanto os outros sobrevivem, o que exige mais cuidado do que parece, porque o entrelaçamento trabalha contra você.
Colocação das palavras-código
Depois que as palavras-código de dados e de correção de erros são entrelaçadas, seus bits são dispostos no símbolo ao longo de um caminho fixo. Ele começa no canto inferior direito e sobe por um par de colunas, primeiro o módulo da direita, depois o da esquerda, depois a próxima linha acima. No topo, faz uma curva e desce pelo próximo par de colunas, e assim por diante através do símbolo. Todo padrão funcional é pulado, e o padrão de sincronização vertical na coluna 6 é saltado por inteiro para que os pares continuem alinhados.
O caminho explica algumas coisas que você pode ver na cena. Os primeiros quatro bits, o indicador de modo, ficam sempre no canto inferior direito. A maioria das palavras-código ocupa um bloco de 2 por 4 módulos, mas onde o caminho faz uma curva no topo ou na base, ou contorna um padrão de alinhamento, uma palavra-código se dobra em outras formas. Clique em um módulo perto do canto inferior direito e seu cartão informa que ele faz parte do indicador de modo.
Quando as palavras-código não preenchem exatamente a área de dados, os módulos que sobram são bits restantes: 7 nas versões 2 a 6, 3 nas versões 14 a 20 e 28 a 34, 4 nas versões 21 a 27, e nenhum nas demais. Eles são claros antes da aplicação da máscara e o leitor os ignora.
Máscaras e pontos de penalidade
Um símbolo logo após a colocação pode ter grandes regiões escuras, longos trechos contínuos ou, por azar, uma região de dados que se pareça com um padrão de posição. Qualquer uma dessas coisas dificulta a leitura. Por isso, o codificador aplica uma máscara: inverte cada módulo de dados em que uma regra sobre sua linha i e coluna j é verdadeira. Há oito regras, desde (i + j) mod 2 = 0, um tabuleiro de xadrez, até ((i + j) mod 2 + (i j) mod 3) mod 2 = 0. Padrões funcionais nunca recebem máscara.
O codificador testa todas as oito e pontua cada resultado com quatro tipos de pontos de penalidade da norma. Cada trecho de 5 ou mais módulos da mesma cor em uma linha ou coluna custa 3 pontos, mais 1 por módulo além de 5. Cada bloco de 2 por 2 de uma só cor custa 3. Cada padrão que se parece com um padrão de posição, 1011101 com 4 módulos claros em um dos lados, custa 40. E a proporção de módulos escuros custa 10 pontos para cada 5 % de distância da metade. A máscara com menos pontos vence e seu número vai para as informações de formato.
O laboratório desenha as oito versões do seu símbolo lado a lado com suas pontuações. Escolha outra máscara com o controle Máscara e o código continua legível, porque o leitor obtém o número da máscara das informações de formato. É também por isso que dois geradores podem criar códigos de aparências diferentes a partir do mesmo texto e ambos estarem corretos. O FAQ da DENSO WAVE faz a mesma observação: dados idênticos podem produzir padrões diferentes, dependendo do modo e de outras escolhas.
Mostrar máscara tinge de laranja cada módulo que a máscara atual inverte. Compare com a regra no laboratório: é a mesma regra, aplicada à área inteira de dados.
O que 30 % realmente significa
A DENSO WAVE apresenta os quatro níveis como capazes de restaurar cerca de 7 %, 15 %, 25 % e 30 % das palavras-código e observa que o nível M é o mais comum. Duas expressões nessa frase importam: "cerca de" e "palavras-código".
"Cerca de", porque a proporção varia de uma versão para outra. Quando se divide o número de palavras-código que todos os blocos juntos podem corrigir pelo total, a proporção no nível L varia de 7,7 % a 10,5 % nas versões 1 a 40, no M de 15,4 % a 19,2 %, no Q de 23,1 % a 28,0 % e no H de 30,8 % a 33,2 %. A tabela do laboratório fornece o valor exato para a versão na cena.
Palavras-código, porque uma cobertura é medida em área e a área não se traduz de forma simples em palavras-código. Uma cobertura sobre a borda de uma palavra-código a estraga tão certamente quanto uma cobertura sobre toda ela. Uma cobertura que cai sobre módulos claros não muda nada, porque uma mão ou tira de papel é lida como claro: na cena, a mão sobre 30,2 % dos módulos altera apenas cerca de 16 % deles. Uma cobertura sobre padrões funcionais não custa palavras-código, mas pode custar os padrões de posição, a sincronização ou as informações de formato.
Portanto, o resumo honesto é este. No nível H, o símbolo pode sobreviver a uma cobertura de cerca de 30 % de sua área, se a cobertura ficar sobre os dados e os blocos dividirem os danos de maneira uniforme, como fazem as 16 colunas da mão. A mesma área disposta sobre linhas em vez de colunas, 16 linhas a 30,2 %, não pode ser lida na versão 9. Uma cobertura de 3,2 % no lugar errado impede a leitura. A tarefa Impedir a leitura com menos de 10 % existe para encontrar esse lugar.
A DENSO WAVE descreve a escolha de nível em termos práticos: Q ou H para fábricas onde os códigos ficam sujos, L para lugares limpos com muitos dados. Para um sistema de portas de plataforma em linhas de Tóquio, onde códigos nas portas dos trens enfrentam sol e chuva, a DENSO diz ter desenvolvido um código especial, tQR, que tolera 50 % de danos.
Como um celular encontra e lê o código
A norma descreve um algoritmo de decodificação de referência, e leitores reais seguem sua ordem, mesmo que seus detalhes sejam diferentes. O teste no laboratório pede que você coloque as etapas em ordem.
Primeiro, a imagem é transformada em preto e branco. Leitores reais escolhem um limiar para cada parte da imagem, porque um código em uma lata brilhante ou sob uma luminária de mesa não é iluminado de maneira uniforme. Depois vêm os padrões de posição, encontrados pela varredura 1:1:3:1:1 descrita acima. A partir dos três centros, o leitor estima o tamanho do módulo e a orientação e, depois, a versão a partir da distância entre os padrões de posição. Para a versão 7 em diante, lê as informações de versão para confirmar. Procura um padrão de alinhamento perto da posição esperada do quarto canto e ajusta uma transformação de perspectiva, que mapeia cada módulo da grade para a imagem.
Então, amostra o centro de cada módulo e lê as informações de formato. Das 32 palavras-código de formato válidas, escolhe a mais próxima da que leu, testando ambas as cópias se necessário. Isso fornece o nível e a máscara. Remove a máscara invertendo de volta os mesmos módulos, percorre o caminho de colocação para coletar as palavras-código, reorganiza-as em blocos, corrige cada bloco e, por fim, decodifica o fluxo de bits: modo, contagem, caracteres, até encontrar o terminador ou acabarem os dados.
A cena simplifica duas dessas etapas. O celular executa a busca de padrões de posição em pixels reais, girados pelo controle Rotação e com ou sem a margem, mas não curva nem inclina a imagem, e o leitor então amostra a grade em posições conhecidas em vez de ajustar uma perspectiva. E as coberturas são tratadas como claras: uma mão é lida como papel branco, fita preta como escuro. Uma câmera real veria a sombra de uma mão e a textura da pele, e poderia se sair melhor ou pior.
A DENSO WAVE apresenta mais um limite prático que nada tem a ver com o código: a cor. Seus scanners iluminam o código com luz vermelha, de modo que um código vermelho em papel branco reflete tanto vermelho quanto o papel e desaparece. Ela recomenda preto sobre branco.
Códigos de barras, Micro QR e rMQR
O código de barras que o código QR foi projetado para melhorar é o código de barras do varejo: UPC na América do Norte, EAN-13 nos demais lugares. Norman Woodland e Bernard Silver depositaram a primeira patente de um código lido opticamente em 1949, concedida em 7 de outubro de 1952. Segundo o Instituto Europeu de Patentes, a primeira leitura UPC em uma caixa registradora foi de um pacote de chicletes em um supermercado de Ohio em 1974, e um código de barras desse tipo comporta no máximo cerca de 20 caracteres.
Um código de barras EAN-13 tem 95 módulos de largura: um padrão de guarda de 3 módulos em cada extremidade e 5 no meio, e 12 dígitos de 7 módulos cada. O décimo terceiro dígito não é impresso como barras; é codificado na escolha entre dois padrões para os dígitos do lado esquerdo. O último dígito é um dígito verificador: os dígitos recebem pesos 1 e 3 alternadamente e o dígito verificador torna o total um múltiplo de 10. Isso detecta a maioria dos erros, mas não consegue corrigir nenhum. Coloque o código de barras no cavalete com Comparação e cubra sua metade superior, e ele ainda poderá ser lido, porque um scanner precisa de apenas uma linha limpa atravessando todas as barras. Cubra uma faixa vertical e ele não poderá ser lido.
O Micro QR, aprovado como norma JIS em novembro de 2004, segue no sentido oposto. Remove dois padrões de posição e mantém um, usa uma margem de dois módulos e vem em quatro tamanhos: M1 tem 11 por 11 módulos e comporta 5 dígitos, M4 tem 17 por 17 e comporta até 35. Tem apenas quatro máscaras, suas informações de formato carregam um número de símbolo de 3 bits em vez do nível e, em M1 e M3, a última palavra-código de dados tem apenas 4 bits de comprimento. O cavalete mostra uma versão Micro QR do seu texto se ele couber, no mesmo tamanho de módulo do símbolo na mesa. Até M4 comporta menos que a versão 1 do código completo.
Em maio de 2022, a ISO publicou o código Micro QR retangular, rMQR, para etiquetas longas e estreitas. A DENSO WAVE o descreve como usando um padrão e meio de posição, a partir de 7 por 43 módulos, com até 361 dígitos em 17 por 139 módulos. A DENSO WAVE também lançou iQR, uma família maior com símbolos retangulares, Frame QR com um espaço vazio para uma imagem, e SQRC, que restringe quem pode ler parte dos dados. Pesquisadores foram além: Chu e colegas mostraram em 2013 como criar um código que se parece com uma imagem em meios-tons e ainda pode ser lido, colocando o detalhe da imagem dentro de cada módulo e se apoiando na correção de erros.
Como o modelo difere de códigos e leitores reais
O codificador abrange por inteiro o que a norma chama de Modelo 2 para segmentos numéricos, alfanuméricos, byte e ECI, versões 1 a 40, todos os quatro níveis e todas as oito máscaras. Usa um segmento por texto em vez de misturar modos, o que um codificador cuidadoso faria para economizar bits. O modo kanji é limitado a kana, porque a tabela Shift JIS completa é grande; para esses caracteres, os bits são os mesmos de um codificador completo. A concatenação estruturada, que distribui uma mensagem por até 16 símbolos, não está implementada.
O leitor na cena lê a grade em posições conhecidas. Verifica os padrões de posição pela quantidade de módulos deles que sobrevivem e exige os três, como faz a maioria dos leitores de celular. Decodifica as informações de formato e de versão exatamente como a norma determina, remove a máscara, corrige cada bloco com decodificação Reed-Solomon, incluindo a proteção contra decodificação incorreta, e interpreta o fluxo de bits. Um leitor real também precisa lidar com desfoque, reflexos, perspectiva e impressão que espalha módulos escuros sobre os claros; a cena não tem nada disso.
A busca de padrões de posição do celular funciona em pixels e gira com o símbolo, mas a imagem é limpa e plana. As ferramentas de pintura e manchas marcam módulos inteiros. O símbolo sempre tem 30 cm de largura na mesa para que possa ser visto; códigos reais geralmente têm alguns centímetros.
Todos os números no painel vêm do código na mesa. Os dois leitores independentes usados na verificação (uma biblioteca de código aberto em JavaScript e outra em C++) leram todos os 320 símbolos de teste das versões 1 a 10 em cada nível e máscara, todos os 120 símbolos das versões 11 a 40, símbolos Micro QR de todos os oito tamanhos e níveis e códigos de barras EAN-13.
Uma breve história
A DENSO WAVE, na época uma divisão da DENSO, começou a desenvolver o código QR em 1992. As fábricas de automóveis estavam passando a produzir muitos modelos em pequenos lotes, e as peças eram enviadas com cerca de 10 códigos de barras por produto; etiquetas borradas de óleo não podiam ser lidas. A DENSO diz que a equipe de desenvolvimento tinha duas pessoas. Levou cerca de um ano e meio. O código foi anunciado em 1994 e podia comportar cerca de 7000 dígitos, codificar kanji e ser lido mais de 10 vezes mais rápido que outros códigos, segundo a DENSO WAVE. O Instituto Europeu de Patentes, ao dar à equipe o Prêmio do Público do Prêmio de Inventor Europeu em 2014, indicou uma velocidade cerca de 20 vezes maior que a dos códigos matriciais anteriores.
O nome significa resposta rápida, mas a DENSO WAVE diz que o nome oficial é QR Code, não uma sigla. A patente foi depositada no Japão em 14 de março de 1994 e concedida sob o número 2938338; a correspondente patente dos EUA, 5,726,435, lista Masahiro Hara, Motoaki Watabe, Tadao Nojiri, Takayuki Nagaya e Yuji Uchiyama como inventores. A DENSO WAVE mantém a patente, mas diz que não a exerce para códigos QR padronizados, uma política que, segundo ela, existe desde o início. QR Code é uma marca registrada da DENSO WAVE para a expressão, não para o padrão.
A indústria automobilística adotou o código primeiro, para kanban eletrônico, os cartões que solicitam peças. Depois de crises de segurança alimentar como a BSE, fabricantes de alimentos, medicamentos e lentes de contato o usaram para rastrear produtos. As normas vieram em seguida: AIM International em outubro de 1997, JEIDA-55 em março de 1998, JIS X 0510 em janeiro de 1999 e ISO/IEC 18004 em junho de 2000. A edição atual, a quarta, foi publicada em agosto de 2024.
Celulares capazes de ler códigos QR começaram a ser vendidos no Japão em 2002 e tiraram o código das fábricas. Em dezembro de 2011, a GS1, entidade por trás dos códigos de barras do varejo, o aprovou para celulares. A EMVCo publicou especificações de pagamento por QR em julho de 2017; Singapura combinou 27 sistemas de pagamento em uma etiqueta SGQR em 17 de setembro de 2018; o Brasil iniciou o Pix com 734 instituições em 16 de novembro de 2020. Durante a COVID-19, a Coreia usou códigos QR para registros de entrada a partir de 10 de junho de 2020, a Inglaterra e o País de Gales colocaram cartazes QR do NHS nas portas de estabelecimentos a partir de 24 de setembro de 2020, e o certificado digital COVID da UE, um código QR assinado, esteve em uso de 1 de julho de 2021 a 30 de junho de 2023. O varejo agora planeja que as caixas registradoras leiam códigos 2D até o fim de 2027.
Perguntas
Um código QR pode mesmo ser lido com 30 % coberto?
No nível H, sim, se a cobertura ficar sobre os dados e os danos forem distribuídos entre os blocos. Na cena, a mão cobre 30,2 % dos módulos e o código pode ser lido; mais uma coluna, 32,1 %, e não pode. A mesma área sobre 16 linhas em vez de 16 colunas não pode ser lida na versão 9. Cobrir um padrão de posição impede a leitura de qualquer código.
O que significam os níveis L, M, Q e H?
São os quatro níveis de correção de erros. A DENSO WAVE os apresenta como capazes de restaurar cerca de 7 %, 15 %, 25 % e 30 % das palavras-código. Um nível mais alto precisa de mais palavras-código de correção de erros, de modo que o mesmo texto produz um símbolo maior. A DENSO WAVE diz que o nível M é o mais escolhido.
Por que há três quadrados e não quatro?
Três pontos bastam para saber a posição, o tamanho e a orientação de um quadrado, e o canto com o ângulo reto informa ao leitor qual é a orientação do código. Uma quarta marca idêntica faria o código parecer igual em duas orientações. O Modelo 2 acrescenta um padrão de alinhamento menor perto do quarto canto para corrigir a perspectiva.
O que é o pequeno quadrado perto do canto inferior direito?
Um padrão de alinhamento. As versões 2 a 6 têm um; versões maiores têm mais, até 46 nas versões 35 a 40. Os leitores os usam para acompanhar códigos impressos em superfícies curvas ou fotografados em ângulo.
Por que um código QR precisa de uma borda branca?
Os padrões de posição são encontrados pelas faixas escuro, claro, escuro, claro, escuro na proporção 1:1:3:1:1. Se o código for impresso rente a uma borda escura, o anel escuro externo se funde com ela e as faixas se perdem. A norma exige uma margem com quatro módulos de largura. Desative a zona de silêncio na cena para ver o celular falhar.
Quanto um código QR pode comportar?
A versão 40 no nível L comporta 7089 dígitos, 4296 caracteres alfanuméricos, 2953 bytes ou 1817 kanji. Para câmeras de celular, a DENSO WAVE sugere planejar cerca de 271 bytes, versão 10 no nível L.
Um código QR pode conter texto em coreano ou chinês?
Sim. O modo byte pode carregar qualquer conjunto de caracteres; o leitor precisa saber qual é. Um cabeçalho ECI com o número 26 informa que os bytes são UTF-8, e a cena o acrescenta a qualquer texto que não seja ASCII simples. A DENSO WAVE também descreve um modo de compactação de 13 bits para caracteres chineses GB2312, que alguns celulares podem não ler.
Por que dois geradores de QR criam códigos diferentes com o mesmo texto?
Eles podem escolher um modo diferente, acrescentar ou omitir um cabeçalho ECI, escolher uma versão maior ou escolher uma máscara diferente. Todas essas opções são válidas, e qualquer leitor lerá os dois códigos. O FAQ da DENSO WAVE observa o mesmo.
O que a máscara faz?
Inverte os módulos de dados onde uma regra fixa sobre linha e coluna é verdadeira, para desfazer grandes blocos, longos trechos contínuos e padrões que se parecem com padrões de posição. O codificador testa as oito regras, pontua cada resultado com pontos de penalidade e usa a melhor. O número da máscara é armazenado nas informações de formato, de modo que o leitor pode desfazê-la.
O uso do código QR é gratuito?
Sim. A DENSO WAVE diz que não é necessária licença nem taxa para usar códigos QR feitos segundo as normas JIS ou ISO. Mantém sua patente, mas não a exerce para códigos padronizados. A expressão QR Code é uma marca registrada; o padrão não é.
Em que tamanho mínimo um código QR pode ser impresso?
A DENSO WAVE apresenta cerca de 0,17 mm como o menor módulo para uma impressora a laser comum, o que torna a versão 1 um símbolo de cerca de 3,57 mm de largura, e menciona módulos de 0,03 mm com impressoras e leitores especiais. Também alerta que códigos muito grandes podem não caber no campo de visão do leitor.
Posso criar um código QR colorido?
Às vezes. Os leitores precisam de contraste na luz que usam. Muitos scanners usam luz vermelha, por isso vermelho sobre branco desaparece, e um fundo escuro com um código claro pode confundir leitores que esperam módulos escuros. A DENSO WAVE recomenda preto sobre branco e testar qualquer outra opção.
Um código QR pode ser perigoso?
O código em si é apenas dados. O risco está no destino: um código colado sobre um verdadeiro pode levar você a uma página de pagamento falsa. Confira o endereço que o celular mostra antes de abri-lo, especialmente para pagamentos.
O que é um código Micro QR?
Um parente menor com um padrão de posição e uma margem de dois módulos, em quatro tamanhos de 11 por 11 a 17 por 17 módulos. Comporta até 35 dígitos e se tornou uma norma JIS em novembro de 2004.
Por que há sempre um módulo escuro ao lado do padrão de posição inferior esquerdo?
A norma o fixa na linha 4V + 9, coluna 8. Ele fica na área de formato e não carrega nenhuma informação, por isso todo código QR de uma determinada versão o tem no mesmo lugar.
O tabuleiro de Go inspirou o código QR?
Essa história é contada com frequência. Na própria entrevista da DENSO de 2024, Masahiro Hara diz que a ideia de uma marca de posição lhe veio em um trem, olhando para as janelas de um prédio, e menciona Go apenas ao explicar por que abrir mão da patente deu certo. A grade em si é simplesmente aquilo de que um código bidimensional precisa.
Termos
- Módulo: um quadrado da grade, escuro ou claro.
- Versão: o tamanho do símbolo, de 1 (21 por 21 módulos) a 40 (177 por 177).
- Padrão de posição: um dos três quadrados de 7 por 7 nos cantos, com a proporção 1:1:3:1:1.
- Separador: o anel claro com um módulo de largura ao redor de cada padrão de posição.
- Padrão de sincronização: os módulos alternados ao longo da linha 6 e da coluna 6.
- Padrão de alinhamento: um alvo de 5 por 5 usado para corrigir perspectiva e curvatura, a partir da versão 2.
- Zona de silêncio: a margem clara ao redor do símbolo, com quatro módulos de largura.
- Informações de formato: 15 bits com o nível de correção de erros e a máscara, protegidos por um código BCH, escritos duas vezes.
- Informações de versão: 18 bits que indicam a versão, a partir da versão 7, escritos duas vezes.
- Palavra-código: um grupo de 8 bits, a unidade de correção de erros.
- Bloco: um grupo de palavras-código com suas próprias palavras-código de correção de erros.
- Nível de correção de erros: L, M, Q ou H; quantas palavras-código podem ser restauradas.
- Código Reed-Solomon: um código corretor de erros sobre um corpo de 256 elementos que repara palavras-código inteiras.
- Síndrome: o valor do bloco recebido em uma raiz do gerador; todos os valores zero significam que nenhum erro foi encontrado.
- Máscara: uma regra que inverte módulos de dados para evitar padrões difíceis de ler.
- Modo: como os caracteres são agrupados em bits: numérico, alfanumérico, byte ou kanji.
- ECI: um cabeçalho que identifica o conjunto de caracteres dos bytes seguintes; 26 significa UTF-8.
- Bytes de preenchimento: 236 e 17, repetidos para preencher a capacidade não utilizada.
- Bits restantes: módulos que sobram após a última palavra-código.
- Micro QR: um símbolo menor com um padrão de posição, versões M1 a M4.
Fontes
- ISO/IEC 18004:2024, Information technology, Automatic identification and data capture techniques, QR code bar code symbology specification, edição 4 (publicada em 15 de agosto de 2024). https://www.iso.org/standard/83389.html (consultado em 20 de outubro de 2026)
- ISO/IEC 18004:2015, edição 3 (retirada; exemplo resolvido do Anexo I de 01234567 em 1-M). https://www.iso.org/standard/62021.html (consultado em 20 de outubro de 2026)
- ISO/IEC 23941:2022, Rectangular Micro QR Code (rMQR) bar code symbology specification (publicada em maio de 2022). https://www.iso.org/standard/77404.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, History of QR Code (equipe de duas pessoas, pesquisa de 1:1:3:1:1, cerca de 7000 dígitos, mais de 10 vezes mais rápido, lançamento em 1994, patente não exercida, kanban, BSE, celulares em 2002, AIM 1997, JIS 1999, ISO 2000, Micro QR 2004, iQR 2008, Frame QR 2014, Good Design Award 2012). https://www.qrcode.com/en/history/ (consultado em 20 de outubro de 2026)
- DENSO WAVE, Error correction feature (Reed-Solomon, palavras-código, nível M mais comum, CDs e sondas espaciais, erros em rajadas). https://www.qrcode.com/en/about/error_correction.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, Information capacity and versions of the QR Code (21 x 21 a 177 x 177, 4 módulos por versão, 100 dígitos em M na versão 3). https://www.qrcode.com/en/about/version.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, QR Code standardization (AIM outubro de 1997, JEIDA-55 março de 1998, JIS X 0510 janeiro de 1999, ISO/IEC 18004 junho de 2000, Micro QR JIS novembro de 2004, GS1 dezembro de 2011; capacidades; níveis de cerca de 7, 15, 25, 30 %; concatenação estruturada de 16 símbolos; patente 2938338 não exercida). https://www.qrcode.com/en/about/standards.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, Micro QR Code (um padrão de posição, margem de dois módulos, M1 a M4, tabela de capacidade, máximo de 35 dígitos). https://www.qrcode.com/en/codes/microqr.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, QR Code Model 1 and Model 2 (Modelo 1 versão 14, 73 x 73, 1167 dígitos; Modelo 2 padrões de alinhamento, versão 40, 7089 dígitos). https://www.qrcode.com/en/codes/model12.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, rMQR Code (um padrão e meio de posição, 7 x 43 a 17 x 139, 361 dígitos, ISO maio de 2022). https://www.qrcode.com/en/codes/rmqr.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, Point for determining the code area (margem de quatro módulos, 50 caracteres em M na versão 3, 0,254 mm, 9,398 mm). https://www.qrcode.com/en/howto/code.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, Point for setting the module size (densidade da cabeça de impressão, 0,17 mm a 600 dpi com 4 pontos). https://www.qrcode.com/en/howto/cell.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, FAQ (não é sigla, pratos de sushi e livros de bolso, 3,57 mm e 0,03 mm, 271 bytes para celulares, modo chinês de 13 bits, luz vermelha, mesmos dados com padrões diferentes, marca registrada apenas para a expressão, sem taxa). https://www.qrcode.com/en/faq.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, QR Code development story (início em 1992, cerca de 1000 códigos de barras por dia, dois integrantes, padrões de detecção de posição). https://www.denso-wave.com/en/technology/vol1.html (consultado em 20 de outubro de 2026)
- DENSO WAVE, QR Code 30th anniversary (primeira missão com peças de automóveis, legível com contaminação por óleo). https://www.denso-wave.com/en/system/qr/qr30th/ (consultado em 20 de outubro de 2026)
- DENSO DRIVEN BASE, Believing in a faint light: obstacles QR Code developer overcame and the source of his idea (entrevista com Masahiro Hara, situação em maio de 2024: desenvolvimento desde 1992, cerca de 10 códigos de barras por produto, a proporção encontrada após cerca de seis meses, janelas de prédios vistas de um trem, Go como passatempo). https://www.denso.com/global/en/driven-base/career-life/qr-hara_2408/ (consultado em 20 de outubro de 2026)
- DENSO DRIVEN BASE, QR codes powering digital transformation (tQR para portas de plataforma, tolerância a danos aumentada de 30 % para 50 %), 25 de fevereiro de 2025. https://www.denso.com/global/en/driven-base/career-life/qr_engineer-1/ (consultado em 20 de outubro de 2026)
- European Patent Office, Masahiro Hara, Motoaki Watabe, Tadao Nojiri, Takayuki Nagaya, Yuji Uchiyama, European Inventor Award 2014, Popular Prize (primeira leitura UPC em 1974, cerca de 20 caracteres, 20 vezes mais rápido). https://www.epo.org/en/news-events/european-inventor-award/meet-the-finalists/masahiro-hara-motoaki-watabe-tadao-nojiri (consultado em 20 de outubro de 2026)
- Patente japonesa JP 2938338 B2, 2D code, depositada em 14 de março de 1994, concedida em 1999 (Google Patents). https://patents.google.com/patent/JP2938338B2/en (consultado em 20 de outubro de 2026)
- Patente dos EUA 5,726,435, Optically readable two-dimensional code and method and apparatus using the same, concedida em 10 de março de 1998 (Google Patents). https://patents.google.com/patent/US5726435A/en (consultado em 20 de outubro de 2026)
- Patente dos EUA 2,612,994, N. J. Woodland e B. Silver, Classifying apparatus and method, depositada em 20 de outubro de 1949, concedida em 7 de outubro de 1952 (Google Patents). https://patents.google.com/patent/US2612994A/en (consultado em 20 de outubro de 2026)
- I. S. Reed e G. Solomon, Polynomial codes over certain finite fields, Journal of the Society for Industrial and Applied Mathematics 8(2), 300 a 304, 1960. https://doi.org/10.1137/0108018 (consultado em 20 de outubro de 2026)
- R. C. Bose e D. K. Ray-Chaudhuri, On a class of error correcting binary group codes, Information and Control 3(1), 1960. https://doi.org/10.1016/S0019-9958(60)90287-4 (consultado em 20 de outubro de 2026)
- J. L. Massey, Shift-register synthesis and BCH decoding, IEEE Transactions on Information Theory 15(1), 1969. https://doi.org/10.1109/TIT.1969.1054260 (consultado em 20 de outubro de 2026)
- R. T. Chien, Cyclic decoding procedures for Bose-Chaudhuri-Hocquenghem codes, IEEE Transactions on Information Theory 10(4), 1964. https://doi.org/10.1109/TIT.1964.1053699 (consultado em 20 de outubro de 2026)
- G. D. Forney, On decoding BCH codes, IEEE Transactions on Information Theory 11(4), 1965. https://doi.org/10.1109/TIT.1965.1053825 (consultado em 20 de outubro de 2026)
- H.-K. Chu, C.-S. Chang, R.-R. Lee e N. J. Mitra, Halftone QR codes, ACM Transactions on Graphics 32(6), 2013. https://doi.org/10.1145/2508363.2508408 (consultado em 20 de outubro de 2026)
- EMVCo, EMVCo publishes QR code payment specifications to promote global interoperability, 31 de julho de 2017. https://www.emvco.com/wp-content/uploads/news/EMVCo-QR-Code-Specification-Launch-FINAL-v1.pdf (consultado em 20 de outubro de 2026)
- EMVCo, EMV QR Codes. https://www.emvco.com/emv-technologies/qr-codes (consultado em 20 de outubro de 2026)
- Monetary Authority of Singapore, Singapore introduces world's first unified payment QR code, SGQR, 17 de setembro de 2018. https://www.mas.gov.sg/news/media-releases/2018/singapore-introduces-worlds-first-unified-payment-qr-code (consultado em 20 de outubro de 2026)
- Banco Central do Brasil, Pix starts its full operation with 734 institutions on November 16, 2020. https://www.bcb.gov.br/en/pressdetail/2361/nota (consultado em 20 de outubro de 2026)
- Ministry of Health and Welfare (Korea), blog oficial, KI-Pass electronic entry logs nationwide from 10 June, junho de 2020. https://blog.naver.com/mohw2016/221995921830 (consultado em 20 de outubro de 2026)
- GOV.UK, Businesses urged to prepare for NHS COVID-19 app, 11 de setembro de 2020 (lançamento e registro de entrada por QR em 24 de setembro). https://www.gov.uk/government/news/businesses-urged-to-prepare-for-nhs-covid-19-app (consultado em 20 de outubro de 2026)
- Council of the European Union, EU digital COVID certificate: how it works (1 de julho de 2021 a 30 de junho de 2023, código QR com assinatura digital). https://www.consilium.europa.eu/en/policies/coronavirus-pandemic/eu-digital-covid-certificate (consultado em 20 de outubro de 2026)
- IATA, Bar Coded Boarding Pass (BCBP) implementation guide, versão 7, 2021 (PDF417, Aztec, DataMatrix, código QR; códigos de barras 1D limitados a cerca de 30 caracteres). https://www.iata.org/contentassets/1dccc9ed041b4f3bbdcf8ee8682e75c4/2021_03_02-bcbp-implementation-guide-version-7-.pdf (consultado em 20 de outubro de 2026)
- GS1 US, What is GS1 Sunrise 2027? https://www.gs1us.org/industries-and-insights/by-topic/sunrise-2027 (consultado em 20 de outubro de 2026)
- GS1, GS1 Digital Link. https://www.gs1.org/standards/gs1-digital-link (consultado em 20 de outubro de 2026)
- GS1, GS1 barcodes. https://www.gs1.org/standards/barcodes (consultado em 20 de outubro de 2026)
Texto e simulação: CC BY-NC-SA 4.0, salvo indicação em contrário.
Mais exposições
Máquina Enigma: simulador interativo de rotores
Aperte A cinco vezes numa Enigma ajustada em I-II-III e AAA e as lâmpadas acendem B, D, Z, G, O.
Tipos móveis e a prensa de impressão
Um tipo traz sua letra de trás para a frente. Entinte-o, pressione o papel sobre ele, vire a folha e a letra é lida no sentido certo.
Como funciona uma máquina de escrever manual
Numa máquina de escrever pica, cada letra, espaço e ponto final move o carro os mesmos 2,54 mm para a esquerda.
Braille: aprenda a ler pontos e testar códigos de sinais
Um ponto braille mede 1,5 mm. Seis pontos numa grade de 2 por 3 dão 64 padrões compartilhados por braille coreano, inglês, japonês e musical.
Como funciona uma impressora 3D, camada por camada
Um cubo de 20 mm impresso em camadas de 0,2 mm tem exatamente 100 camadas, cada uma desenhada por um bico de 0,4 mm de largura.
Quantos satélites existem em órbita e quando você pode vê-los
Em 20 de outubro de 2026, o catálogo público registrava 16.768 satélites operacionais, e dois de cada três pertenciam à rede de internet de uma empresa.