FIG. 102Les sens
Code QR : comment il est lu
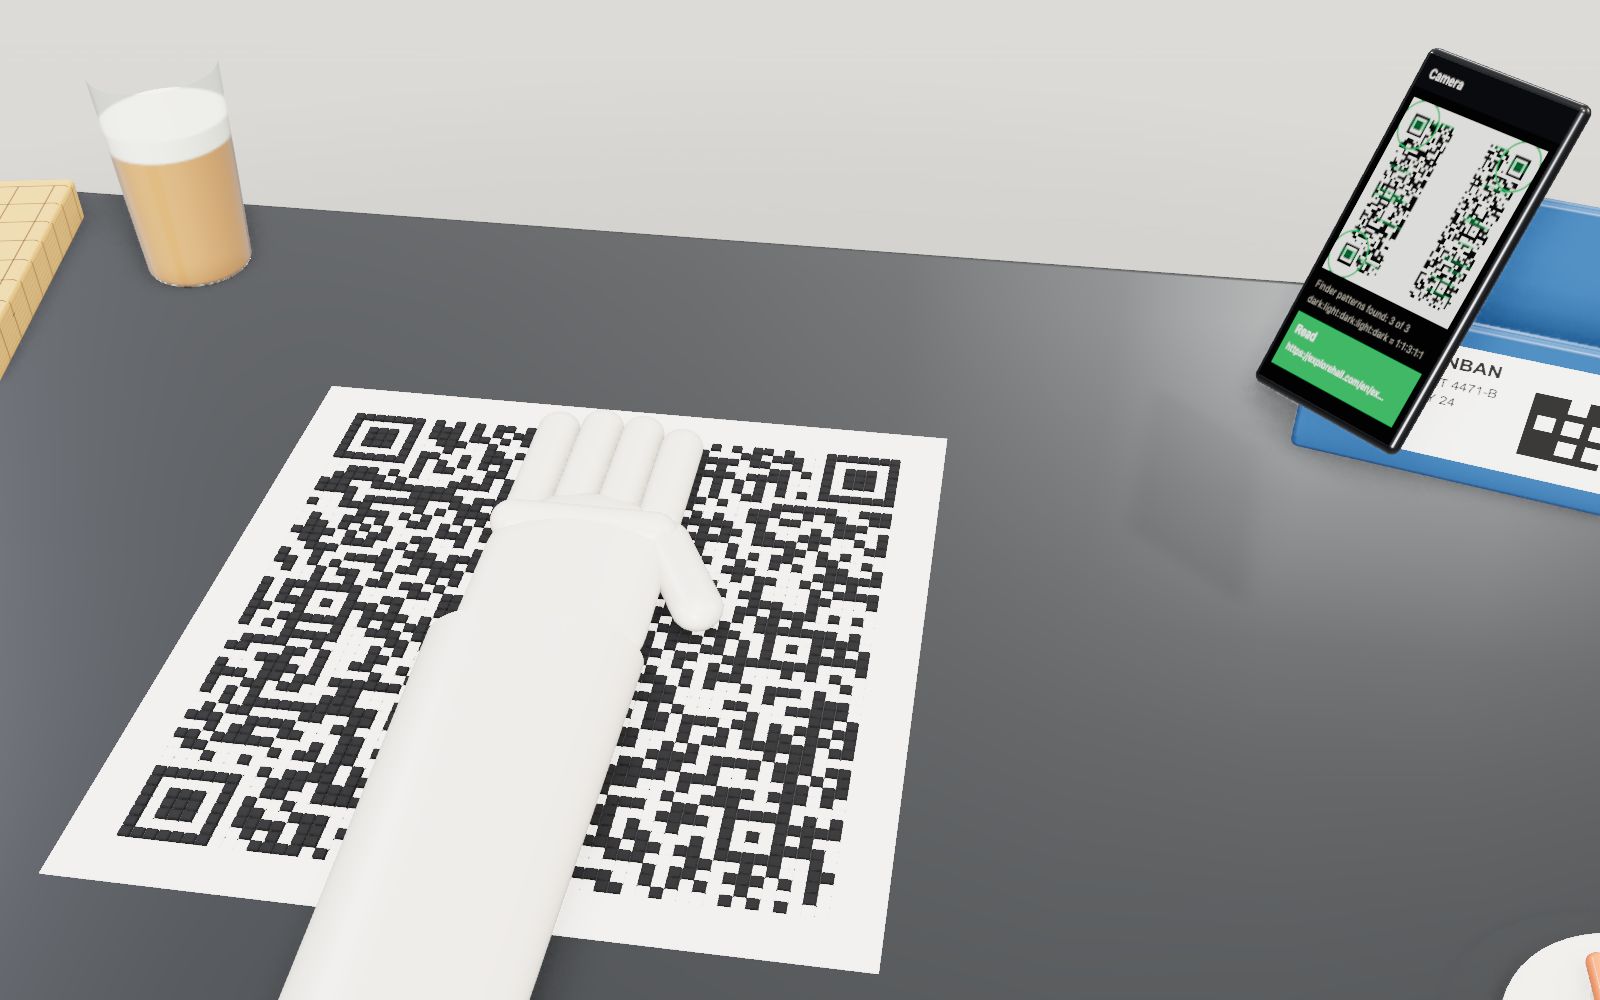
Couvrez 30 % d’un code QR avec la main et un téléphone le lit encore. Couvrez un coin et il ne le lit plus.
Cet appareil ne peut pas afficher le modèle 3D. Les étapes de la visite ci-dessous se lisent sous forme de texte.
1 / 20 30 % sous une mainVoici votre texte sous forme de code QR au niveau H, version 9 : 53 x 53 modules. Une main de mannequin glisse dessus. Regardez l’affichage et le téléphone à droite : le code reste lisible pendant que la main couvre environ 30 % des modules.
Faites glisser pour tourner. Molette ou pincement pour zoomer.
Un code que vous pouvez couvrir avec la main
Présentez un téléphone devant un code QR et il le lit en un instant, même si un autocollant se décolle, si un coin est froissé ou si un pouce le masque. Essayez la même chose avec le code-barres d’une boîte de céréales et la caisse vous répond par un signal sonore. La différence ne vient pas de la caméra. Un code QR contient des mots de code supplémentaires qui permettent au lecteur de reconstruire les parties qu’il ne parvient pas à voir, ainsi que trois repères qui lui permettent de le trouver sous n’importe quel angle avant même de commencer.
La scène s’ouvre avec votre propre texte, ou l’adresse de cette page, transformé en un code QR de niveau H, version 9 : un carré de 53 modules sur 53 posé sur une table de galerie. Une main de mannequin glisse dessus depuis le bord et s’arrête lorsqu’elle couvre 16 des 53 colonnes. Cela représente 848 des 2809 modules, soit 30,2 % du symbole. L’affichage continue d’indiquer « Lisible », et le téléphone à droite continue de trouver le code et d’afficher votre texte. Chacun des 8 blocs de correction d’erreurs du symbole atteint alors sa limite : 12 mots de code erronés chacun, et 12 est le maximum qu’un bloc de cette taille peut corriger. Élargissez la couverture d’une colonne, jusqu’à 32,1 %, et la lecture s’arrête.
Déchirez ensuite un coin. Le triangle arraché ne représente que 3,2 % du symbole, bien moins que la surface couverte par la main, et pourtant plus rien ne peut être lu. Le reste de cette page explique pourquoi ces deux choses se produisent, avec les nombres utilisés par la scène. Ils proviennent des règles de l’ISO/IEC 18004, la norme internationale du code QR, et des publications consacrées à sa conception par DENSO WAVE, l’entreprise qui l’a développé en 1994.
Le symbole posé sur la table n’est pas une simple image représentant un code QR. Il est encodé dans la page à partir du texte du champ, module par module, avec la même arithmétique de Reed-Solomon qu’utiliserait un pilote d’imprimante, puis relu par un décodeur qui suit les étapes de référence de la norme. Vous pouvez enregistrer une image du symbole intact et la lire avec votre propre téléphone. L’encodeur a été vérifié avec deux lecteurs indépendants et un second encodeur : pour 160 combinaisons de version et de niveau, les matrices étaient identiques module par module.
Comment utiliser la scène
Saisissez du texte dans le champ au bas de la scène et le symbole se reconstruit pendant la saisie. L’affichage dans le coin supérieur gauche présente d’abord le résultat (« Lisible », ou « Illisible » avec la raison), puis la version et la taille, le niveau de correction d’erreurs, le masque et ses points de pénalité, le mode et le nombre de bits nécessaires à votre texte, les mots de code, la surface couverte et le nombre de mots de code désormais erronés. Les petites barres en dessous représentent les blocs de correction d’erreurs : chacune se remplit à mesure que le nombre de mots de code erronés approche de sa capacité de correction, et devient rouge lorsque celle-ci est dépassée.
L’écran du téléphone à droite montre ce qu’une caméra ferait de l’image : une ligne rouge balaie l’image vers le bas, des repères verts indiquent chaque ligne dont les bandes correspondent à 1:1:3:1:1, et des cercles montrent si les trois motifs de position ont été trouvés. En dessous, le téléphone affiche le texte ou la raison de son abandon.
Dans les commandes, Version définit la plus petite version à utiliser (l’encodeur agrandit le symbole si votre texte ne tient pas), Correction d’erreurs choisit L, M, Q ou H, et Masque impose l’un des huit masques à la place de celui qui donne le moins de points de pénalité. Largeur du cache et Position du cache déplacent la main, et Cache la remplace par une bande de papier ou du ruban noir. Relief par fonction élève les modules en couches selon leur rôle ; Couleur par fonction les colore sans les soulever. Ordre de placement trace le parcours suivi par les bits et colore les mots de code par bloc. Afficher le masque teinte les modules que le masque inverse. Rotation fait tourner le symbole sur la table. Comparer place un code-barres EAN-13 ou un symbole Micro QR sur le chevalet, ou accroche au mur les versions 1 à 40. Zone de silence supprime la marge blanche.
Peindre vous permet de faire glisser de l’encre, du correcteur, un trou ou une gomme sur le symbole. Déchirer un coin et Taches d’huile permettent de l’endommager rapidement. Heure actuelle remplit le symbole avec l’heure courante et le redessine chaque seconde. Cliquez sur n’importe quel module pour voir ce qu’il est : sa ligne et sa colonne, sa fonction et, pour les modules de données, le bloc, le mot de code et le bit auxquels il appartient. Certains modules et certains objets sur la table ouvrent des fiches cachées.
Sous les commandes, vous trouverez votre texte écrit en bits, les mots de code de chaque bloc en hexadécimal, un tableau des quatre niveaux pour la version actuelle, les huit masques côte à côte, un tableau des versions, 12 défis, 46 cas, des fiches qui commencent par « En réalité », une collection et des liens vers des expositions associées.
Des carrés dans trois coins
Le plus difficile pour lire un code à deux dimensions n’est pas de lire les données. C’est de trouver le code dans une image de caméra remplie d’autres objets, de déterminer son orientation et la taille de chaque module. Un code-barres est facile à trouver : un laser ou une rangée de pixels n’a qu’à le traverser. Un code matriciel doit être trouvé dans deux dimensions.
La réponse de DENSO WAVE a été de placer trois carrés dans les coins, que la norme appelle motifs de position. Chacun mesure 7 modules sur 7 : un anneau sombre, un anneau clair et un centre sombre de 3 sur 3. Une ligne passant par le centre dans n’importe quelle direction traverse du sombre, du clair, du sombre, du clair et du sombre sur des largeurs de 1, 1, 3, 1 et 1. Le rapport ne change pas lorsque le code est tourné, agrandi ou vu de biais ; un lecteur peut donc balayer les rangées de pixels, conserver les cinq dernières séquences sombres et claires et tester si elles correspondent.
Pourquoi ce rapport ? Selon DENSO WAVE, les développeurs ont réduit des images et des caractères imprimés sur des prospectus, des magazines et des cartons à des motifs noirs et blancs, puis compté la fréquence des rapports. Celui qui apparaissait le moins sur les documents imprimés était 1:1:3:1:1. Dans un entretien publié par DENSO en 2024, Masahiro Hara, qui dirigeait le travail, a expliqué que sa recherche avait pris environ six mois : les journaux et magazines étaient photographiés page par page, et les logiciels de mesure fonctionnaient toute la nuit.
Le téléphone de la scène fait exactement cela avec les pixels qu’il voit. Il parcourt chaque ligne, compte les séquences et accepte cinq séquences dont les largeurs sont à moins d’un demi-module de 1:1:3:1:1. Pour chaque correspondance, il vérifie le même rapport verticalement, au milieu de la séquence centrale. Les correspondances qui concordent deviennent des centres candidats. Il en faut ensuite trois, et celui qui forme un angle droit avec les deux autres est le coin supérieur gauche. Cet angle indique également au lecteur de combien le code est tourné. Faites tourner le symbole avec Rotation et regardez les cercles suivre les coins.
Une zone de données peut former les mêmes bandes par hasard. Les lecteurs rejettent ces faux repères parce que la grille qu’ils impliquent ne correspond pas. La scène ne compte un motif de position comme trouvé que lorsque la détection tombe sur le véritable motif.
Séparateurs, marge et table sombre
Le test 1:1:3:1:1 ne fonctionne que si l’anneau sombre extérieur est bordé de clair des deux côtés. À l’intérieur du symbole, les séparateurs le garantissent : un anneau clair d’un module de large autour de chaque motif de position. À l’extérieur, c’est le rôle de la zone de silence, une marge claire dont la norme exige une largeur de quatre modules de chaque côté.
Sur la scène, le symbole est imprimé sur une feuille de papier dont la marge mesure exactement quatre modules. La table en dessous est en ardoise sombre. Désactivez Zone de silence et la marge de papier disparaît : l’anneau extérieur de chaque motif de position rejoint directement la table sombre. Une ligne traversant un motif de position devient alors une longue séquence sombre suivie de clair, de sombre, de clair et de sombre : la première séquence s’étend sur de nombreux modules et le rapport échoue. Le téléphone ne trouve aucun motif de position et l’affichage indique « Illisible, un motif de position manque ». Rien n’a changé dans les données.
Les conseils d’impression de DENSO WAVE intègrent la marge à la taille de l’étiquette. L’exemple donné est celui de 50 caractères alphanumériques au niveau M, qui nécessite la version 3 (29 modules ; la version 2 au niveau M n’en contient que 38). Avec une imprimante à 400 dpi et 4 points par module, le module mesure 0,254 mm, le symbole 7,366 mm et, avec 8 modules de marge, la surface de l’étiquette forme un carré de 9,398 mm de côté. Les codes Micro QR, qui n’ont qu’un motif de position, nécessitent une marge de deux modules au lieu de quatre.
Une règle imprimée dans le code
La ligne 6 et la colonne 6 de chaque code QR vont d’un motif de position au suivant en alternant sombre et clair. Ce sont les motifs de synchronisation. Ils indiquent au lecteur où se trouve chaque colonne et chaque ligne, ce qui importe lorsque l’impression est étirée, le papier gondolé ou le code vu de biais par la caméra. Un lecteur qui connaît la position des motifs de position peut estimer la taille des modules, mais compter les modules alternés donne le nombre exact de modules entre les motifs de position.
Le nombre de modules indique aussi la version. La version V compte 17 + 4V modules par côté ; la version 1 mesure donc 21 sur 21 et la version 40, 177 sur 177. Sur la scène, le symbole occupe toujours les mêmes 30 cm de papier ; le module rétrécit donc quand la version augmente : 5,7 mm à la version 9, 1,7 mm à la version 40.
Puisque les motifs de synchronisation se trouvent à l’intérieur du symbole, ils occupent aussi des modules qui pourraient contenir des données. Dans la version 1, les motifs fonctionnels (motifs de position, séparateurs, synchronisation, informations de format et module sombre) laissent 208 modules pour les mots de code : 26 mots de code de 8 bits.
Des cibles pour le papier courbé
Le premier code QR de 1994, aujourd’hui appelé Modèle 1, n’avait pas d’autres guides. DENSO WAVE indique que le Modèle 1 allait jusqu’à la version 14, 73 modules sur 73, et 1167 chiffres. Le Modèle 2, le code QR utilisé aujourd’hui, a ajouté des motifs d’alignement pour permettre la lecture de codes imprimés sur des surfaces courbes ou vus sous un angle prononcé. Il a aussi étendu la gamme jusqu’à la version 40 et 7089 chiffres.
Un motif d’alignement est une petite cible de 5 sur 5 : un anneau sombre, un anneau clair et un module central sombre. La version 1 n’en a aucun. Les versions 2 à 6 en ont un, près du coin inférieur droit, les versions 7 à 13 en ont six et leur nombre atteint 46 dans les versions 35 à 40. Leurs centres se trouvent sur une grille de lignes et de colonnes indiquée dans la norme ; les mêmes positions sont utilisées pour les lignes et les colonnes, et les trois emplacements qui recouvriraient un motif de position sont omis. La scène calcule ces positions à partir de la version : pour la version 9, ce sont 6, 26 et 46, ce qui donne 3 x 3 = 9 emplacements moins 3 = 6 motifs.
Un lecteur qui a trouvé les trois motifs de position connaît trois coins du code. Le quatrième coin n’est pas marqué : le lecteur l’estime, puis cherche le motif d’alignement le plus proche pour corriger l’estimation. Avec ce quatrième point, il peut annuler la perspective d’une photo inclinée. Sur un grand symbole, plusieurs motifs d’alignement permettent au lecteur de suivre une page bombée.
Quinze bits pour indiquer comment lire le reste
Avant de lire des données, un lecteur doit connaître deux choses : le niveau de correction d’erreurs et le masque appliqué parmi les huit possibles. Ils occupent 5 bits : 2 pour le niveau (L vaut 01, M vaut 00, Q vaut 11 et H vaut 10) et 3 pour le numéro du masque.
Ces 5 bits sont beaucoup mieux protégés que les données. Ils sont étendus à 15 bits par un code BCH, les codes correcteurs d’erreurs découverts par Bose et Ray-Chaudhuri en 1960 et indépendamment par Hocquenghem en 1959. Les 10 bits de contrôle sont le reste de la division des 5 bits, décalés de 10 vers la gauche, par le polynôme x^10 + x^8 + x^5 + x^4 + x^2 + x + 1. Deux mots de code quelconques parmi les 32 mots possibles de 15 bits diffèrent d’au moins 7 bits : un lecteur peut donc choisir le plus proche même lorsque 3 bits sont erronés.
Les 15 bits subissent ensuite un XOR avec le motif fixe 101010000010010. Sans cela, le niveau M avec le masque 0 donnerait 15 modules clairs, et le lecteur ne pourrait pas distinguer les informations de format d’une feuille blanche.
Les informations de format sont écrites deux fois : une fois autour du motif de position supérieur gauche, et une fois réparties entre les deux autres, 8 bits à côté du motif supérieur droit et 7 à côté du motif inférieur gauche. Si un cache masque une copie, l’autre fonctionne encore. Cliquez sur un module de format sur la scène et la fiche cachée s’ouvre ; déchirez le coin supérieur gauche et une seule copie survit, mais le motif de position a alors disparu lui aussi.
À côté de la copie inférieure gauche se trouve un module qui est sombre dans chaque code QR : le module sombre, à la ligne 4V + 9 et à la colonne 8. Il appartient à la zone de format et ne contient aucune information.
Les versions 1 à 40
Les petits symboles n’ont pas besoin d’indiquer leur version : le lecteur compte les modules. Dans un grand symbole, une petite erreur d’estimation de la taille des modules donnerait un décompte erroné ; la version est donc écrite à partir de la version 7. Les six bits du numéro de version sont étendus à 18 par un autre code BCH, engendré par x^12 + x^11 + x^10 + x^9 + x^8 + x^5 + x^2 + 1, et placés deux fois, sous forme d’un bloc de 6 sur 3 à côté du motif de position supérieur droit et d’un bloc de 3 sur 6 à côté du motif inférieur gauche. La version 7 s’écrit 000111110010010100 et la version 40, 101000110001101001. Ici aussi, 3 bits erronés peuvent être corrigés.
La capacité d’une version dépend du niveau et du type de caractères. Les tableaux de DENSO WAVE donnent pour la version 1 au niveau L 41 chiffres, 25 caractères alphanumériques, 17 octets ou 10 kanji, et pour la version 1 au niveau H 17 chiffres, 10 caractères alphanumériques, 7 octets ou 4 kanji. À l’autre extrémité, la version 40 au niveau L contient 7089 chiffres, 4296 caractères alphanumériques, 2953 octets ou 1817 kanji. L’encodeur de cette page reproduit ces nombres, et le tableau du laboratoire les donne pour chaque version au niveau actuel, avec la largeur imprimée correspondant à la taille de module que vous saisissez.
DENSO WAVE suggère de ne pas trop demander aux téléphones : l’entreprise donne environ 271 octets, la version 10 au niveau L, comme valeur pratique pour les caméras de téléphone, selon le modèle. Accrochez les versions au mur avec Comparer pour comprendre pourquoi. À la taille des modules du symbole sur la table, la version 40 mesure plus d’un mètre de large.
Du texte aux bits
Le texte que vous saisissez n’entre pas dans le code sous forme de lettres. Il y entre comme un flux de bits constitué de segments, chaque segment commençant par un indicateur de mode de 4 bits.
Le mode numérique (0001) regroupe les chiffres par trois dans 10 bits, car 1000 combinaisons tiennent dans 1024. Un dernier groupe de deux chiffres prend 7 bits et un chiffre seul, 4. Le mode alphanumérique (0010) couvre 45 caractères : les chiffres, les lettres majuscules, l’espace et $ % * + - . / :. Il regroupe deux caractères dans 11 bits selon 45 x premier + second, car 45 x 45 = 2025 tient dans 2048, et un dernier caractère seul dans 6 bits. Le mode octet (0100) utilise 8 bits par octet. Le mode kanji (1000) prend un caractère Shift JIS de deux octets et le comprime dans 13 bits, ce qui explique pourquoi le code QR pouvait contenir du texte japonais de façon compacte dès le départ.
Après l’indicateur de mode vient un nombre de caractères. Sa longueur dépend du mode et de la version : pour les versions 1 à 9, il mesure 10 bits en numérique, 9 en alphanumérique, 8 en octet et 8 en kanji ; les versions plus grandes utilisent des compteurs plus longs. Viennent ensuite les caractères. À la fin, l’encodeur ajoute jusqu’à 4 bits nuls comme terminateur, des zéros jusqu’à la prochaine limite d’octet, puis les octets de remplissage 11101100 et 00010001 (236 et 17) en alternance jusqu’à remplir la capacité de données.
La norme donne un exemple détaillé : les huit chiffres 01234567 à la version 1, niveau M. Mode 0001, nombre 0000001000 (huit), puis 012 comme 0000001100, 345 comme 0101011001 et 67 comme 1000011. Avec le terminateur et le remplissage, les 16 mots de code de données sont, en hexadécimal, 10 20 0C 56 61 80 EC 11 EC 11 EC 11 EC 11 EC 11. L’encodeur de cette page produit exactement ces octets et les mots de code de correction d’erreurs que la norme donne à leur suite.
Le mode octet n’indique pas dans quel jeu de caractères les octets sont écrits. Les éditions de la norme depuis 2006 font de l’ISO 8859-1 le jeu par défaut ; la première édition de 2000 utilisait un jeu japonais de 8 bits. Pour les autres textes, l’encodeur peut ajouter un en-tête ECI (Extended Channel Interpretation, mode 0111) avec le nombre 26, qui signifie UTF-8. La scène l’ajoute dès que votre texte dépasse le simple ASCII ; le coréen ou les émojis arrivent ainsi intacts. Saisissez des kana japonais et l’encodeur passe plutôt au mode kanji, à 13 bits par caractère au lieu de 24 en UTF-8.
Le laboratoire montre votre propre texte décomposé en ces segments avec leur nombre de bits. Une URL en majuscules peut utiliser le mode alphanumérique et économiser presque un tiers des bits, ce qui explique en partie pourquoi certains codes imprimés utilisent des adresses en majuscules.
Reed-Solomon dans un code QR
Les mots de code de données sont suivis de mots de code de correction d’erreurs issus d’un code de Reed-Solomon, le code qu’Irving Reed et Gustave Solomon ont décrit en cinq pages en 1960. DENSO WAVE le décrit comme une méthode mathématique utilisée dans les CD de musique, développée d’abord contre le bruit dans les communications avec les satellites et les sondes planétaires, qui corrige au niveau des octets et convient aux erreurs en rafales.
L’arithmétique s’effectue dans un corps de 256 éléments, un pour chaque valeur d’octet. Additionner deux octets revient à faire un XOR. Leur multiplication utilise une table construite à partir du polynôme x^8 + x^4 + x^3 + x^2 + 1, que la norme fixe pour le code QR. Un bloc de mots de code de données est lu comme les coefficients d’un polynôme, multiplié par x^n et divisé par un polynôme générateur qui possède les n racines 1, a, a^2 jusqu’à a^(n-1). Le reste donne les n mots de code de correction d’erreurs. Le bloc entier, données plus reste, est alors un multiple du générateur ; sa valeur est donc nulle en chacune des n racines.
Un lecteur évalue le bloc reçu en ces racines. Si chaque résultat, appelé syndrome, est nul, le bloc est intact. Sinon, les syndromes contiennent assez d’informations pour trouver jusqu’à n/2 mots de code erronés et leurs valeurs correctes. Le décodeur de cette page le fait en trois étapes classiques de la théorie des codes : l’algorithme de Berlekamp-Massey trouve le polynôme localisateur d’erreurs le plus court (Massey, 1969), une recherche de Chien essaie chaque position pour trouver ses racines (Chien, 1964), et la formule de Forney donne l’amplitude de chaque erreur (Forney, 1965).
Il existe une autre règle. Dans les plus petits symboles, un décodeur qui corrigerait la totalité des n/2 erreurs aboutirait trop souvent à un bloc erroné mais valide. La norme réserve donc certains mots de code comme protection contre les erreurs de décodage : la version 1 en réserve 3 au niveau L, 2 au niveau M, 1 au niveau Q et 1 au niveau H, la version 2-L en réserve 2 et la version 3-L, 1. Un bloc peut alors corriger (n - p)/2 mots de code, où p est le nombre réservé. La version 1-L possède 7 mots de code de correction d’erreurs, mais en corrige 2, et non 3. Le laboratoire indique p à côté du nombre que chaque bloc peut corriger.
Un mot de code est erroné qu’un seul de ses bits soit faux ou que les huit le soient. C’est pourquoi les codes de Reed-Solomon conviennent aux taches et aux déchirures : un dommage couvrant une zone de modules détruit quelques mots de code entiers plutôt que de nombreux bits dispersés.
Blocs et entrelacement
Au-delà des plus petites versions, les mots de code sont répartis en blocs et chaque bloc reçoit ses propres mots de code de correction d’erreurs. La version 9 au niveau H possède 292 mots de code en 8 blocs. Quatre blocs ont 12 mots de code de données et quatre en ont 13, chacun avec 24 mots de code de correction d’erreurs, soit 100 mots de code de données et 192 pour la correction d’erreurs. Chaque bloc peut corriger 12 mots de code erronés ; le symbole entier peut donc corriger 96 de ses 292 mots de code.
Les blocs ne sont pas placés les uns après les autres. Le premier mot de code de données de chaque bloc vient d’abord, puis le deuxième de chaque bloc, et ainsi de suite, suivi de la même façon par les mots de code de correction d’erreurs. Activez Ordre de placement et les couleurs le montrent : les mots de code voisins sur le papier appartiennent à des blocs différents. Une tache de la taille de quelques mots de code coûte donc un ou deux mots de code à chacun de plusieurs blocs, plutôt que de les faire tous perdre à un seul bloc.
C’est ce que montre la main à l’ouverture. Les 16 colonnes sous la main modifient 96 mots de code, 12 dans chacun des 8 blocs. L’entrelacement répartit les dommages si régulièrement que les 8 blocs atteignent leur limite au même moment. Une colonne de plus ajoute des mots de code erronés à chaque bloc et ils échouent tous ensemble.
Peignez une seule tache d’encre et regardez les barres sous l’affichage : généralement, plusieurs blocs montent un peu. Le défi Surcharger un bloc vous demande de faire échouer exactement un bloc pendant que les autres survivent, ce qui demande plus d’attention qu’il n’y paraît, car l’entrelacement joue contre vous.
Placer les mots de code
Une fois les mots de code de données et de correction d’erreurs entrelacés, leurs bits sont placés dans le symbole selon un parcours fixe. Il commence au coin inférieur droit et remonte une paire de colonnes, le module de droite d’abord, puis celui de gauche, puis la ligne suivante vers le haut. En haut, il tourne et redescend la paire de colonnes suivante, et ainsi de suite à travers le symbole. Chaque motif fonctionnel est évité, et le motif de synchronisation vertical de la colonne 6 est entièrement sauté pour conserver l’alignement des paires.
Ce parcours explique certaines choses visibles sur la scène. Les quatre premiers bits, l’indicateur de mode, se trouvent toujours dans le coin inférieur droit. La plupart des mots de code occupent un bloc de modules de 2 sur 4, mais là où le parcours tourne en haut ou en bas, ou contourne un motif d’alignement, un mot de code prend d’autres formes. Cliquez sur un module près du coin inférieur droit et sa fiche vous indique qu’il fait partie de l’indicateur de mode.
Lorsque les mots de code ne remplissent pas exactement la zone de données, les modules restants sont des bits résiduels : 7 dans les versions 2 à 6, 3 dans les versions 14 à 20 et 28 à 34, 4 dans les versions 21 à 27, et aucun dans les autres. Ils sont clairs avant le masquage et le lecteur les ignore.
Masques et points de pénalité
Un symbole qui vient d’être rempli peut présenter de grandes zones sombres, de longues séquences ou, par malchance, une zone de données ressemblant à un motif de position. Chacune rend la lecture plus difficile. L’encodeur applique donc un masque : il inverse chaque module de données pour lequel une règle portant sur sa ligne i et sa colonne j est vraie. Il existe huit règles, de (i + j) modulo 2 = 0, un damier, à ((i + j) modulo 2 + (i j) modulo 3) modulo 2 = 0. Les motifs fonctionnels ne sont jamais masqués.
L’encodeur essaie les huit et évalue chaque résultat avec quatre sortes de points de pénalité définis par la norme. Chaque séquence d’au moins 5 modules de la même couleur dans une ligne ou une colonne coûte 3 points, plus 1 pour chaque module au-delà de 5. Chaque bloc de 2 sur 2 d’une seule couleur coûte 3 points. Chaque motif ressemblant à un motif de position, 1011101 avec 4 modules clairs d’un côté, coûte 40 points. Et la proportion de modules sombres coûte 10 points pour chaque écart de 5 % par rapport à la moitié. Le masque ayant le moins de points l’emporte et son numéro entre dans les informations de format.
Le laboratoire dessine les huit versions de votre symbole côte à côte avec leurs scores. Choisissez un autre masque avec la commande Masque et le code reste lisible, car le lecteur prend le numéro du masque dans les informations de format. C’est aussi pourquoi deux générateurs peuvent produire des codes d’apparence différente à partir du même texte tout en étant corrects. La FAQ de DENSO WAVE le souligne aussi : des données identiques peuvent donner des motifs différents selon le mode et d’autres choix.
Afficher le masque teinte en orange chaque module que le masque actuel inverse. Comparez avec la règle dans le laboratoire : c’est la même règle, appliquée à toute la zone de données.
Ce que signifie réellement 30 %
DENSO WAVE présente les quatre niveaux comme permettant de restaurer environ 7 %, 15 %, 25 % et 30 % des mots de code, et précise que le niveau M est le plus courant. Deux mots de cette phrase comptent : environ et mots de code.
Environ, parce que la proportion varie selon la version. Calculé comme le nombre de mots de code que tous les blocs peuvent corriger ensemble, divisé par le total, le niveau L varie de 7,7 % à 10,5 % dans les versions 1 à 40, M de 15,4 % à 19,2 %, Q de 23,1 % à 28,0 % et H de 30,8 % à 33,2 %. Le tableau du laboratoire donne la valeur exacte pour la version sur la scène.
Mots de code, parce qu’un cache se mesure en surface et qu’une surface ne se traduit pas simplement en mots de code. Un cache sur le bord d’un mot de code le détruit aussi sûrement qu’un cache sur sa totalité. Un cache qui tombe sur des modules clairs ne change rien, car une main ou une bande de papier est lue comme du clair : sur la scène, la main sur 30,2 % des modules n’en modifie qu’environ 16 %. Un cache sur les motifs fonctionnels ne coûte pas de mots de code, mais peut faire perdre les motifs de position, la synchronisation ou les informations de format.
Voici donc le bilan honnête. Au niveau H, le symbole peut survivre à un cache sur environ 30 % de sa surface si le cache se trouve sur les données et si les blocs se partagent régulièrement les dommages, comme le font les 16 colonnes de la main. La même surface disposée sur des lignes plutôt que des colonnes, 16 lignes à 30,2 %, n’est pas lisible à la version 9. Un cache de 3,2 % au mauvais endroit l’arrête. Le défi Le casser avec moins de 10 % sert à trouver cet endroit.
DENSO WAVE décrit le choix du niveau en termes pratiques : Q ou H pour les usines où les codes se salissent, L pour les lieux propres avec beaucoup de données. Pour un système de portes palières sur des lignes de Tokyo, où les codes sur les portes des trains sont exposés au soleil et à la pluie, DENSO indique avoir développé un code spécial, tQR, qui tolère 50 % de dommages.
Comment un téléphone trouve et lit le code
La norme décrit un algorithme de décodage de référence, et les lecteurs réels en suivent l’ordre même si leurs détails diffèrent. Le questionnaire du laboratoire vous demande de remettre les étapes dans l’ordre.
L’image est d’abord transformée en noir et blanc. Les lecteurs réels choisissent un seuil pour chaque partie de l’image, car un code sur une canette brillante ou sous une lampe de bureau n’est pas éclairé uniformément. Viennent ensuite les motifs de position, trouvés par le balayage 1:1:3:1:1 décrit plus haut. À partir des trois centres, le lecteur estime la taille des modules et l’orientation, puis la version à partir de la distance entre les motifs de position. Pour la version 7 et au-delà, il lit les informations de version pour confirmer. Il cherche un motif d’alignement près de la position attendue du quatrième coin et ajuste une transformation de perspective, qui associe chaque module de la grille à l’image.
Il échantillonne ensuite le centre de chaque module et lit les informations de format. Parmi les 32 mots de code de format valides, il prend le plus proche de ce qu’il a lu, en essayant les deux copies si nécessaire. Il obtient ainsi le niveau et le masque. Il retire le masque en inversant à nouveau les mêmes modules, suit le parcours de placement pour recueillir les mots de code, les répartit à nouveau en blocs, corrige chaque bloc et décode enfin le flux de bits : mode, nombre, caractères, jusqu’au terminateur ou à l’épuisement des données.
La scène simplifie deux de ces étapes. Le téléphone effectue la recherche des motifs de position sur de vrais pixels, tournés par la commande Rotation et avec ou sans marge, mais il ne courbe ni n’incline l’image ; le lecteur échantillonne ensuite la grille à des positions connues au lieu d’ajuster une perspective. Et les caches sont traités comme clairs : une main est lue comme du papier blanc, le ruban noir comme sombre. Une véritable caméra verrait l’ombre d’une main et la texture de la peau, et pourrait faire mieux ou moins bien.
DENSO WAVE donne une autre limite pratique sans rapport avec le code : la couleur. Ses scanners éclairent le code en rouge ; un code rouge sur du papier blanc réfléchit donc autant de rouge que le papier et disparaît. L’entreprise recommande le noir sur blanc.
Codes-barres, Micro QR et rMQR
Le code-barres que le code QR devait améliorer est celui du commerce : UPC en Amérique du Nord, EAN-13 ailleurs. Norman Woodland et Bernard Silver ont déposé le premier brevet d’un code lu optiquement en 1949 ; il a été délivré le 7 octobre 1952. Selon l’Office européen des brevets, le premier passage d’un UPC en caisse concernait un paquet de chewing-gum dans un supermarché de l’Ohio en 1974, et un tel code-barres contient environ 20 caractères au maximum.
Un code-barres EAN-13 mesure 95 modules de large : un motif de garde de 3 modules à chaque extrémité et de 5 au milieu, et 12 chiffres de 7 modules chacun. Le treizième chiffre n’est pas imprimé sous forme de barres ; il est encodé dans le choix entre deux motifs pour les chiffres de gauche. Le dernier chiffre est un chiffre de contrôle : les chiffres reçoivent alternativement les coefficients 1 et 3, et le chiffre de contrôle rend le total multiple de 10. Cela détecte la plupart des erreurs, mais n’en corrige aucune. Placez le code-barres sur le chevalet avec Comparer et couvrez sa moitié supérieure : il reste lisible, car un scanner n’a besoin que d’une ligne intacte traversant toutes les barres. Couvrez une bande verticale et il ne l’est plus.
Micro QR, approuvé comme norme JIS en novembre 2004, suit la voie inverse. Il supprime deux motifs de position et en conserve un, utilise une marge de deux modules et existe en quatre tailles : M1 mesure 11 modules sur 11 et contient 5 chiffres, M4 mesure 17 sur 17 et en contient jusqu’à 35. Il n’a que quatre masques, ses informations de format contiennent un numéro de symbole de 3 bits au lieu du niveau et, dans M1 et M3, le dernier mot de code de données ne mesure que 4 bits. Le chevalet montre une version Micro QR de votre texte s’il y tient, avec la même taille de module que le symbole sur la table. Même M4 contient moins que la version 1 du code complet.
En mai 2022, l’ISO a publié le code Micro QR rectangulaire, rMQR, pour les étiquettes longues et étroites. DENSO WAVE le décrit comme utilisant un motif de position et demi, à partir de 7 modules sur 43, avec jusqu’à 361 chiffres dans 17 modules sur 139. DENSO WAVE a aussi publié iQR, une famille plus grande comprenant des symboles rectangulaires, Frame QR avec un espace vide pour une image, et SQRC, qui restreint l’accès à une partie des données. Des chercheurs sont allés plus loin : Chu et ses collègues ont montré en 2013 comment produire un code ressemblant à une image en demi-teintes et restant lisible, en plaçant les détails de l’image à l’intérieur de chaque module et en s’appuyant sur la correction d’erreurs.
Ce qui distingue le modèle des codes et lecteurs réels
L’encodeur couvre entièrement ce que la norme appelle Modèle 2 pour les segments numériques, alphanumériques, octets et ECI, les versions 1 à 40, les quatre niveaux et les huit masques. Il utilise un segment par texte au lieu de mélanger les modes, ce qu’un encodeur soigneux ferait pour économiser des bits. Le mode kanji est limité aux kana, car la table Shift JIS complète est volumineuse ; pour ces caractères, les bits sont les mêmes que ceux d’un encodeur complet. L’ajout structuré, qui répartit un message sur un maximum de 16 symboles, n’est pas implémenté.
Le lecteur de la scène lit la grille à des positions connues. Il vérifie les motifs de position selon le nombre de leurs modules qui subsistent et exige les trois, comme la plupart des lecteurs de téléphone. Il décode les informations de format et de version exactement comme le prescrit la norme, retire le masque, corrige chaque bloc par décodage de Reed-Solomon, y compris la protection contre les erreurs de décodage, et analyse le flux de bits. Un lecteur réel doit aussi affronter le flou, les reflets, la perspective et l’impression qui fait déborder les modules sombres dans les modules clairs ; la scène ne présente rien de tout cela.
La recherche des motifs de position du téléphone travaille sur les pixels et tourne avec le symbole, mais l’image est nette et plate. Les outils de peinture et de taches marquent des modules entiers. Le symbole mesure toujours 30 cm de large sur la table pour être visible ; les codes réels mesurent généralement quelques centimètres.
Les nombres de l’affichage proviennent tous du code sur la table. Les deux lecteurs indépendants utilisés pour la vérification (une bibliothèque libre en JavaScript et une autre en C++) ont lu les 320 symboles de test des versions 1 à 10 à chaque niveau et avec chaque masque, les 120 symboles des versions 11 à 40, les symboles Micro QR des huit combinaisons de taille et de niveau et les codes-barres EAN-13.
Une courte histoire
DENSO WAVE, alors une division de DENSO, a commencé à développer le code QR en 1992. Les usines automobiles passaient à de nombreux modèles produits en petites séries, et les pièces étaient expédiées avec environ 10 codes-barres par produit ; les étiquettes tachées d’huile étaient illisibles. DENSO indique que l’équipe de développement comptait deux personnes. Le travail a pris environ un an et demi. Le code a été annoncé en 1994 et pouvait contenir environ 7000 chiffres, encoder des kanji et être lu plus de 10 fois plus vite que les autres codes, selon DENSO WAVE. L’Office européen des brevets, en attribuant à l’équipe le prix du public du Prix de l’inventeur européen en 2014, a évalué cette vitesse à environ 20 fois celle des codes matriciels antérieurs.
Le nom signifie « quick response », mais DENSO WAVE précise que le nom officiel est QR Code, et non un acronyme. Le brevet a été déposé au Japon le 14 mars 1994 et délivré sous le numéro 2938338 ; l'équivalent américain, le brevet 5,726,435, cite Masahiro Hara, Motoaki Watabe, Tadao Nojiri, Takayuki Nagaya et Yuji Uchiyama comme inventeurs. DENSO WAVE conserve le brevet mais déclare ne pas l’exercer pour les codes QR normalisés, une politique qui, selon l’entreprise, existait dès le départ. QR Code est une marque déposée de DENSO WAVE pour le terme, et non pour le motif.
L’industrie automobile a adopté le code en premier pour le kanban électronique, les fiches qui déclenchent l’approvisionnement en pièces. Après des crises alimentaires comme l’ESB, les fabricants d’aliments, de médicaments et de lentilles de contact l’ont utilisé pour tracer leurs produits. Les normes ont suivi : AIM International en octobre 1997, JEIDA-55 en mars 1998, JIS X 0510 en janvier 1999 et ISO/IEC 18004 en juin 2000. L’édition actuelle, la quatrième, a été publiée en août 2024.
Des téléphones capables de lire les codes QR ont été commercialisés au Japon en 2002 et ont fait sortir le code des usines. En décembre 2011, GS1, l’organisme responsable des codes-barres du commerce, l’a approuvé pour les téléphones mobiles. EMVCo a publié des spécifications de paiement QR en juillet 2017 ; Singapour a réuni 27 systèmes de paiement dans une étiquette SGQR le 17 septembre 2018 ; le Brésil a lancé Pix avec 734 établissements le 16 novembre 2020. Pendant la COVID-19, la Corée a utilisé les codes QR pour les registres d’entrée à partir du 10 juin 2020, l’Angleterre et le pays de Galles ont placé des affiches QR du NHS aux portes des lieux recevant du public à partir du 24 septembre 2020, et le certificat COVID numérique de l’UE, un code QR signé, a été utilisé du 1er juillet 2021 au 30 juin 2023. Les commerçants prévoient désormais que les caisses liront les codes 2D d’ici la fin de 2027.
Questions
Un code QR peut-il vraiment être lu avec 30 % de sa surface couverte ?
Au niveau H, oui, si le cache se trouve sur les données et si les dommages se répartissent entre les blocs. Sur la scène, la main couvre 30,2 % des modules et le code reste lisible ; une colonne de plus, 32,1 %, et il ne l’est plus. La même surface sur 16 lignes au lieu de 16 colonnes n’est pas lisible à la version 9. Couvrir un motif de position arrête n’importe quel code.
Que signifient les niveaux L, M, Q et H ?
Ce sont les quatre niveaux de correction d’erreurs. DENSO WAVE les présente comme permettant de restaurer environ 7 %, 15 %, 25 % et 30 % des mots de code. Un niveau plus élevé nécessite davantage de mots de code de correction d’erreurs ; le même texte produit donc un symbole plus grand. DENSO WAVE indique que le niveau M est le plus souvent choisi.
Pourquoi y a-t-il trois carrés et non quatre ?
Trois points suffisent pour connaître la position, la taille et l’orientation d’un carré, et le coin formant l’angle droit indique au lecteur dans quel sens se trouve le code. Un quatrième repère identique donnerait au code le même aspect dans deux orientations. Le Modèle 2 ajoute un motif d’alignement plus petit près du quatrième coin pour corriger la perspective.
Quel est le petit carré près du coin inférieur droit ?
Un motif d’alignement. Les versions 2 à 6 en ont un ; les versions plus grandes en ont davantage, jusqu’à 46 dans les versions 35 à 40. Les lecteurs les utilisent pour suivre les codes imprimés sur des surfaces courbes ou photographiés de biais.
Pourquoi un code QR a-t-il besoin d’une bordure blanche ?
Les motifs de position sont trouvés grâce aux bandes sombre, claire, sombre, claire, sombre dans le rapport 1:1:3:1:1. Si le code est imprimé jusqu’à un bord sombre, l’anneau sombre extérieur fusionne avec lui et les bandes sont perdues. La norme demande une marge de quatre modules de large. Désactivez la zone de silence sur la scène pour voir le téléphone échouer.
Quelle est la capacité d’un code QR ?
La version 40 au niveau L contient 7089 chiffres, 4296 caractères alphanumériques, 2953 octets ou 1817 kanji. Pour les caméras de téléphone, DENSO WAVE suggère de prévoir environ 271 octets, la version 10 au niveau L.
Un code QR peut-il contenir du coréen ou du chinois ?
Oui. Le mode octet peut transporter n’importe quel jeu de caractères ; le lecteur doit savoir lequel. Un en-tête ECI portant le nombre 26 indique que les octets sont en UTF-8, et la scène l’ajoute pour tout texte qui n’est pas du simple ASCII. DENSO WAVE décrit aussi un mode de compression à 13 bits pour les caractères chinois GB2312, que certains téléphones peuvent ne pas lire.
Pourquoi deux générateurs QR produisent-ils des codes différents à partir du même texte ?
Ils peuvent choisir un mode différent, ajouter ou omettre un en-tête ECI, choisir une version plus grande ou un masque différent. Tous ces choix sont valides et n’importe quel lecteur lira les deux codes. La FAQ de DENSO WAVE le précise également.
À quoi sert le masque ?
Il inverse les modules de données pour lesquels une règle fixe portant sur la ligne et la colonne est vraie, afin de casser les grands blocs, les longues séquences et les motifs ressemblant à des motifs de position. L’encodeur essaie les huit règles, attribue des points de pénalité à chaque résultat et utilise le meilleur. Le numéro du masque est enregistré dans les informations de format, ce qui permet au lecteur de l’annuler.
Le code QR est-il libre d’utilisation ?
Oui. DENSO WAVE déclare qu’aucune licence ni redevance n’est nécessaire pour utiliser des codes QR conformes aux normes JIS ou ISO. L’entreprise conserve son brevet mais ne l’exerce pas pour les codes normalisés. Les mots QR Code sont une marque déposée ; le motif ne l’est pas.
Quelle taille minimale peut-on imprimer pour un code QR ?
DENSO WAVE donne environ 0,17 mm comme taille minimale d’un module pour une imprimante laser ordinaire, soit environ 3,57 mm de large pour la version 1, et mentionne des modules de 0,03 mm avec des imprimantes et lecteurs spéciaux. L’entreprise avertit aussi que des codes très grands peuvent sortir du champ du lecteur.
Puis-je créer un code QR en couleur ?
Parfois. Les lecteurs ont besoin de contraste dans la lumière qu’ils utilisent. De nombreux scanners utilisent une lumière rouge : du rouge sur blanc disparaît donc, et un fond sombre avec un code clair peut perturber les lecteurs qui attendent des modules sombres. DENSO WAVE recommande le noir sur blanc et de tester toute autre solution.
Un code QR peut-il être dangereux ?
Le code lui-même n’est que des données. Le risque vient de sa destination : un code collé sur un véritable code peut vous envoyer vers une fausse page de paiement. Vérifiez l’adresse que le téléphone affiche avant de l’ouvrir, surtout pour les paiements.
Qu’est-ce qu’un code Micro QR ?
Un parent plus petit avec un seul motif de position et une marge de deux modules, en quatre tailles allant de 11 sur 11 à 17 sur 17 modules. Il contient jusqu’à 35 chiffres et est devenu une norme JIS en novembre 2004.
Pourquoi y a-t-il toujours un module sombre à côté du motif de position inférieur gauche ?
La norme le fixe à la ligne 4V + 9, colonne 8. Il se trouve dans la zone de format et ne contient aucune information ; chaque code QR d’une version donnée le possède donc au même endroit.
Le plateau de go a-t-il inspiré le code QR ?
L’histoire est souvent racontée. Dans l’entretien de DENSO de 2024, Masahiro Hara dit que l’idée d’un repère de position lui est venue dans un train, en regardant les fenêtres d’un bâtiment, et ne mentionne le go que pour expliquer pourquoi le fait de laisser utiliser le brevet a bien fonctionné. La grille elle-même est simplement ce dont un code bidimensionnel a besoin.
Vocabulaire
- Module : un carré de la grille, sombre ou clair.
- Version : la taille du symbole, de 1 (21 modules sur 21) à 40 (177 sur 177).
- Motif de position : l’un des trois carrés de 7 sur 7 dans les coins, avec le rapport 1:1:3:1:1.
- Séparateur : l’anneau clair d’un module de large autour de chaque motif de position.
- Motif de synchronisation : les modules alternés le long de la ligne 6 et de la colonne 6.
- Motif d’alignement : une cible de 5 sur 5 utilisée pour corriger la perspective et la courbure, à partir de la version 2.
- Zone de silence : la marge claire autour du symbole, large de quatre modules.
- Informations de format : 15 bits contenant le niveau de correction d’erreurs et le masque, protégés par un code BCH, écrits deux fois.
- Informations de version : 18 bits donnant la version, à partir de la version 7, écrits deux fois.
- Mot de code : un groupe de 8 bits, l’unité de correction d’erreurs.
- Bloc : un groupe de mots de code avec ses propres mots de code de correction d’erreurs.
- Niveau de correction d’erreurs : L, M, Q ou H ; le nombre de mots de code pouvant être restaurés.
- Code de Reed-Solomon : un code correcteur d’erreurs sur un corps de 256 éléments qui répare des mots de code entiers.
- Syndrome : la valeur du bloc reçu en une racine du générateur ; des valeurs toutes nulles signifient qu’aucune erreur n’a été trouvée.
- Masque : une règle qui inverse les modules de données pour éviter les motifs difficiles à lire.
- Mode : la manière dont les caractères sont regroupés en bits : numérique, alphanumérique, octet ou kanji.
- ECI : un en-tête qui nomme le jeu de caractères des octets suivants ; 26 signifie UTF-8.
- Octets de remplissage : 236 et 17, répétés pour remplir la capacité inutilisée.
- Bits résiduels : les modules restants après le dernier mot de code.
- Micro QR : un symbole plus petit avec un seul motif de position, des versions M1 à M4.
Sources
- ISO/IEC 18004:2024, Information technology, Automatic identification and data capture techniques, QR code bar code symbology specification, édition 4 (publiée le 15 août 2024). https://www.iso.org/standard/83389.html (consulté le 20 octobre 2026)
- ISO/IEC 18004:2015, édition 3 (retirée ; exemple détaillé de l’annexe I pour 01234567 en 1-M). https://www.iso.org/standard/62021.html (consulté le 20 octobre 2026)
- ISO/IEC 23941:2022, Rectangular Micro QR Code (rMQR) bar code symbology specification (publiée en mai 2022). https://www.iso.org/standard/77404.html (consulté le 20 octobre 2026)
- DENSO WAVE, History of QR Code (équipe de deux personnes, étude du rapport 1:1:3:1:1, environ 7000 chiffres, plus de 10 fois plus rapide, lancement en 1994, brevet non exercé, kanban, ESB, téléphones de 2002, AIM 1997, JIS 1999, ISO 2000, Micro QR 2004, iQR 2008, Frame QR 2014, Good Design Award 2012). https://www.qrcode.com/en/history/ (consulté le 20 octobre 2026)
- DENSO WAVE, Error correction feature (Reed-Solomon, mots de code, niveau M le plus courant, CD et sondes spatiales, erreurs en rafales). https://www.qrcode.com/en/about/error_correction.html (consulté le 20 octobre 2026)
- DENSO WAVE, Information capacity and versions of the QR Code (21 x 21 à 177 x 177, 4 modules par version, 100 chiffres au niveau M dans la version 3). https://www.qrcode.com/en/about/version.html (consulté le 20 octobre 2026)
- DENSO WAVE, QR Code standardization (AIM octobre 1997, JEIDA-55 mars 1998, JIS X 0510 janvier 1999, ISO/IEC 18004 juin 2000, Micro QR JIS novembre 2004, GS1 décembre 2011 ; capacités ; niveaux d’environ 7, 15, 25, 30 % ; ajout structuré sur 16 symboles ; brevet 2938338 non exercé). https://www.qrcode.com/en/about/standards.html (consulté le 20 octobre 2026)
- DENSO WAVE, Micro QR Code (un motif de position, marge de deux modules, M1 à M4, tableau des capacités, maximum de 35 chiffres). https://www.qrcode.com/en/codes/microqr.html (consulté le 20 octobre 2026)
- DENSO WAVE, QR Code Model 1 and Model 2 (Modèle 1 version 14, 73 x 73, 1167 chiffres ; Modèle 2 motifs d’alignement, version 40, 7089 chiffres). https://www.qrcode.com/en/codes/model12.html (consulté le 20 octobre 2026)
- DENSO WAVE, rMQR Code (un motif de position et demi, de 7 x 43 à 17 x 139, 361 chiffres, ISO mai 2022). https://www.qrcode.com/en/codes/rmqr.html (consulté le 20 octobre 2026)
- DENSO WAVE, Point for determining the code area (marge de quatre modules, 50 caractères au niveau M dans la version 3, 0,254 mm, 9,398 mm). https://www.qrcode.com/en/howto/code.html (consulté le 20 octobre 2026)
- DENSO WAVE, Point for setting the module size (densité de la tête d’impression, 0,17 mm à 600 dpi avec 4 points). https://www.qrcode.com/en/howto/cell.html (consulté le 20 octobre 2026)
- DENSO WAVE, FAQ (pas un acronyme, assiettes à sushi et livres de poche, 3,57 mm et 0,03 mm, 271 octets pour les téléphones, mode chinois à 13 bits, lumière rouge, mêmes données et motifs différents, marque déposée uniquement pour le terme, aucune redevance). https://www.qrcode.com/en/faq.html (consulté le 20 octobre 2026)
- DENSO WAVE, QR Code development story (début en 1992, environ 1000 codes-barres par jour, deux membres, motifs de détection de position). https://www.denso-wave.com/en/technology/vol1.html (consulté le 20 octobre 2026)
- DENSO WAVE, QR Code 30th anniversary (première mission pour les pièces automobiles, lisible avec des taches d’huile). https://www.denso-wave.com/en/system/qr/qr30th/ (consulté le 20 octobre 2026)
- DENSO DRIVEN BASE, Believing in a faint light: obstacles QR Code developer overcame and the source of his idea (entretien avec Masahiro Hara, en mai 2024 : développement à partir de 1992, environ 10 codes-barres par produit, rapport trouvé après environ six mois, fenêtres d’un bâtiment vues d’un train, go comme loisir). https://www.denso.com/global/en/driven-base/career-life/qr-hara_2408/ (consulté le 20 octobre 2026)
- DENSO DRIVEN BASE, QR codes powering digital transformation (tQR pour les portes palières, tolérance aux dommages portée de 30 % à 50 %), 25 février 2025. https://www.denso.com/global/en/driven-base/career-life/qr_engineer-1/ (consulté le 20 octobre 2026)
- European Patent Office, Masahiro Hara, Motoaki Watabe, Tadao Nojiri, Takayuki Nagaya, Yuji Uchiyama, European Inventor Award 2014, prix du public (première lecture UPC en 1974, environ 20 caractères, 20 fois plus rapide). https://www.epo.org/en/news-events/european-inventor-award/meet-the-finalists/masahiro-hara-motoaki-watabe-tadao-nojiri (consulté le 20 octobre 2026)
- Brevet japonais JP 2938338 B2, 2D code, déposé le 14 mars 1994, délivré en 1999 (Google Patents). https://patents.google.com/patent/JP2938338B2/en (consulté le 20 octobre 2026)
- Brevet américain 5,726,435, Optically readable two-dimensional code and method and apparatus using the same, délivré le 10 mars 1998 (Google Patents). https://patents.google.com/patent/US5726435A/en (consulté le 20 octobre 2026)
- Brevet américain 2,612,994, N. J. Woodland et B. Silver, Classifying apparatus and method, déposé le 20 octobre 1949, délivré le 7 octobre 1952 (Google Patents). https://patents.google.com/patent/US2612994A/en (consulté le 20 octobre 2026)
- I. S. Reed et G. Solomon, Polynomial codes over certain finite fields, Journal of the Society for Industrial and Applied Mathematics 8(2), 300 à 304, 1960. https://doi.org/10.1137/0108018 (consulté le 20 octobre 2026)
- R. C. Bose et D. K. Ray-Chaudhuri, On a class of error correcting binary group codes, Information and Control 3(1), 1960. https://doi.org/10.1016/S0019-9958(60)90287-4 (consulté le 20 octobre 2026)
- J. L. Massey, Shift-register synthesis and BCH decoding, IEEE Transactions on Information Theory 15(1), 1969. https://doi.org/10.1109/TIT.1969.1054260 (consulté le 20 octobre 2026)
- R. T. Chien, Cyclic decoding procedures for Bose-Chaudhuri-Hocquenghem codes, IEEE Transactions on Information Theory 10(4), 1964. https://doi.org/10.1109/TIT.1964.1053699 (consulté le 20 octobre 2026)
- G. D. Forney, On decoding BCH codes, IEEE Transactions on Information Theory 11(4), 1965. https://doi.org/10.1109/TIT.1965.1053825 (consulté le 20 octobre 2026)
- H.-K. Chu, C.-S. Chang, R.-R. Lee et N. J. Mitra, Halftone QR codes, ACM Transactions on Graphics 32(6), 2013. https://doi.org/10.1145/2508363.2508408 (consulté le 20 octobre 2026)
- EMVCo, EMVCo publishes QR code payment specifications to promote global interoperability, 31 juillet 2017. https://www.emvco.com/wp-content/uploads/news/EMVCo-QR-Code-Specification-Launch-FINAL-v1.pdf (consulté le 20 octobre 2026)
- EMVCo, EMV QR Codes. https://www.emvco.com/emv-technologies/qr-codes (consulté le 20 octobre 2026)
- Monetary Authority of Singapore, Singapore introduces world's first unified payment QR code, SGQR, 17 septembre 2018. https://www.mas.gov.sg/news/media-releases/2018/singapore-introduces-worlds-first-unified-payment-qr-code (consulté le 20 octobre 2026)
- Banco Central do Brasil, Pix starts its full operation with 734 institutions on November 16, 2020. https://www.bcb.gov.br/en/pressdetail/2361/nota (consulté le 20 octobre 2026)
- Ministry of Health and Welfare (Korea), blog officiel, KI-Pass electronic entry logs nationwide from 10 June, juin 2020. https://blog.naver.com/mohw2016/221995921830 (consulté le 20 octobre 2026)
- GOV.UK, Businesses urged to prepare for NHS COVID-19 app, 11 septembre 2020 (lancement et enregistrement QR le 24 septembre). https://www.gov.uk/government/news/businesses-urged-to-prepare-for-nhs-covid-19-app (consulté le 20 octobre 2026)
- Council of the European Union, EU digital COVID certificate: how it works (1er juillet 2021 au 30 juin 2023, code QR avec signature numérique). https://www.consilium.europa.eu/en/policies/coronavirus-pandemic/eu-digital-covid-certificate (consulté le 20 octobre 2026)
- IATA, Bar Coded Boarding Pass (BCBP) implementation guide, version 7, 2021 (PDF417, Aztec, DataMatrix, code QR ; codes-barres 1D limités à environ 30 caractères). https://www.iata.org/contentassets/1dccc9ed041b4f3bbdcf8ee8682e75c4/2021_03_02-bcbp-implementation-guide-version-7-.pdf (consulté le 20 octobre 2026)
- GS1 US, What is GS1 Sunrise 2027? https://www.gs1us.org/industries-and-insights/by-topic/sunrise-2027 (consulté le 20 octobre 2026)
- GS1, GS1 Digital Link. https://www.gs1.org/standards/gs1-digital-link (consulté le 20 octobre 2026)
- GS1, GS1 barcodes. https://www.gs1.org/standards/barcodes (consulté le 20 octobre 2026)
Textes et simulations : CC BY-NC-SA 4.0, sauf mention contraire.
D'autres expositions
Comment fonctionne la machine Enigma
Appuyez cinq fois sur A d’une Enigma réglée sur I-II-III et AAA : les lampes allument B, D, Z, G, O.
Caractères mobiles et presse à imprimer
Un caractère porte sa lettre à l’envers. Encrez-le, posez une feuille dessus, pressez, retournez-la, et la lettre se lit dans le bon sens.
Machine à écrire mécanique interactive : touche, ruban
Sur une machine à écrire pica, chaque lettre, espace et point fait avancer le chariot des mêmes 2,54 mm vers la gauche.
Braille : apprendre à lire et écrire, tester les signaux
Un point braille mesure 1,5 mm. Six points sur une grille de 2 par 3 donnent 64 motifs communs au braille coréen, anglais, japonais et musical.
Comment fonctionne une imprimante 3D, couche par couche
Un cube de 20 mm imprimé en couches de 0,2 mm compte exactement 100 couches, chacune tracée par une buse de 0,4 mm de large.
Combien de satellites autour de la Terre et quand les voir
Le 20 octobre 2026, le catalogue public recensait 16 768 satellites opérationnels, dont deux sur trois appartenaient au réseau internet d’une seule entreprise.