FIG. 102Sentidos
Código QR: cómo se lee
Tapa el 30 % de un código QR con la mano y un teléfono sigue leyéndolo. Tapa una esquina y deja de leerlo.
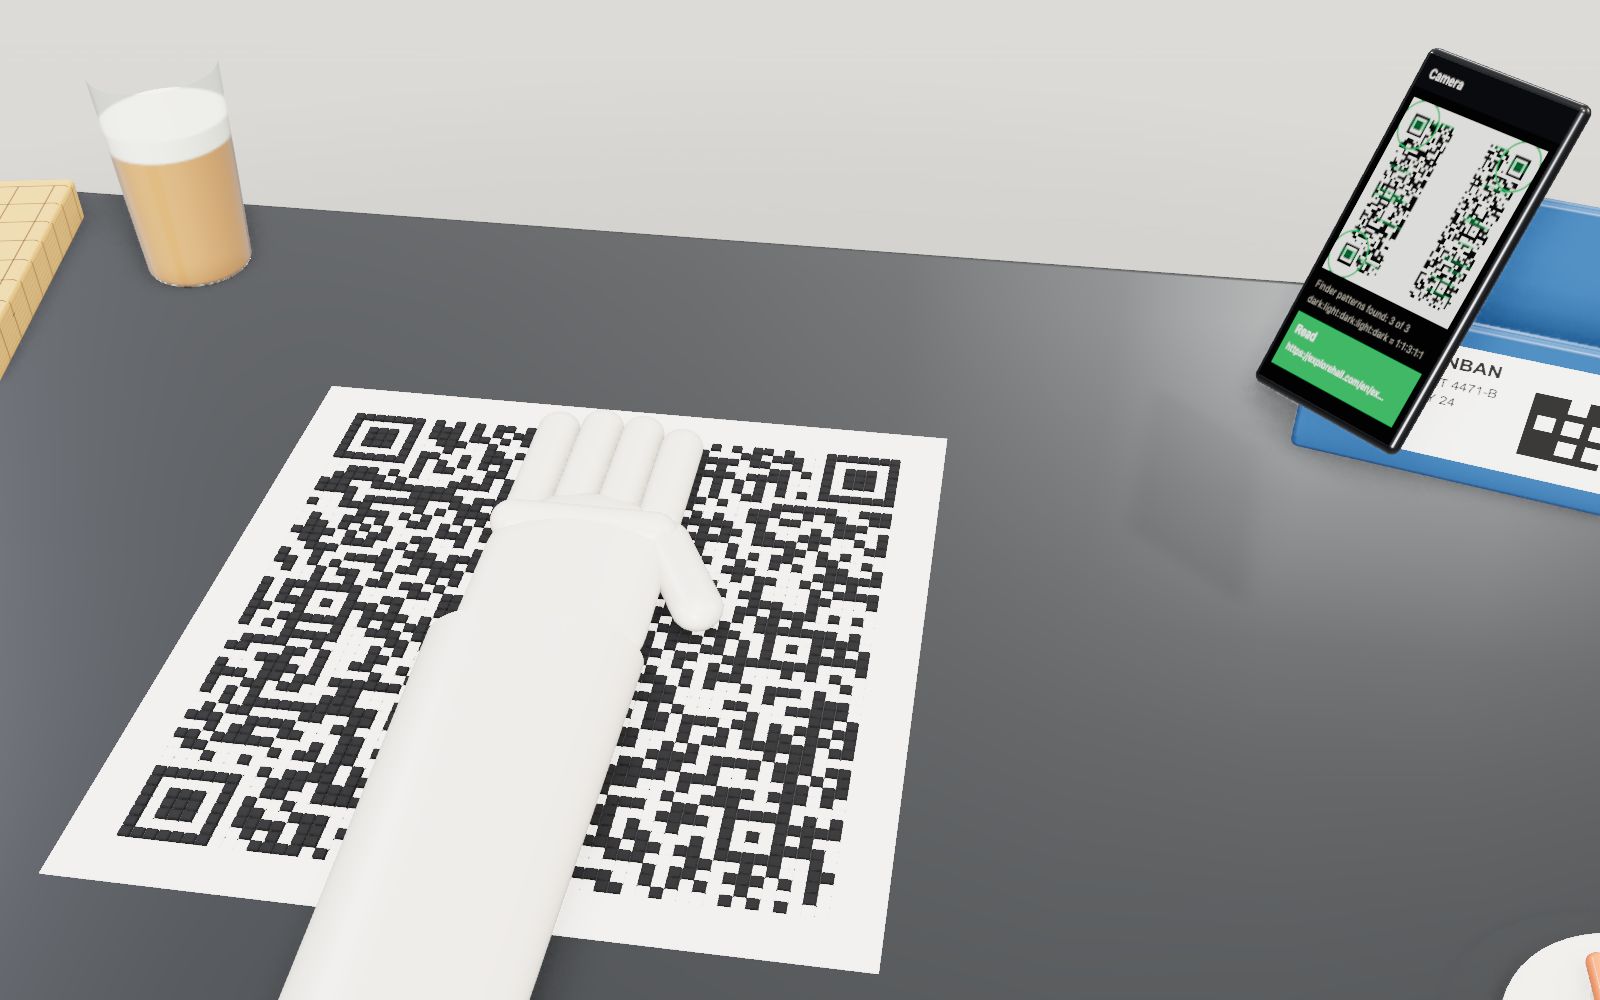
Este dispositivo no puede mostrar el modelo 3D. Abajo puedes leer los pasos de la guía como texto.
1 / 20 30 % bajo una manoEste es tu texto como código QR de nivel H, versión 9: 53 x 53 módulos. Una mano de maniquí se desliza sobre él. Observa el indicador y el teléfono de la derecha: el código sigue leyéndose mientras la mano tapa alrededor del 30 % de los módulos.
Arrastra para girar. Usa la rueda o pellizca para ampliar.
Un código que puedes tapar con la mano
Acerca un teléfono a un código QR y lo leerá en un instante, incluso si se ha despegado una etiqueta, se ha doblado una esquina o hay un pulgar en medio. Prueba a hacer lo mismo con el código de barras de una caja de cereales y la caja registradora te responderá con un pitido. La diferencia no está en la cámara. Un código QR contiene palabras de código adicionales que permiten al lector reconstruir lo que no ve, y lleva tres marcas que permiten encontrarlo desde cualquier ángulo antes siquiera de empezar.
El escenario se abre con tu propio texto, o con la dirección de esta página, convertido en un código QR de nivel H y versión 9: un cuadrado de 53 por 53 módulos sobre una mesa de exposición. Una mano de maniquí se desliza desde el borde y se detiene cuando tapa 16 de las 53 columnas. Son 848 de los 2809 módulos, el 30,2 % del símbolo. El indicador sigue diciendo «Se lee», y el teléfono de la derecha sigue encontrando el código y mostrando tu texto. Cada uno de los 8 bloques de corrección de errores del símbolo está entonces en su límite: 12 palabras de código erróneas en cada uno, y 12 es el máximo que un bloque de este tamaño puede corregir. Amplía la cobertura una columna más, hasta el 32,1 %, y la lectura se detiene.
Ahora rasga una esquina. El triángulo rasgado representa solo el 3,2 % del símbolo, mucho menos de lo que tapaba la mano, pero ya no se lee nada. El resto de esta página explica por qué ocurren ambas cosas, con las cifras que utiliza el escenario. Proceden de las reglas de ISO/IEC 18004, la norma internacional del código QR, y de lo que DENSO WAVE, la empresa que lo desarrolló en 1994, ha publicado sobre su diseño.
El símbolo de la mesa no es una imagen de un código QR. Se codifica en la página a partir del texto del recuadro, módulo a módulo, con la misma aritmética Reed-Solomon que utilizaría un controlador de impresora, y se vuelve a leer con un decodificador que sigue los pasos de referencia de la norma. Puedes guardar el símbolo sin daños como imagen y leerlo con tu propio teléfono. El codificador se comprobó con dos lectores independientes y con un segundo codificador: en 160 combinaciones de versión y nivel, las matrices coincidieron módulo a módulo.
Cómo usar el escenario
Escribe en el recuadro de la parte inferior del escenario y el símbolo se reconstruirá mientras escribes. El indicador de la esquina superior izquierda muestra primero el resultado («Se lee», o «No se lee» con el motivo), después la versión y el tamaño, el nivel de corrección de errores, la máscara y sus puntos de penalización, el modo y la cantidad de bits que necesita tu texto, las palabras de código, cuánto está tapado y cuántas palabras de código son ahora erróneas. Las barras pequeñas que aparecen debajo son los bloques de corrección de errores: cada una se llena conforme sus palabras de código erróneas se acercan al máximo que puede corregir y se vuelve roja cuando lo supera.
La pantalla del teléfono de la derecha muestra lo que haría una cámara con la imagen: una línea roja recorre la imagen de arriba abajo, las marcas verdes señalan cada fila donde las franjas coinciden con 1:1:3:1:1, y los círculos muestran si se han encontrado los tres patrones de posición. Debajo, el teléfono muestra el texto o el motivo por el que ha abandonado la lectura.
En los controles, «Versión» establece la versión mínima que se utilizará (el codificador agranda el símbolo si tu texto no cabe), «Corrección de errores» selecciona L, M, Q o H, y «Máscara» impone una de las ocho máscaras en vez de la que tiene menos puntos de penalización. «Ancho de cobertura» y «Posición de cobertura» mueven la mano, y «Cobertura» la sustituye por una tira de papel o cinta negra. «Elevar por función» eleva los módulos en capas según lo que hacen; «Color por función» los colorea sin elevarlos. «Orden de colocación» dibuja el recorrido de los bits y colorea las palabras de código por bloque. «Mostrar máscara» tiñe los módulos que invierte la máscara. «Giro» gira el símbolo sobre la mesa. «Comparación» coloca un código de barras EAN-13 o un símbolo Micro QR en el caballete, o cuelga las versiones de la 1 a la 40 en la pared. «Zona de silencio» elimina el margen blanco.
«Pintar» te permite arrastrar sobre el símbolo con tinta, líquido corrector, un agujero o una goma de borrar. «Rasgar esquina» y «Manchas de aceite» son formas rápidas de dañarlo. «Hora actual» llena el símbolo con la hora actual y lo redibuja cada segundo. Pulsa cualquier módulo para ver qué es: su fila y columna, su función y, en los módulos de datos, el bloque, la palabra de código y el bit a los que pertenece. Algunos módulos y algunos objetos de la mesa abren fichas ocultas.
Debajo de los controles encontrarás tu texto escrito en bits, las palabras de código de cada bloque en hexadecimal, una tabla de los cuatro niveles para la versión actual, las ocho máscaras una junto a otra, una tabla de versiones, 12 tareas, 46 casos, fichas que empiezan con «En realidad», una colección y enlaces a exposiciones relacionadas.
Cuadrados en tres esquinas
Lo más difícil de leer un código bidimensional no son los datos. Es encontrar el código en una imagen de cámara llena de otras cosas, averiguar su orientación y el tamaño de cada módulo. Un código de barras es fácil de encontrar: basta con que lo cruce un láser o una fila de píxeles. Un código matricial debe encontrarse en dos dimensiones.
La respuesta de DENSO WAVE fueron los tres cuadrados de las esquinas, que la norma llama patrones de posición. Cada uno mide 7 por 7 módulos: un anillo oscuro, un anillo claro y un centro oscuro de 3 por 3. Una línea que atraviese el centro en cualquier dirección cruza oscuro, claro, oscuro, claro y oscuro con anchos de 1, 1, 3, 1 y 1. La proporción no cambia al girar el código, cambiar su escala o verlo en ángulo, de modo que un lector puede recorrer filas de píxeles, conservar las últimas cinco secuencias oscuras y claras y comprobar si coinciden.
¿Por qué esa proporción? Según DENSO WAVE, los desarrolladores redujeron a patrones de blanco y negro imágenes y caracteres impresos en folletos, revistas y cajas de cartón, y contaron qué proporciones aparecían. La que menos aparecía en el material impreso era 1:1:3:1:1. En una entrevista publicada por DENSO en 2024, Masahiro Hara, que dirigió el trabajo, dijo que encontrarla llevó unos seis meses, fotografiando periódicos y revistas página por página y dejando el programa de medición funcionando durante la noche.
El teléfono del escenario hace exactamente esto con los píxeles que ve. Recorre cada fila, cuenta secuencias y acepta cinco cuyos anchos se desvíen menos de medio módulo de 1:1:3:1:1. Para cada coincidencia comprueba la misma proporción en vertical por el centro de la secuencia central. Las coincidencias que concuerdan se convierten en posibles centros. Después necesita tres de ellos, y el que forma un ángulo recto entre los otros dos es la esquina superior izquierda. Ese ángulo también indica al lector cuánto se ha girado el código. Gira el símbolo con «Giro» y observa cómo los círculos siguen las esquinas.
Una zona de datos puede formar las mismas franjas por casualidad. Los lectores descartan estas coincidencias aisladas porque la cuadrícula que implican no encaja. El escenario solo cuenta un patrón de posición como encontrado cuando la detección coincide con el verdadero.
Separadores, margen y mesa oscura
La prueba 1:1:3:1:1 solo funciona si el anillo oscuro exterior tiene zonas claras a ambos lados. Dentro del símbolo lo garantizan los separadores: un anillo claro de un módulo de ancho alrededor de cada patrón de posición. Fuera del símbolo, esa es la función de la zona de silencio, un margen claro que la norma exige que tenga cuatro módulos de ancho por cada lado.
En el escenario, el símbolo está impreso en una hoja de papel cuyo margen mide exactamente cuatro módulos. La mesa de debajo es de pizarra oscura. Desactiva «Zona de silencio» y el margen del papel desaparece, por lo que el anillo exterior de cada patrón de posición se une directamente con la mesa oscura. Ahora una fila que atraviesa un patrón se lee como una larga secuencia oscura seguida de claro, oscuro, claro y oscuro: la primera secuencia tiene muchos módulos de ancho y la proporción falla. El teléfono no encuentra ningún patrón de posición y el indicador dice «No se lee, falta un patrón de posición». Los datos no han cambiado en absoluto.
Las recomendaciones de impresión de DENSO WAVE incluyen el margen en el tamaño de la etiqueta. Su ejemplo utiliza 50 caracteres alfanuméricos en el nivel M, que requieren la versión 3 (29 módulos; la versión 2 en el nivel M solo admite 38). Con una impresora de 400 dpi y 4 puntos por módulo, el módulo mide 0,254 mm, el símbolo 7,366 mm y, con 8 módulos de margen, el área de la etiqueta es un cuadrado de 9,398 mm de lado. Los códigos Micro QR, que solo tienen un patrón de posición, necesitan un margen de dos módulos en lugar de cuatro.
Una regla impresa en el código
La fila 6 y la columna 6 de cada código QR van de un patrón de posición al siguiente alternando oscuro y claro. Son los patrones de sincronización. Indican al lector dónde está cada columna y cada fila, algo importante cuando la impresión se ha estirado, el papel está ondulado o la cámara ve el código en ángulo. Un lector que conoce las posiciones de los patrones de posición puede estimar el tamaño del módulo, pero contar los módulos alternos proporciona el número exacto de módulos que hay entre ellos.
La cantidad de módulos también indica la versión. La versión V tiene 17 + 4V módulos de lado, de modo que la versión 1 mide 21 por 21 y la versión 40 mide 177 por 177. En el escenario, el símbolo siempre ocupa los mismos 30 cm de papel, por lo que el módulo se reduce al aumentar la versión: 5,7 mm en la versión 9 y 1,7 mm en la versión 40.
Como los patrones de sincronización están dentro del símbolo, también ocupan módulos que podrían contener datos. En la versión 1, los patrones funcionales (patrones de posición, separadores, sincronización, información de formato y módulo oscuro) dejan 208 módulos para palabras de código: 26 palabras de código de 8 bits.
Dianas para el papel curvado
El primer código QR de 1994, llamado ahora Modelo 1, no tenía otras guías. DENSO WAVE indica que el Modelo 1 llegaba hasta la versión 14, con 73 por 73 módulos y 1167 dígitos. El Modelo 2, que es el código QR que se utiliza hoy, añadió patrones de alineación para que pudieran seguir leyéndose códigos impresos sobre superficies curvas o vistos desde un ángulo muy inclinado. También amplió el intervalo hasta la versión 40 y 7089 dígitos.
Un patrón de alineación es una pequeña diana de 5 por 5: un anillo oscuro, un anillo claro y un módulo central oscuro. La versión 1 no tiene ninguno. Las versiones de la 2 a la 6 tienen uno, cerca de la esquina inferior derecha, las versiones de la 7 a la 13 tienen seis y la cantidad aumenta hasta 46 en las versiones de la 35 a la 40. Sus centros se sitúan en una cuadrícula de filas y columnas indicada en la norma; se utilizan las mismas posiciones para filas y columnas, y se omiten los tres lugares donde se superpondrían a un patrón de posición. El escenario calcula estas posiciones a partir de la versión: para la versión 9 son 6, 26 y 46, lo que da 3 x 3 = 9 lugares menos 3 = 6 patrones.
Un lector que ha encontrado los tres patrones de posición conoce tres esquinas del código. La cuarta esquina no está marcada, así que el lector la estima y después busca el patrón de alineación más próximo para corregir la estimación. Con ese cuarto punto puede deshacer la perspectiva de una fotografía inclinada. En un símbolo grande, varios patrones de alineación permiten al lector seguir una página abombada.
Quince bits que indican cómo leer el resto
Antes de leer cualquier dato, el lector necesita saber dos cosas: el nivel de corrección de errores y cuál de las ocho máscaras se ha aplicado. Ocupan 5 bits: 2 para el nivel (L es 01, M es 00, Q es 11 y H es 10) y 3 para el número de máscara.
Esos 5 bits están mucho más protegidos que los datos. Se amplían a 15 bits mediante un código BCH, los códigos de corrección de errores hallados por Bose y Ray-Chaudhuri en 1960 y, de forma independiente, por Hocquenghem en 1959. Los 10 bits de comprobación son el resto de dividir los 5 bits, desplazados 10 posiciones a la izquierda, entre el polinomio x^10 + x^8 + x^5 + x^4 + x^2 + x + 1. Dos cualesquiera de las 32 posibles palabras de código de 15 bits difieren en al menos 7 bits, de modo que un lector puede elegir la más próxima incluso cuando hay 3 bits erróneos.
Después se aplica XOR a los 15 bits con el patrón fijo 101010000010010. Sin él, el nivel M con la máscara 0 serían 15 módulos claros y el lector no podría distinguir la información de formato del papel en blanco.
La información de formato se escribe dos veces: una alrededor del patrón de posición superior izquierdo y otra repartida entre los otros dos, con 8 bits junto al superior derecho y 7 junto al inferior izquierdo. Si una cobertura oculta una copia, la otra sigue funcionando. Pulsa un módulo de formato en el escenario y se abrirá la ficha oculta; rasga la esquina superior izquierda y solo sobrevivirá una copia, pero para entonces también habrá desaparecido el patrón de posición.
Junto a la copia inferior izquierda hay un módulo que es oscuro en todos los códigos QR: el módulo oscuro, en la fila 4V + 9 y la columna 8. Pertenece al área de formato y no contiene información.
Versiones de la 1 a la 40
Los símbolos pequeños no necesitan indicar su versión: el lector cuenta los módulos. En un símbolo grande, un pequeño error al estimar el tamaño del módulo daría un recuento incorrecto, por lo que a partir de la versión 7 la versión se escribe de forma explícita. Los seis bits del número de versión se amplían a 18 mediante otro código BCH, generado por x^12 + x^11 + x^10 + x^9 + x^8 + x^5 + x^2 + 1, y se colocan dos veces, en un bloque de 6 por 3 junto al patrón de posición superior derecho y otro de 3 por 6 junto al inferior izquierdo. La versión 7 se escribe como 000111110010010100 y la versión 40 como 101000110001101001. También aquí pueden corregirse 3 bits erróneos.
La capacidad de una versión depende del nivel y del tipo de caracteres. Las tablas de DENSO WAVE dan para la versión 1 en el nivel L una capacidad de 41 dígitos, 25 caracteres alfanuméricos, 17 bytes o 10 kanji, y para la versión 1 en el nivel H, 17 dígitos, 10 caracteres alfanuméricos, 7 bytes o 4 kanji. En el otro extremo, la versión 40 en el nivel L admite 7089 dígitos, 4296 caracteres alfanuméricos, 2953 bytes o 1817 kanji. El codificador de esta página reproduce esas cifras, y la tabla del laboratorio las ofrece para cada versión en el nivel actual, junto con el ancho impreso para cualquier tamaño de módulo que introduzcas.
DENSO WAVE recomienda no exigir a los teléfonos que lean demasiado: ofrece unos 271 bytes, versión 10 en el nivel L, como cifra práctica para cámaras de teléfono, según el modelo. Cuelga las versiones en la pared con «Comparación» para ver por qué. Con el tamaño de módulo de la mesa, la versión 40 supera el metro de ancho.
Del texto a los bits
El texto que escribes no entra en el código en forma de letras. Entra como una secuencia de bits formada por segmentos, y cada segmento empieza con un indicador de modo de 4 bits.
El modo numérico (0001) empaqueta los dígitos de tres en tres en 10 bits, porque 1000 combinaciones caben en 1024. Un último grupo de dos dígitos ocupa 7 bits y un solo dígito, 4. El modo alfanumérico (0010) abarca 45 caracteres: los dígitos, las letras mayúsculas, el espacio y $ % * + - . / :. Empaqueta dos caracteres en 11 bits como 45 x primero + segundo, porque 45 x 45 = 2025 cabe en 2048, y un último carácter aislado en 6 bits. El modo byte (0100) utiliza 8 bits por byte. El modo kanji (1000) toma un carácter Shift JIS de dos bytes y lo comprime en 13 bits, razón por la que el código QR pudo contener texto japonés de forma compacta desde el principio.
Después del indicador de modo viene un recuento de caracteres. Su longitud depende del modo y de la versión: para las versiones de la 1 a la 9 son 10 bits en numérico, 9 en alfanumérico, 8 en byte y 8 en kanji; las versiones mayores utilizan recuentos más largos. Después vienen los caracteres. Al final, el codificador añade hasta 4 bits cero como terminador, ceros hasta el siguiente límite de byte y, después, los bytes de relleno 11101100 y 00010001 (236 y 17) alternadamente hasta completar la capacidad de datos.
La norma incluye un ejemplo resuelto: los ocho dígitos 01234567 en la versión 1, nivel M. Modo 0001, recuento 0000001000 (ocho), después 012 como 0000001100, 345 como 0101011001 y 67 como 1000011. Con el terminador y el relleno, las 16 palabras de código de datos son, en hexadecimal, 10 20 0C 56 61 80 EC 11 EC 11 EC 11 EC 11 EC 11. El codificador de esta página produce exactamente esos bytes y las palabras de código de corrección de errores que la norma enumera a continuación.
El modo byte no indica a qué juego de caracteres pertenecen los bytes. Las ediciones de la norma a partir de 2006 establecen ISO 8859-1 como valor predeterminado; la primera edición de 2000 utilizaba un juego japonés de 8 bits. Para otros textos, el codificador puede añadir una cabecera ECI (Extended Channel Interpretation, modo 0111) con el número 26, que significa UTF-8. El escenario la añade siempre que tu texto contiene algo distinto del ASCII básico, de modo que el coreano o los emoji llegan intactos. Escribe kana japoneses y el codificador cambia al modo kanji, con 13 bits por carácter en lugar de los 24 de UTF-8.
El laboratorio muestra tu propio texto dividido en estos segmentos, con sus cantidades de bits. Una URL en mayúsculas puede utilizar el modo alfanumérico y ahorrar casi un tercio de los bits, una de las razones por las que algunos códigos impresos utilizan direcciones en mayúsculas.
Reed-Solomon en un código QR
A las palabras de código de datos les siguen palabras de código de corrección de errores procedentes de un código Reed-Solomon, el código que Irving Reed y Gustave Solomon describieron en cinco páginas en 1960. DENSO WAVE lo describe como un método matemático utilizado en los CD de música, desarrollado inicialmente contra el ruido en las comunicaciones con satélites y sondas planetarias, que corrige a nivel de bytes y resulta adecuado para errores que llegan en ráfagas.
La aritmética se realiza en un cuerpo de 256 elementos, uno por cada valor de byte. Sumar dos bytes es aplicar XOR. Para multiplicarlos se utiliza una tabla construida a partir del polinomio x^8 + x^4 + x^3 + x^2 + 1, que la norma fija para el código QR. Un bloque de palabras de código de datos se interpreta como los coeficientes de un polinomio, se multiplica por x^n y se divide entre un polinomio generador que tiene las n raíces 1, a, a^2 hasta a^(n-1). El resto proporciona las n palabras de código de corrección de errores. Así, el bloque completo, datos más resto, es múltiplo del generador, por lo que al evaluarlo en cada una de las n raíces da cero.
Un lector evalúa el bloque recibido en esas raíces. Si todos los resultados, llamados síndromes, son cero, el bloque no tiene errores. De lo contrario, los síndromes contienen suficiente información para encontrar hasta n/2 palabras de código erróneas y sus valores correctos. El decodificador de esta página lo hace en tres pasos habituales en la teoría de códigos: el algoritmo de Berlekamp-Massey encuentra el polinomio localizador de errores más corto (Massey, 1969), una búsqueda de Chien prueba cada posición para encontrar sus raíces (Chien, 1964), y la fórmula de Forney da la magnitud de cada error (Forney, 1965).
Hay otra regla. En los símbolos más pequeños, un decodificador que corrigiera los n/2 errores completos llegaría con demasiada frecuencia a un bloque válido pero incorrecto. Por eso, la norma reserva algunas palabras de código como protección contra la decodificación incorrecta: la versión 1 reserva 3 en el nivel L, 2 en M, 1 en Q y 1 en H, la versión 2-L reserva 2 y la versión 3-L reserva 1. Un bloque puede entonces corregir (n - p)/2 palabras de código, donde p es la cantidad reservada. La versión 1-L tiene 7 palabras de código de corrección de errores, pero corrige 2, no 3. El laboratorio indica p junto al número que puede corregir cada bloque.
Una palabra de código es errónea tanto si tiene un bit incorrecto como si tiene los ocho. Por eso los códigos Reed-Solomon son adecuados para manchas y rasgaduras: los daños que cubren una zona de módulos estropean unas pocas palabras de código completas en vez de muchos bits dispersos.
Bloques y entrelazado
En cualquier versión superior a las más pequeñas, las palabras de código se dividen en bloques y cada bloque recibe sus propias palabras de código de corrección de errores. La versión 9 en el nivel H tiene 292 palabras de código en 8 bloques. Cuatro bloques tienen 12 palabras de código de datos y cuatro tienen 13, cada uno con 24 palabras de código de corrección de errores, lo que suma 100 palabras de código de datos y 192 de corrección de errores. Cada bloque puede corregir 12 palabras de código erróneas, de modo que el símbolo completo puede corregir 96 de sus 292 palabras de código.
Los bloques no se colocan uno detrás de otro. Primero va la primera palabra de código de datos de cada bloque, luego la segunda de cada bloque y así sucesivamente, seguidas del mismo modo por las palabras de código de corrección de errores. Activa «Orden de colocación» y los colores lo muestran: las palabras de código vecinas en el papel pertenecen a bloques distintos. Por eso, una mancha del tamaño de unas pocas palabras de código cuesta a cada uno de varios bloques una o dos palabras de código, en vez de costárselas todas a un solo bloque.
Eso es lo que muestra la mano inicial. Las 16 columnas bajo la mano cambian 96 palabras de código, 12 en cada uno de los 8 bloques. El entrelazado reparte los daños de forma tan uniforme que los 8 bloques llegan a su límite a la vez. Una columna más añade palabras de código erróneas a cada bloque y todos fallan juntos.
Pinta una sola mancha de tinta y observa las barras bajo el indicador: normalmente suben un poco varios bloques. La tarea «Sobrecargar un bloque» te pide que hagas fallar exactamente un bloque mientras los demás sobreviven, lo que exige más cuidado de lo que parece, porque el entrelazado actúa en tu contra.
Colocación de las palabras de código
Una vez entrelazadas las palabras de código de datos y de corrección de errores, sus bits se colocan en el símbolo siguiendo un recorrido fijo. Empieza en la esquina inferior derecha y sube por un par de columnas, primero el módulo derecho, después el izquierdo y luego la siguiente fila superior. Arriba gira y baja por el siguiente par de columnas, y así sucesivamente a través del símbolo. Se omiten todos los patrones funcionales y se salta por completo el patrón de sincronización vertical de la columna 6 para mantener los pares coordinados.
El recorrido explica algunas cosas que puedes ver en el escenario. Los primeros cuatro bits, el indicador de modo, siempre están en la esquina inferior derecha. La mayoría de las palabras de código ocupan un bloque de módulos de 2 por 4, pero donde el recorrido gira arriba o abajo, o rodea un patrón de alineación, la palabra de código adopta otras formas. Pulsa un módulo cerca de la esquina inferior derecha y su ficha te indicará que forma parte del indicador de modo.
Cuando las palabras de código no llenan exactamente el área de datos, los módulos sobrantes son bits de resto: 7 en las versiones de la 2 a la 6, 3 en las versiones de la 14 a la 20 y de la 28 a la 34, 4 en las versiones de la 21 a la 27 y ninguno en las demás. Son claros antes del enmascaramiento y el lector los ignora.
Máscaras y puntos de penalización
Un símbolo recién colocado puede tener grandes zonas oscuras, secuencias largas o, por mala suerte, una zona de datos que parezca un patrón de posición. Cualquiera de ellas dificulta la lectura. Por eso el codificador aplica una máscara: invierte cada módulo de datos donde se cumple una regla sobre su fila i y su columna j. Hay ocho reglas, desde (i + j) mod 2 = 0, un tablero de ajedrez, hasta ((i + j) mod 2 + (i j) mod 3) mod 2 = 0. Los patrones funcionales nunca se enmascaran.
El codificador prueba las ocho y puntúa cada resultado con cuatro tipos de penalizaciones de la norma. Cada secuencia de 5 o más módulos del mismo color en una fila o columna cuesta 3 puntos, más 1 por cada módulo que supere los 5. Cada bloque de 2 por 2 de un mismo color cuesta 3. Cada patrón que parezca un patrón de posición, 1011101 con 4 módulos claros a un lado, cuesta 40. Y la proporción de módulos oscuros cuesta 10 puntos por cada 5 % que se aleje de la mitad. Gana la máscara con menos puntos y su número se incorpora a la información de formato.
El laboratorio dibuja las ocho versiones de tu símbolo una junto a otra con sus puntuaciones. Elige otra máscara con el control «Máscara» y el código seguirá leyéndose, porque el lector toma el número de máscara de la información de formato. Por eso también dos generadores pueden producir códigos de aspecto distinto a partir del mismo texto y ser ambos correctos. Las FAQ de DENSO WAVE señalan lo mismo: unos datos idénticos pueden dar patrones diferentes según el modo y otras decisiones.
«Mostrar máscara» tiñe de naranja cada módulo que invierte la máscara actual. Compáralo con la regla del laboratorio: es la misma regla, aplicada a toda el área de datos.
Qué significa realmente el 30 %
DENSO WAVE presenta los cuatro niveles como capaces de recuperar aproximadamente el 7 %, el 15 %, el 25 % y el 30 % de las palabras de código, e indica que el nivel M es el más común. En esa frase importan dos expresiones: aproximadamente y palabras de código.
Aproximadamente, porque la proporción cambia de una versión a otra. Calculado como la cantidad de palabras de código que todos los bloques juntos pueden corregir, dividida entre el total, el nivel L va del 7,7 % al 10,5 % entre las versiones de la 1 a la 40, M del 15,4 % al 19,2 %, Q del 23,1 % al 28,0 % y H del 30,8 % al 33,2 %. La tabla del laboratorio ofrece la cifra exacta para la versión del escenario.
Palabras de código, porque una cobertura se mide en superficie y la superficie no se traduce de forma simple en palabras de código. Una cobertura sobre el borde de una palabra de código la estropea igual que una que la tape por completo. Una cobertura sobre módulos claros no cambia nada, porque una mano o una tira de papel se leen como claro: en el escenario, la mano sobre el 30,2 % de los módulos solo cambia aproximadamente el 16 % de ellos. Una cobertura sobre patrones funcionales no cuesta palabras de código, pero puede hacer perder los patrones de posición, la sincronización o la información de formato.
Así que el resumen fiel es este. En el nivel H, el símbolo puede sobrevivir a una cobertura de alrededor del 30 % de su superficie si esta atraviesa los datos y los bloques se reparten los daños uniformemente, como ocurre con las 16 columnas de la mano. La misma superficie aplicada sobre filas en vez de columnas, 16 filas con el 30,2 %, no se lee en la versión 9. Una cobertura del 3,2 % en el lugar equivocado lo detiene. La tarea «Romper con menos del 10 %» sirve para encontrar ese lugar.
DENSO WAVE describe la elección del nivel en términos prácticos: Q o H para fábricas donde los códigos se ensucian, L para lugares limpios con muchos datos. Para un sistema de puertas de andén en líneas de Tokio, donde los códigos de las puertas de los trenes están expuestos al sol y la lluvia, DENSO afirma haber desarrollado un código especial, tQR, que tolera un 50 % de daños.
Cómo encuentra y lee el código un teléfono
La norma describe un algoritmo de decodificación de referencia, y los lectores reales siguen su orden aunque difieran en los detalles. El cuestionario del laboratorio te pide que ordenes los pasos.
Primero, la imagen se convierte en blanco y negro. Los lectores reales eligen un umbral para cada parte de la imagen, porque un código en una lata brillante o bajo una lámpara de escritorio no recibe una iluminación uniforme. Después vienen los patrones de posición, encontrados mediante el barrido 1:1:3:1:1 descrito antes. A partir de los tres centros, el lector estima el tamaño del módulo y la orientación y, después, la versión a partir de la distancia entre los patrones de posición. En la versión 7 y superiores lee la información de versión para confirmarla. Busca un patrón de alineación cerca de la posición prevista de la cuarta esquina y ajusta una transformación de perspectiva, que proyecta cada módulo de la cuadrícula sobre la imagen.
A continuación toma una muestra del centro de cada módulo y lee la información de formato. De las 32 palabras de código de formato válidas toma la más próxima a lo que ha leído, probando ambas copias si hace falta. Así obtiene el nivel y la máscara. Retira la máscara invirtiendo de nuevo los mismos módulos, recorre el orden de colocación para recoger las palabras de código, las reorganiza en bloques, corrige cada bloque y, por último, decodifica la secuencia de bits: modo, recuento, caracteres, hasta encontrar el terminador o agotar los datos.
El escenario simplifica dos de estos pasos. El teléfono busca los patrones de posición en píxeles reales, girados con el control «Giro» y con o sin margen, pero no curva ni inclina la imagen, y después el lector toma muestras de la cuadrícula en posiciones conocidas en vez de ajustar una perspectiva. Además, las coberturas se interpretan como claras: una mano se lee como papel blanco y la cinta negra como oscuro. Una cámara real vería la sombra de una mano y la textura de la piel, y podría hacerlo mejor o peor.
DENSO WAVE ofrece otro límite práctico que no tiene nada que ver con el código: el color. Sus escáneres iluminan el código con luz roja, por lo que un código rojo sobre papel blanco refleja tanta luz roja como el papel y desaparece. Recomienda negro sobre blanco.
Códigos de barras, Micro QR y rMQR
El código de barras que el código QR pretendía mejorar es el de venta minorista: UPC en Norteamérica y EAN-13 en otros lugares. Norman Woodland y Bernard Silver solicitaron la primera patente de un código de lectura óptica en 1949, concedida el 7 de octubre de 1952. Según la Oficina Europea de Patentes, el primer escaneo UPC en una caja registradora fue el de un paquete de chicles en un supermercado de Ohio en 1974, y un código de barras de este tipo admite unos 20 caracteres como máximo.
Un código de barras EAN-13 tiene 95 módulos de ancho: un patrón de guarda de 3 módulos en cada extremo y de 5 en el centro, y 12 dígitos de 7 módulos cada uno. El decimotercer dígito no se imprime como barras; se codifica mediante la elección entre dos patrones para los dígitos de la izquierda. El último dígito es de control: los dígitos se ponderan alternadamente por 1 y 3, y el dígito de control hace que el total sea múltiplo de 10. Eso detecta la mayoría de los errores, pero no puede corregir ninguno. Coloca el código de barras en el caballete con «Comparación» y tapa su mitad superior: seguirá leyéndose, porque un escáner solo necesita una línea limpia que cruce todas las barras. Tapa una franja vertical y no se leerá.
Micro QR, aprobado como norma JIS en noviembre de 2004, toma el camino contrario. Elimina dos patrones de posición y conserva uno, utiliza un margen de dos módulos y se presenta en cuatro tamaños: M1 mide 11 por 11 módulos y admite 5 dígitos; M4 mide 17 por 17 y admite hasta 35. Solo tiene cuatro máscaras, su información de formato contiene un número de símbolo de 3 bits en lugar del nivel y, en M1 y M3, la última palabra de código de datos solo tiene 4 bits. El caballete muestra una versión Micro QR de tu texto si cabe, con el mismo tamaño de módulo que el símbolo de la mesa. Incluso M4 admite menos que la versión 1 del código completo.
En mayo de 2022, ISO publicó el código Micro QR rectangular, rMQR, para etiquetas largas y estrechas. DENSO WAVE lo describe como un código con un patrón de posición y medio, desde 7 por 43 módulos, con hasta 361 dígitos en 17 por 139 módulos. DENSO WAVE también ha publicado iQR, una familia mayor con símbolos rectangulares, Frame QR con un espacio vacío para una imagen y SQRC, que restringe quién puede leer una parte de los datos. Los investigadores han ido más lejos: Chu y sus colegas mostraron en 2013 cómo crear un código que parece una imagen de semitonos y sigue leyéndose, colocando el detalle de la imagen dentro de cada módulo y apoyándose en la corrección de errores.
En qué se diferencia el modelo de los códigos y lectores reales
El codificador abarca por completo lo que la norma llama Modelo 2 para segmentos numéricos, alfanuméricos, de bytes y ECI, versiones de la 1 a la 40, los cuatro niveles y las ocho máscaras. Utiliza un segmento por texto en lugar de mezclar modos, algo que haría un codificador cuidadoso para ahorrar bits. El modo kanji se limita a los kana, porque la tabla Shift JIS completa es grande; para esos caracteres, los bits son los mismos que los de un codificador completo. No se ha implementado la adición estructurada, que reparte un mensaje entre un máximo de 16 símbolos.
El lector del escenario lee la cuadrícula en posiciones conocidas. Comprueba los patrones de posición según cuántos de sus módulos sobreviven y exige los tres, como la mayoría de los lectores de teléfono. Decodifica la información de formato y de versión exactamente como indica la norma, retira la máscara, corrige cada bloque con decodificación Reed-Solomon incluida la protección contra la decodificación incorrecta y analiza la secuencia de bits. Un lector real también debe afrontar desenfoque, reflejos, perspectiva e impresiones que extienden los módulos oscuros hacia los claros; el escenario no incluye nada de eso.
La búsqueda de patrones de posición del teléfono funciona sobre píxeles y gira con el símbolo, pero la imagen está limpia y es plana. Las herramientas de pintura y manchas marcan módulos completos. El símbolo siempre mide 30 cm de ancho en la mesa para que pueda verse; los códigos reales suelen medir unos pocos centímetros.
Todas las cifras del indicador proceden del código de la mesa. Los dos lectores independientes utilizados en la comprobación (una biblioteca de código abierto en JavaScript y otra en C++) leyeron los 320 símbolos de prueba de las versiones de la 1 a la 10 en todos los niveles y máscaras, los 120 símbolos de las versiones de la 11 a la 40, símbolos Micro QR de los ocho tamaños y niveles, y códigos de barras EAN-13.
Una breve historia
DENSO WAVE, entonces una división de DENSO, empezó a desarrollar el código QR en 1992. Las fábricas de automóviles estaban pasando a fabricar muchos modelos en lotes pequeños, y las piezas se enviaban con unos 10 códigos de barras por producto; las etiquetas manchadas de aceite no podían leerse. DENSO indica que el equipo de desarrollo tenía dos personas. Tardaron aproximadamente un año y medio. El código se anunció en 1994 y podía contener unos 7000 dígitos, codificar kanji y leerse más de 10 veces más rápido que otros códigos, según DENSO WAVE. La Oficina Europea de Patentes, al conceder al equipo el Premio del Público del Premio al Inventor Europeo en 2014, cifró la velocidad en unas 20 veces la de los códigos matriciales anteriores.
El nombre significa «respuesta rápida», pero DENSO WAVE señala que el nombre oficial es QR Code, no una sigla. La patente se solicitó en Japón el 14 de marzo de 1994 y se concedió con el número 2938338; la correspondiente patente de EE. UU., 5,726,435, enumera como inventores a Masahiro Hara, Motoaki Watabe, Tadao Nojiri, Takayuki Nagaya y Yuji Uchiyama. DENSO WAVE conserva la patente, pero afirma que no la ejerce para códigos QR normalizados, una política que, según indica, estaba vigente desde el principio. QR Code es una marca registrada de DENSO WAVE para la expresión, no para el patrón.
La industria del automóvil adoptó primero el código para el kanban electrónico, las tarjetas que solicitan piezas. Tras alertas alimentarias como la EEB, los fabricantes de alimentos, medicamentos y lentes de contacto lo utilizaron para rastrear productos. Después llegaron las normas: AIM International en octubre de 1997, JEIDA-55 en marzo de 1998, JIS X 0510 en enero de 1999 e ISO/IEC 18004 en junio de 2000. La edición actual, la cuarta, se publicó en agosto de 2024.
Los teléfonos capaces de leer códigos QR salieron a la venta en Japón en 2002 y sacaron el código de las fábricas. En diciembre de 2011, GS1, el organismo responsable de los códigos de barras comerciales, lo aprobó para teléfonos móviles. EMVCo publicó especificaciones de pagos QR en julio de 2017; Singapur combinó 27 sistemas de pago en una etiqueta SGQR el 17 de septiembre de 2018; Brasil puso en marcha Pix con 734 instituciones el 16 de noviembre de 2020. Durante la COVID-19, Corea utilizó códigos QR para los registros de entrada desde el 10 de junio de 2020, Inglaterra y Gales colocaron carteles QR del NHS en las puertas de los establecimientos desde el 24 de septiembre de 2020, y el certificado COVID digital de la UE, un código QR firmado, estuvo en uso del 1 de julio de 2021 al 30 de junio de 2023. Los minoristas prevén ahora que las cajas registradoras lean códigos 2D para finales de 2027.
Preguntas
¿Se puede leer realmente un código QR con el 30 % tapado?
En el nivel H, sí, si la cobertura atraviesa los datos y los daños se reparten entre los bloques. En el escenario, la mano tapa el 30,2 % de los módulos y el código se lee; una columna más, el 32,1 %, y ya no. La misma superficie sobre 16 filas en vez de 16 columnas no se lee en la versión 9. Tapar un patrón de posición detiene cualquier código.
¿Qué significan los niveles L, M, Q y H?
Son los cuatro niveles de corrección de errores. DENSO WAVE los presenta como capaces de recuperar aproximadamente el 7 %, el 15 %, el 25 % y el 30 % de las palabras de código. Un nivel mayor necesita más palabras de código de corrección de errores, por lo que el mismo texto produce un símbolo más grande. DENSO WAVE afirma que el nivel M es el que se elige con más frecuencia.
¿Por qué hay tres cuadrados y no cuatro?
Tres puntos bastan para conocer la posición, el tamaño y la orientación de un cuadrado, y la esquina que forma el ángulo recto indica al lector cómo está orientado el código. Una cuarta marca idéntica haría que el código pareciera igual en dos orientaciones. El Modelo 2 añade un patrón de alineación más pequeño cerca de la cuarta esquina para corregir la perspectiva.
¿Qué es el cuadrado pequeño cerca de la esquina inferior derecha?
Un patrón de alineación. Las versiones de la 2 a la 6 tienen uno; las versiones mayores tienen más, hasta 46 en las versiones de la 35 a la 40. Los lectores los utilizan para seguir códigos impresos sobre superficies curvas o fotografiados en ángulo.
¿Por qué necesita un código QR un borde blanco?
Los patrones de posición se encuentran por sus franjas oscuro, claro, oscuro, claro y oscuro en la proporción 1:1:3:1:1. Si el código se imprime pegado a un borde oscuro, el anillo oscuro exterior se funde con él y las franjas desaparecen. La norma pide un margen de cuatro módulos de ancho. Desactiva la zona de silencio en el escenario para ver cómo falla el teléfono.
¿Cuánto puede contener un código QR?
La versión 40 en el nivel L admite 7089 dígitos, 4296 caracteres alfanuméricos, 2953 bytes o 1817 kanji. Para las cámaras de teléfono, DENSO WAVE recomienda prever unos 271 bytes, versión 10 en el nivel L.
¿Puede contener un código QR texto coreano o chino?
Sí. El modo byte puede transportar cualquier juego de caracteres; el lector debe saber cuál es. Una cabecera ECI con el número 26 indica que los bytes son UTF-8, y el escenario la añade para cualquier texto que no sea ASCII básico. DENSO WAVE también describe un modo de compactación de 13 bits para caracteres chinos GB2312, que algunos teléfonos podrían no leer.
¿Por qué dos generadores QR producen códigos diferentes con el mismo texto?
Pueden elegir un modo diferente, añadir u omitir una cabecera ECI, elegir una versión mayor o una máscara distinta. Todas estas opciones son válidas, y cualquier lector leerá ambos códigos. Las FAQ de DENSO WAVE señalan lo mismo.
¿Qué hace la máscara?
Invierte los módulos de datos donde se cumple una regla fija sobre la fila y la columna, para romper grandes bloques, secuencias largas y patrones que parecen patrones de posición. El codificador prueba las ocho reglas, puntúa cada resultado con puntos de penalización y utiliza la mejor. El número de máscara se guarda en la información de formato para que el lector pueda deshacerla.
¿Se puede utilizar gratis el código QR?
Sí. DENSO WAVE afirma que no se necesita licencia ni pago para utilizar códigos QR creados conforme a las normas JIS o ISO. Conserva su patente, pero no la ejerce para códigos normalizados. Las palabras QR Code son una marca registrada; el patrón no.
¿Hasta qué tamaño mínimo puede imprimirse un código QR?
DENSO WAVE da unos 0,17 mm como el módulo más pequeño para una impresora láser corriente, lo que hace que la versión 1 mida unos 3,57 mm de ancho, y menciona módulos de 0,03 mm con impresoras y lectores especiales. También advierte de que los códigos muy grandes podrían no caber en el campo de visión del lector.
¿Puedo hacer un código QR en color?
A veces. Los lectores necesitan contraste con la luz que utilizan. Muchos escáneres utilizan luz roja, por lo que el rojo sobre blanco desaparece, y un fondo oscuro con un código claro puede confundir a lectores que esperan módulos oscuros. DENSO WAVE recomienda negro sobre blanco y probar cualquier otra opción.
¿Puede ser peligroso un código QR?
El código en sí solo contiene datos. El riesgo está en adónde lleva: un código pegado sobre uno auténtico puede enviarte a una página de pago falsa. Comprueba la dirección que muestra el teléfono antes de abrirla, especialmente para los pagos.
¿Qué es un código Micro QR?
Un pariente más pequeño con un patrón de posición y un margen de dos módulos, en cuatro tamaños de 11 por 11 a 17 por 17 módulos. Admite hasta 35 dígitos y se convirtió en norma JIS en noviembre de 2004.
¿Por qué hay siempre un módulo oscuro junto al patrón de posición inferior izquierdo?
La norma lo fija en la fila 4V + 9, columna 8. Está en el área de formato y no contiene información, por lo que todos los códigos QR de una versión dada lo tienen en el mismo lugar.
¿Inspiró el tablero de go el código QR?
La historia se cuenta a menudo. En la entrevista de DENSO de 2024, Masahiro Hara dice que la idea de una marca de posición se le ocurrió en un tren, al mirar las ventanas de un edificio, y solo menciona el go al explicar por qué dio resultado ceder el uso de la patente. La cuadrícula en sí es simplemente lo que necesita un código bidimensional.
Términos
- Módulo: un cuadrado de la cuadrícula, oscuro o claro.
- Versión: el tamaño del símbolo, desde 1 (21 por 21 módulos) hasta 40 (177 por 177).
- Patrón de posición: uno de los tres cuadrados de 7 por 7 de las esquinas, con la proporción 1:1:3:1:1.
- Separador: el anillo claro de un módulo de ancho alrededor de cada patrón de posición.
- Patrón de sincronización: los módulos alternos de la fila 6 y la columna 6.
- Patrón de alineación: una diana de 5 por 5 utilizada para corregir la perspectiva y la curvatura, desde la versión 2.
- Zona de silencio: el margen claro que rodea el símbolo, de cuatro módulos de ancho.
- Información de formato: 15 bits con el nivel de corrección de errores y la máscara, protegidos por un código BCH y escritos dos veces.
- Información de versión: 18 bits que indican la versión, desde la versión 7, escritos dos veces.
- Palabra de código: un grupo de 8 bits, la unidad de corrección de errores.
- Bloque: un grupo de palabras de código con sus propias palabras de código de corrección de errores.
- Nivel de corrección de errores: L, M, Q o H; cuántas palabras de código pueden recuperarse.
- Código Reed-Solomon: un código de corrección de errores sobre un cuerpo de 256 elementos que repara palabras de código completas.
- Síndrome: el valor del bloque recibido en una raíz del generador; todos a cero significa que no se ha encontrado ningún error.
- Máscara: una regla que invierte módulos de datos para evitar patrones difíciles de leer.
- Modo: cómo se empaquetan los caracteres en bits: numérico, alfanumérico, byte o kanji.
- ECI: una cabecera que identifica el juego de caracteres de los bytes que siguen; 26 significa UTF-8.
- Bytes de relleno: 236 y 17, repetidos para llenar la capacidad sin utilizar.
- Bits de resto: módulos que sobran después de la última palabra de código.
- Micro QR: un símbolo más pequeño con un patrón de posición, versiones de M1 a M4.
Fuentes
- ISO/IEC 18004:2024, Information technology, Automatic identification and data capture techniques, QR code bar code symbology specification, edición 4 (publicada el 15 de agosto de 2024). https://www.iso.org/standard/83389.html (consultado el 20 de octubre de 2026)
- ISO/IEC 18004:2015, edición 3 (retirada; ejemplo resuelto de 01234567 en 1-M del anexo I). https://www.iso.org/standard/62021.html (consultado el 20 de octubre de 2026)
- ISO/IEC 23941:2022, Rectangular Micro QR Code (rMQR) bar code symbology specification (publicada en mayo de 2022). https://www.iso.org/standard/77404.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, History of QR Code (equipo de dos personas, estudio de 1:1:3:1:1, unos 7000 dígitos, más de 10 veces más rápido, lanzamiento de 1994, patente no ejercida, kanban, EEB, teléfonos de 2002, AIM 1997, JIS 1999, ISO 2000, Micro QR 2004, iQR 2008, Frame QR 2014, Good Design Award 2012). https://www.qrcode.com/en/history/ (consultado el 20 de octubre de 2026)
- DENSO WAVE, Error correction feature (Reed-Solomon, palabras de código, nivel M como el más común, CD y sondas espaciales, errores en ráfaga). https://www.qrcode.com/en/about/error_correction.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, Information capacity and versions of the QR Code (de 21 x 21 a 177 x 177, 4 módulos por versión, 100 dígitos en M en la versión 3). https://www.qrcode.com/en/about/version.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, QR Code standardization (AIM octubre de 1997, JEIDA-55 marzo de 1998, JIS X 0510 enero de 1999, ISO/IEC 18004 junio de 2000, Micro QR JIS noviembre de 2004, GS1 diciembre de 2011; capacidades; niveles de aproximadamente el 7, 15, 25, 30 %; adición estructurada de 16 símbolos; renuncia al ejercicio de la patente 2938338). https://www.qrcode.com/en/about/standards.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, Micro QR Code (un patrón de posición, margen de dos módulos, de M1 a M4, tabla de capacidad, máximo de 35 dígitos). https://www.qrcode.com/en/codes/microqr.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, QR Code Model 1 and Model 2 (Modelo 1 versión 14, 73 x 73, 1167 dígitos; patrones de alineación del Modelo 2, versión 40, 7089 dígitos). https://www.qrcode.com/en/codes/model12.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, rMQR Code (un patrón de posición y medio, de 7 x 43 a 17 x 139, 361 dígitos, ISO mayo de 2022). https://www.qrcode.com/en/codes/rmqr.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, Point for determining the code area (margen de cuatro módulos, 50 caracteres en M en la versión 3, 0,254 mm, 9,398 mm). https://www.qrcode.com/en/howto/code.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, Point for setting the module size (densidad del cabezal de impresión, 0,17 mm a 600 dpi con 4 puntos). https://www.qrcode.com/en/howto/cell.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, FAQ (no es una sigla, platos de sushi y libros de bolsillo, 3,57 mm y 0,03 mm, 271 bytes para teléfonos, modo chino de 13 bits, luz roja, mismos datos con patrones diferentes, marca registrada solo para la expresión, sin pago). https://www.qrcode.com/en/faq.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, QR Code development story (inicio en 1992, unos 1000 códigos de barras al día, dos miembros, patrones de detección de posición). https://www.denso-wave.com/en/technology/vol1.html (consultado el 20 de octubre de 2026)
- DENSO WAVE, QR Code 30th anniversary (primera misión con piezas de automóvil, legible con contaminación de aceite). https://www.denso-wave.com/en/system/qr/qr30th/ (consultado el 20 de octubre de 2026)
- DENSO DRIVEN BASE, Believing in a faint light: obstacles QR Code developer overcame and the source of his idea (entrevista con Masahiro Hara, a fecha de mayo de 2024: desarrollo desde 1992, unos 10 códigos de barras por producto, proporción encontrada tras unos seis meses, ventanas de edificios vistas desde un tren, go como afición). https://www.denso.com/global/en/driven-base/career-life/qr-hara_2408/ (consultado el 20 de octubre de 2026)
- DENSO DRIVEN BASE, QR codes powering digital transformation (tQR para puertas de andén, tolerancia a los daños aumentada del 30 % al 50 %), 25 de febrero de 2025. https://www.denso.com/global/en/driven-base/career-life/qr_engineer-1/ (consultado el 20 de octubre de 2026)
- European Patent Office, Masahiro Hara, Motoaki Watabe, Tadao Nojiri, Takayuki Nagaya, Yuji Uchiyama, European Inventor Award 2014, Popular Prize (primer escaneo UPC en 1974, unos 20 caracteres, 20 veces más rápido). https://www.epo.org/en/news-events/european-inventor-award/meet-the-finalists/masahiro-hara-motoaki-watabe-tadao-nojiri (consultado el 20 de octubre de 2026)
- Japan Patent JP 2938338 B2, 2D code, solicitada el 14 de marzo de 1994, concedida en 1999 (Google Patents). https://patents.google.com/patent/JP2938338B2/en (consultado el 20 de octubre de 2026)
- US Patent 5,726,435, Optically readable two-dimensional code and method and apparatus using the same, concedida el 10 de marzo de 1998 (Google Patents). https://patents.google.com/patent/US5726435A/en (consultado el 20 de octubre de 2026)
- US Patent 2,612,994, N. J. Woodland y B. Silver, Classifying apparatus and method, solicitada el 20 de octubre de 1949, concedida el 7 de octubre de 1952 (Google Patents). https://patents.google.com/patent/US2612994A/en (consultado el 20 de octubre de 2026)
- I. S. Reed y G. Solomon, Polynomial codes over certain finite fields, Journal of the Society for Industrial and Applied Mathematics 8(2), 300 a 304, 1960. https://doi.org/10.1137/0108018 (consultado el 20 de octubre de 2026)
- R. C. Bose y D. K. Ray-Chaudhuri, On a class of error correcting binary group codes, Information and Control 3(1), 1960. https://doi.org/10.1016/S0019-9958(60)90287-4 (consultado el 20 de octubre de 2026)
- J. L. Massey, Shift-register synthesis and BCH decoding, IEEE Transactions on Information Theory 15(1), 1969. https://doi.org/10.1109/TIT.1969.1054260 (consultado el 20 de octubre de 2026)
- R. T. Chien, Cyclic decoding procedures for Bose-Chaudhuri-Hocquenghem codes, IEEE Transactions on Information Theory 10(4), 1964. https://doi.org/10.1109/TIT.1964.1053699 (consultado el 20 de octubre de 2026)
- G. D. Forney, On decoding BCH codes, IEEE Transactions on Information Theory 11(4), 1965. https://doi.org/10.1109/TIT.1965.1053825 (consultado el 20 de octubre de 2026)
- H.-K. Chu, C.-S. Chang, R.-R. Lee y N. J. Mitra, Halftone QR codes, ACM Transactions on Graphics 32(6), 2013. https://doi.org/10.1145/2508363.2508408 (consultado el 20 de octubre de 2026)
- EMVCo, EMVCo publishes QR code payment specifications to promote global interoperability, 31 de julio de 2017. https://www.emvco.com/wp-content/uploads/news/EMVCo-QR-Code-Specification-Launch-FINAL-v1.pdf (consultado el 20 de octubre de 2026)
- EMVCo, EMV QR Codes. https://www.emvco.com/emv-technologies/qr-codes (consultado el 20 de octubre de 2026)
- Monetary Authority of Singapore, Singapore introduces world's first unified payment QR code, SGQR, 17 de septiembre de 2018. https://www.mas.gov.sg/news/media-releases/2018/singapore-introduces-worlds-first-unified-payment-qr-code (consultado el 20 de octubre de 2026)
- Banco Central do Brasil, Pix starts its full operation with 734 institutions on November 16, 2020. https://www.bcb.gov.br/en/pressdetail/2361/nota (consultado el 20 de octubre de 2026)
- Ministry of Health and Welfare (Korea), blog oficial, KI-Pass electronic entry logs nationwide from 10 June, junio de 2020. https://blog.naver.com/mohw2016/221995921830 (consultado el 20 de octubre de 2026)
- GOV.UK, Businesses urged to prepare for NHS COVID-19 app, 11 de septiembre de 2020 (lanzamiento y registro de entrada QR el 24 de septiembre). https://www.gov.uk/government/news/businesses-urged-to-prepare-for-nhs-covid-19-app (consultado el 20 de octubre de 2026)
- Council of the European Union, EU digital COVID certificate: how it works (del 1 de julio de 2021 al 30 de junio de 2023, código QR con firma digital). https://www.consilium.europa.eu/en/policies/coronavirus-pandemic/eu-digital-covid-certificate (consultado el 20 de octubre de 2026)
- IATA, Bar Coded Boarding Pass (BCBP) implementation guide, versión 7, 2021 (PDF417, Aztec, DataMatrix, código QR; códigos de barras 1D limitados a unos 30 caracteres). https://www.iata.org/contentassets/1dccc9ed041b4f3bbdcf8ee8682e75c4/2021_03_02-bcbp-implementation-guide-version-7-.pdf (consultado el 20 de octubre de 2026)
- GS1 US, What is GS1 Sunrise 2027? https://www.gs1us.org/industries-and-insights/by-topic/sunrise-2027 (consultado el 20 de octubre de 2026)
- GS1, GS1 Digital Link. https://www.gs1.org/standards/gs1-digital-link (consultado el 20 de octubre de 2026)
- GS1, GS1 barcodes. https://www.gs1.org/standards/barcodes (consultado el 20 de octubre de 2026)
Texto y simulación: CC BY-NC-SA 4.0, salvo que se indique lo contrario.
Más exposiciones
Máquina Enigma: simulador interactivo de rotores y clavijas
Pulsa A cinco veces en una Enigma con los rotores I-II-III en AAA y las lámparas encienden B, D, Z, G, O.
Los tipos móviles y la imprenta
Un tipo lleva su letra al revés. Entíntalo, apoya el papel, dale la vuelta a la hoja y la letra se lee en el sentido correcto.
Máquina de escribir: modelo interactivo por dentro
En una máquina de escribir pica, cada letra, espacio y punto mueve el carro los mismos 2,54 mm hacia la izquierda.
Braille: aprende a leer puntos y probar códigos de señales
Un punto braille mide 1,5 mm. Seis puntos en rejilla de 2 por 3 producen 64 patrones compartidos por braille coreano, inglés, japonés y musical.
Cómo funciona una impresora 3D, capa por capa
Un cubo de 20 mm impreso con capas de 0,2 mm tiene exactamente 100 capas, cada una dibujada por una boquilla de 0,4 mm de ancho.
Cuántos satélites hay en órbita y cuándo puedes verlos
El 20 de octubre de 2026 el catálogo público registraba 16 768 satélites operativos, y dos de cada tres pertenecían a la red de internet de una empresa.