图 26原理馆
逻辑门怎样相加:和位与进位
这块电路板用 20 个逻辑门计算 7 加 9,拨动开关后,最后的进位在 8 个门延迟后到达。
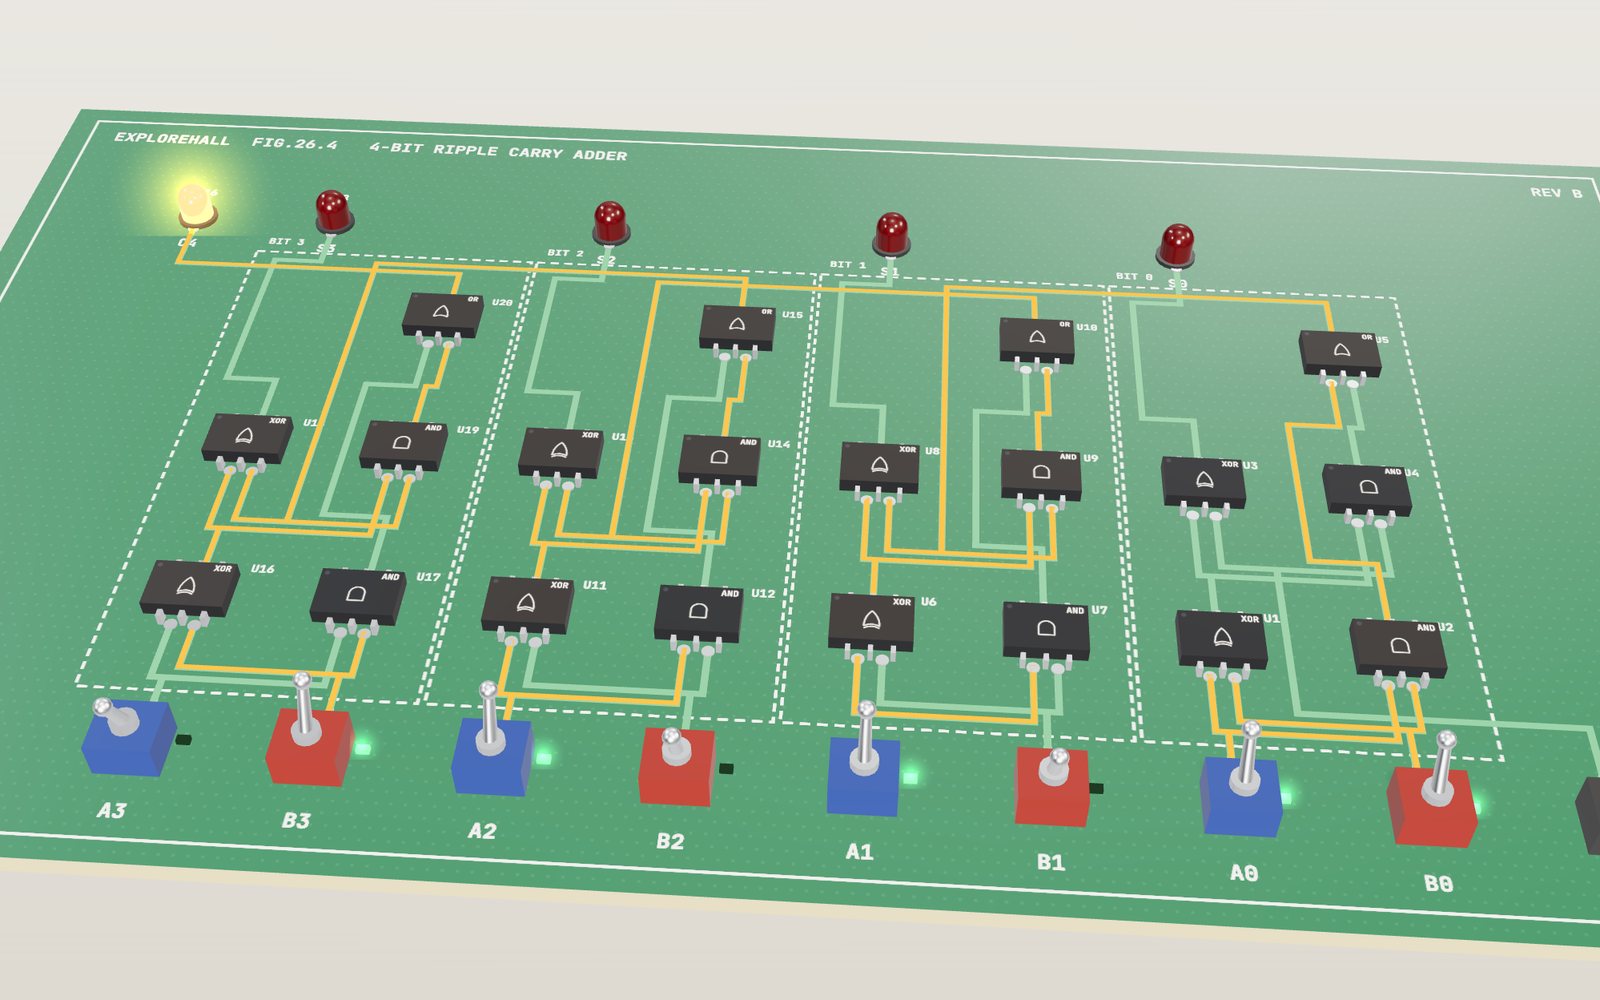
这台设备无法显示 3D 模型。下面的讲解步骤可以直接阅读文字。
1 / 20 两个 4 位数与五个 LED前排表示两个 4 位数。此处 A 为 0111(7),B 为 1001(9)。观察光穿过 20 个逻辑门,直到 LED 显示 10000,也就是 16。点击任意开关改变一个位,或用「电路」滑块选择另一种电路。
拖动可旋转,滚轮或双指缩放。
只用开关计算 7 加 9
逻辑门为每一列产生一个和位和一个进位,从而完成二进制数的加法。全加器还接受前一列传来的进位。在行波进位加法器中,每个进位都必须穿过逻辑门,最终答案才能稳定下来。
在纸上,7 + 9 只需一行:个位写 6,向高一位进 1,答案就是 16。计算机没有纸,也不知道数是什么。它拥有的是只有开和关两种状态的开关。那么,一堆开关怎样从 7 和 9 得出 16?
上方的电路板逐层回答这个问题,然后继续往下讲。它打开时显示一个 4 位行波进位加法器:前沿有八个位开关,分别表示 A 和 B 两个数,每个数的范围都是 0 到 15;后面有二十个逻辑门,后沿有五个显示结果的 LED。拨动开关时,传输 1 的铜走线会发光,光以你用门延迟滑块设定的速度穿过逻辑门。角落的面板同时以二进制和十进制显示输入及 LED 的读数。
「电路」滑块可以将电路板切换为用同类门芯片搭成的 15 种电路之一:单个逻辑门、半加器、全加器、4 位和 8 位行波进位加法器、超前进位加法器、加减器、比较器、多路选择器、7 段译码器、SR 锁存器、D 触发器、计数器、小型 ALU,以及由四个与非门组成的谜题。所有电路都使用同一套仿真,因此你可以比较它们各需多少个逻辑门,以及各需多长时间才能稳定。
只用 0 和 1 写数
在十进制中,每一列的位权都是右侧一列的十倍:个位、十位、百位。二进制的原理相同,只是把十换成二。各列的位权是 1、2、4 和 8,因此四个位能表示从 0(0000)到 15(1111)的任何数。在电路板上,开关 A0 对应位权为 1 的一位,A3 对应位权为 8 的一位,每个开关下印着的小数字表示它的位权。
七是 4 + 2 + 1,也就是 0111。九是 8 + 1,也就是 1001。它们的和 16 需要第五列,其位权为 16,因此答案是 10000。第五列就是进位 LED C4。当和大于 15 时,进位 LED 是电路板显示它的唯一途径。
二进制适合电子电路,因为一根导线只需处于两种明显不同的状态之一。电路无需分辨 3 伏和 3.5 伏,只需区分「高」和「低」,这样要每秒可靠地完成数十亿次就容易得多。
用作开关的晶体管
把「电路」滑块设为「单个逻辑门」,在模型下方选择「导线」。开关 X 通过跳线把 LED 接到电源上,LED 完全反映开关的状态:1 为亮,0 为灭。
现在选择「晶体管」。模型展示一个有三根引脚的 NPN 晶体管。流入中间引脚(基极)的小电流,能使另外两根引脚(集电极和发射极)之间流过大得多的电流,LED 随之点亮。移除基极电流,LED 就会熄灭。晶体管成了一个由电而非手指拨动的开关。
这是一种简化,模型也说明了这一点。真实的晶体管是模拟元件:在一定范围内,基极电流越大,集电极电流也越大。逻辑电路的设计让晶体管只停留在完全截止或完全导通的状态,并尽快经过中间状态。这才让我们能把它当作开关。
由成对晶体管构成的逻辑门
只要一个开关能控制另一个开关,就能构建判断。如今的芯片使用一种叫 MOSFET 的晶体管,分为两类:n 沟道晶体管在输入为高电平时导通,p 沟道晶体管在输入为低电平时导通。CMOS 逻辑将它们配对,使一个网络能把输出拉高到电源电压,另一个网络能把输出拉低到地,而且对于任何输入,两个网络中恰好只有一个导通。逻辑门静止时几乎不消耗电流。Chih-Tang Sah 和 Frank Wanlass 于 1963 年在 Fairchild 展示的这一特性,正是手机能容纳数十亿个晶体管而不熔化的原因。
数一数晶体管,就会发现各种逻辑门的成本并不相同:
| 逻辑门 | 功能 | CMOS 晶体管数 |
|---|---|---|
| 非门(NOT) | 反转输入 | 2 |
| 与非门(NAND) | 仅当两个输入都为 1 时输出 0 | 4 |
| 或非门(NOR) | 仅当两个输入都为 0 时输出 1 | 4 |
| 与门(AND) | 与非门后接非门 | 6 |
| 或门(OR) | 或非门后接非门 | 6 |
| 异或门(XOR) | 输入不同时输出 1 | 此处使用的普通结构为 12 个 |
出人意料的是,大家最先学到的与门,成本竟高于与非门。在 CMOS 中,自然形成的逻辑门是反相的,因为 n 沟道网络会把输出拉低:两个串联的 n 沟道晶体管仅在两个输入都为 1 时拉低输出,这就是与非门;两个并联则构成或非门。要得到与门,就再加一个反相器。打开「每芯片晶体管数」,电路板上的每个芯片就会显示自己的数量;「单个逻辑门」实验台让你逐一查看全部七种类型和普通导线。
与非门还有一个特性。只用与非门,就能构建非门(把两个输入接在一起)、与门(一个与非门和一个非门)、或门(先反转两个输入),以及其他一切逻辑门。电路板上的最后一种电路正是基于这一点的谜题:四个与非门,其输入由你在控件下方的实验室中选择。接线正确时,输出会在全部四行中与异或门相同。
半加器:异或门求和,与门求进位
看看异或门的真值表。0 + 0 = 0、0 + 1 = 1、1 + 0 = 1,而二进制的 1 + 1 = 10,即本列为 0,并向高一位进 1。每个答案最右边的数字都恰好等于异或列。只有最后一行的进位为 1,这恰好就是与运算。
因此,把相同的两个位送入一个异或门和一个与门,就能相加。这一对门叫半加器。在「半加器」电路板上,它独立存在;在 4 位加法器上,它是每一位的第一个模块。当 A 和 B 都为 1 时,异或门给出和 0,与门给出进位 1。
全加器:三个位输入,两个位输出
半加器足以处理个位,但其余各列都有三项要加:A 的一位、B 的一位,以及从右侧传来的进位。全加器用两个半加器和一个或门处理它们。电路板上的每一位都使用以下名称:
- p = A xor B,g = A and B(第一个半加器)
- S = p xor C,t = p and C(第二个半加器加上输入进位 C)
- 输出进位 = g or t
或门永远不会同时收到两个 1。如果 A 和 B 都为 1,那么 p 就为 0,t 不可能为 1。它只是合并产生进位的两种途径:本列自己产生一个进位(g),或本列传递收到的进位(t)。全加器真值表的八行覆盖了所有情况,最大的 1 + 1 + 1 = 3 会输出进位 1、和 1。
每位五个逻辑门,四个位就构成了 4 位加法器的 20 个逻辑门。每个全加器的输出进位接到左侧下一个全加器的输入进位,就像纸上计算时的「进 1」。这条链正是它被称为行波进位加法器的原因。运行时,角落的真值表会标出每一位正在使用哪一行,你可以看到第 0 位停在 1 1 0,而第 3 位在 0 1 1 上等待。
为什么进位很慢
没有逻辑门能立即作答。输入变化后,输出会稍晚才跟着变化,这段时间叫门延迟或传播延迟。模型为每个逻辑门赋予恰好一个单位的延迟,滑块把这个单位拉长到 0.05 至 2.4 秒,让你能够观察。
以下是从 0 + 0 的电路板开始计算 7 + 9 的过程:
| 门延迟 | 变化 |
|---|---|
| 1 | 所有第一级异或门和与门响应新的开关状态。第 0 位(1 + 1)产生 g = 1。 |
| 2 | 进入第 1 位的进位变为 1。第 1、2、3 位暂时显示和为 1。 |
| 3 至 4 | 第 1 位加上进位:和变回 0,输出进位变为 1。 |
| 5 至 6 | 第 2 位发生同样的变化。 |
| 7 至 8 | 第 3 位降为 0,C4 点亮。LED 显示 10000,也就是 16。 |
每一位需要两个门延迟来传递进位:一个用于产生 t 的与门,一个用于产生输出进位的或门。穿过四个位,最后的进位在 8 个延迟后到达。4 位电路板的最坏情况是 9 个延迟,符合 n = 4 位时的 2n + 1。打开「各芯片延迟」,每个芯片就会显示其输出上次变化时的延迟数;沿着进位链,数字依次升高为 2、4、6、8。
在这 8 个延迟期间观察 LED,你会看到错误答案。在第 6 个延迟时,面板可能显示 01000,也就是 8。并没有故障:这些 LED 显示的是进位到达前算出的和。真实电路也有同样短暂的错误输出,称为毛刺,因此处理器读取加法器输出前,会等待一段固定时间,让最慢路径完成。这段等待时间是决定时钟速度的因素之一。「时序图」用波形显示同样的过程,各输出在稳定前会先上下跳变。
8 位电路板让这一代价一目了然。它把相同的全加器重复八次,共 40 个逻辑门,而 255 + 1 会让进位经过每一位:LED 在 16 个门延迟后稳定,所需时间是 4 位电路板计算 15 + 1 的两倍。以同样方式搭建的 64 位行波进位加法器,最坏情况下需要 129 个门延迟。如果想一次只观察一个延迟,打开「逐个延迟」,然后按模型下方的「下个延迟」。
提前算出进位
快速加法器不等待进位逐位传递。再看全加器:当 g = A and B 为 1 时,一列会自行产生进位;当 p = A xor B 为 1 时,它会传递收到的进位。所有列的这两个信号都会在一个门延迟后同时就绪。用它们可以把每个进位完整展开:
- C1 = g0 + p0 C0
- C2 = g1 + p1 g0 + p1 p0 C0
- C3 = g2 + p2 g1 + p2 p1 g0 + p2 p1 p0 C0
- C4 = g3 + p3 g2 + p3 p2 g1 + p3 p2 p1 g0 + p3 p2 p1 p0 C0
把 C2 读成一句话:如果第 1 位产生了进位,或第 1 位传递第 0 位产生的进位,或第 1 位和第 0 位都传递输入进位,第 2 位就会收到进位。每一行都是一排与门后接一个或门,因此所有进位都会在三个门延迟后到达,和再晚一个延迟到达。「超前进位」电路板用 26 个逻辑门实现这一点。输入 15 + 1,它在 4 个门延迟内稳定,而行波进位电路板用了 8 个。面板的表格显示每一位的 P、G 和进位。
代价在于与门。C4 已经需要一个 5 输入与门和一个 5 输入或门,项数还会随着每增加一位而增长,因此宽位加法器会结合两种思路:用四位的小型超前进位模块,再在模块之间增加第二级超前进位。IBM 的 Gerald Rosenberger 于 1957 年为二进制超前进位加法器申请了专利。Charles Babbage 早在一个世纪前就发现了同样的问题,并为分析机设计了预测进位的机构。如今,带有「快速进位」的 4 位加法器已是目录中的芯片产品:Texas Instruments 仍列有 SN74LS283。
用同一个加法器做减法
计算机不需要单独的减法器。在通常用来存储负数的二进制补码表示中,负 B 写作「反转 B 的每一位,再加 1」。因此 A − B 就是 A + (not B) + 1。
「加减器」电路板在 B 的每一位前增加一个异或门。SUB 关闭时,每个异或门直接传递对应的 B 位;SUB 打开时,每个异或门反转对应的位,同一根 SUB 线还送入输入进位,提供额外的 1。试试 5 − 7。B = 0111 变为 1000,加法器计算 0101 + 1000 + 1 = 1110,而把 1110 作为有符号 4 位数读取,结果是 −2。作为无符号数读取则是 14,这在它自己的意义上也正确:5 − 7 + 16 = 14。同样的位会因读取方式不同而含义不同,面板同时显示两者。
有符号 4 位数的范围只有 −8 到 7,因此有些答案装不下。电路板的绿色 V LED 会检测这种情况:它是最高位输入进位与输出进位的异或结果,两者不同时就点亮。7 + 1(SUB 关闭)会点亮它,因为 0111 + 0001 = 1000,读作 −8。额外的一排异或门在开始时多耗一个门延迟,V 门在末尾再多耗一个,因此这块电路板的最坏情况为 11 个延迟。
比较两个数
电路怎样判断 9 比 5 大?方法和你比较写下的数字一样:看它们不同的最高位。「比较器」电路板逐位求出结果。在一位中,A > B 表示 A 为 1、B 为 0(B 输入端带反相器的与门),A < B 则相反,而两者都不成立时该位相等,这就是对两者做或非运算。
然后它按位权排列优先次序。如果第 3 位判断 A 更大,或第 3 位相等而第 2 位判断 A 更大,或第 3、2 位相等而第 1 位判断 A 更大,依此向下,A 就更大。这是由一个或门合并的四个与项,结构与超前进位相同。1001 和 0101 首先在第 3 位不同,该位 A 为 1,A > B 的 LED 在 4 个门延迟后点亮(这块电路板最坏为 5 个)。电路板使用 29 个逻辑门。TI SN74LS85 在一个封装中完成同样的工作,还带有额外输入,让多个芯片能比较更长的数。
选择一个输入并显示一位数字
另有两种电路采用相同模式,用或门汇合多个与门。
多路选择器负责选择。4 选 1 电路板有 D0 到 D3 四个数据输入和两个选择位。每个数据输入都进入一个 3 输入与门,另外还接收选择位(或它们的反相),因此无论怎样设置,都恰好只有一个与门开通,或门把它的数据位传给 Y。七个逻辑门,三个门延迟。从处理器的寄存器堆到电视的信号源切换,只要一根导线必须传递多个信号中的一个,就有多路选择器。
译码器负责显示。7 段显示器有七个条形 LED,名称为 a 到 g,每个数字点亮不同的组合:1 点亮 b 和 c,8 点亮全部七段。对每一段,都能列出会点亮它的数字,再把列表化简成积之和,也就是若干与项由一个或门合并。电路板上的译码器就是这样算出来的:4 个反相器、28 个共用与项和 7 个或门,共 39 个逻辑门,从开关到显示段经过三个门延迟。它既显示 0 到 9,也显示十六进制数字 A 到 F。TI SN74LS47 是用于 0 到 9 的目录产品。
能记忆的电路
到目前为止,所有电路都会遗忘。改变开关,输出就跟着变;没有什么取决于此前发生的事。记忆需要一个回路。
SR 锁存器由两个或非门组成,各自把输出送入另一个。当 S 和 R 都为 0 时,回路保持原有状态,Q = 1 或 Q = 0,只要电源不断就一直保持。S 上的 1 强制 Q 为 1,R 上的 1 强制 Q 为 0。置位 Q,再关闭 S,Q 仍保持为 1。这就是由八个晶体管构成的一位存储器。
锁存器有一种禁用输入。当 S 和 R 都为 1 时,两个输出都为 0,如果随后同时释放两者,两个门就会竞争。在两个门延迟完全相同的模型中,回路永远无法稳定:每过一个门延迟,两个输出就一起翻转,面板也会说明这一点。真实锁存器从不会完全平衡,因此总有一方胜出,但哪一方胜出、需要多长时间都无法预测。工程师称之为亚稳态,数字设计会通过合理安排,避免它在正常使用中出现。
D 触发器仅在一个瞬间接收数据,从而消除这一问题。电路板的版本采用 7474 芯片使用的六与非门设计。时钟保持低电平或高电平期间,D 可以任意变化,Q 都不动。只有 CLK 从 0 上升到 1 的瞬间,Q 才取得 D 的值,并保持到下一个上升沿。输入 D 和 CLK 的 49,152 个随机步骤时,Q 每一次都遵守了这一规则。
计数时钟脉冲
把四个触发器并排放置,加上一个计算当前数加一的小电路,再把结果反馈到触发器的 D 输入。每个时钟脉冲都会装入下一个数。4 位计数器电路板正是用 30 个逻辑门完成这些:四个触发器中的 24 个与非门,以及加法器的六个逻辑门。第 0 位始终翻转,第 0 位为 1 时第 1 位翻转,第 1 和第 0 位都为 1 时第 2 位翻转,下面三位都为 1 时第 3 位翻转。
按「时钟脉冲」观察顺序。时钟边沿同时到达四个触发器,两个门延迟后它们的输出变化,随后「加一」逻辑门会在下个脉冲到来之前很早就准备好下一个数。由于每一位都在同一个边沿变化,它被称为同步计数器,就像 TI SN74LS161A。1111 之后回到 0000。运行 40 个脉冲,它从 0 数到 15 再循环,没有漏过一次。
用相同部件构成 ALU
处理器的算术逻辑单元是实际执行运算的电路。4 位 ALU 电路板用 59 个逻辑门展示这一思想。对每一位,它并行计算四个结果:A + B、A − B、A AND B 和 A OR B。然后两个操作位通过与多路选择器相同的与门、或门选择方式,决定哪个结果到达输出。操作码 00 做加法,01 做减法(使用加减器中那一排异或门),10 是与运算,11 是或运算。
四个结果始终都在计算;操作位只选择你看到哪一个。真实 ALU 也是这样工作的,这也解释了为什么 ALU 的最长路径,此处为 13 个门延迟,比单独加法器的更长。试试 12 AND 10:1100 和 1010 只有第 3 位共同为 1,因此答案是 1000,也就是 8。
一个门延迟有多长?
模型计数延迟;真实元件用纳秒测量。Texas Instruments 给出的 SN74HC00 与非门在 4.5 V 时的典型延迟为 9 ns,较早的 SN74LS00 为 9 至 10 ns,SN74AC00 在 5 V 时约为 5 ns。继电器慢 100 万倍:Omron G5V-1 数据手册允许的动作时间最长为 5 ms。
用它乘以电路板的最长路径。4 位行波进位加法器需要 9 个延迟,因此使用 74HC00 类型的逻辑门时,约 81 ns 就能稳定,足以每秒完成 1200 万次加法。如果由继电器搭建,同一个加法器需要 45 ms。控件下方的实验室会为电路板上的任意电路做这项计算。现代处理器每秒能相加数十亿次 64 位数,是因为它的逻辑门快了数千倍,加法器又使用超前进位,而不是因为逻辑有什么不同。
亲自检查每种电路
电路板上的每种电路都针对所有可能输入,依据真值表进行了检查。4 位加法器在全部 512 种组合下都给出 A + B + C0,并在全部 262,144 种可能的输入切换后,于 9 个门延迟内稳定到正确答案。8 位加法器检查了全部 131,072 个和及 40 万次随机切换。超前进位加法器在 4 个延迟内稳定,加减器在 11 个内,比较器在 5 个内,多路选择器和译码器在 3 个内,ALU 则在全部 1,048,576 次切换后都于 13 个内稳定。存储电路通过序列运行检查:锁存器经过置位、保持和复位,触发器经过随机时钟和数据,计数器经过 40 个脉冲。
你可以在电路板上试几个例子:
- 行波进位加法器上的 15 + 1:四个进位依次传递,8 个延迟后 LED 显示 10000。
- 超前进位加法器上的 15 + 1:4 个延迟后得到相同答案。
- 5 + 2:没有一列进位,答案 0111(7)在 2 个延迟后就绪。
- 加减器上的 5 − 7:1110,也就是 −2。
模型与真实芯片的区别
- 每个逻辑门的延迟相同。在真实逻辑电路中,异或门比与非门慢,驱动许多输入的门比只驱动一个输入的门慢,而且延迟会随温度和电源电压变化。
- 每根导线无论多长,信号通过都需要 0.85 个门延迟。在真实电路板上,短走线几乎瞬时传递;芯片内部的长导线可能比逻辑门更慢。
- 信号完全为 0 或 1。真实电压需要一小段时间才能上升或下降,而电路板没有噪声、热量或扇出限制。
- 每个芯片只有一个逻辑门。真实逻辑芯片会在一个封装内放入四个与非门或六个反相器,还需要电源引脚、去耦电容和上拉电阻,这些在电路板中都省略了。
- 实验台上的晶体管画作单个双极型开关,而芯片上的晶体管计数针对的是 CMOS。
从布尔代数到继电器加法器
1854 年,George Boole 出版了《思维规律》(The Laws of Thought),其中的代数用类似乘法和加法的运算组合逻辑命题,符号 1 和 0 在其中起着特殊作用。这是一本关于推理而非机器的书。
与电路的联系出现在 1937 年。MIT 硕士生 Claude Shannon 撰写了论文 A Symbolic Analysis of Relay and Switching Circuits。他证明,串联和并联的开关遵循与布尔代数相同的规则,因此可以用代数设计和简化电路,而不必反复试验。最后一章给出了若干电路实例,包括一个二进制数加法器。由该论文整理的文章于 1938 年刊登在 Transactions of the American Institute of Electrical Engineers,并获得 Alfred Noble Prize。
同一年,Bell Labs 的科学家 George Stibitz 用继电器搭建了演示用加法器。因为是在厨房餐桌上组装的,他把它命名为 Model K(K 取自 kitchen)。十年后的 1947 年 12 月,John Bardeen 和 Walter Brattain 在 William Shockley 领导的 Bell Labs 小组中,制成了第一个能工作的晶体管。三人「因对半导体的研究及发现晶体管效应」共同获得 1956 年诺贝尔物理学奖。
从继电器到数十亿个晶体管
最早的大型计算机使用当时手边能找到的开关。Konrad Zuse 在 1941 年的 Z3 使用了 2,300 个继电器;1944 年完成的 Harvard Mark 1 使用了 3,500 个,由一根 50 英尺长的凸轮轴保持同步。从 1944 年初开始在 Bletchley Park 工作的 Colossus 用 2,500 个电子管进行开关操作;1946 年 2 月在 University of Pennsylvania 公布的 ENIAC 则需要 1.8 万个真空管,装满一间 30 乘 50 英尺(约 9 乘 15 米)的房间。MIT 在 1956 年的 TX-0 是第一台用晶体管搭建的通用可编程计算机,每个晶体管都装在插接式「瓶子」中,能像电子管一样更换。
随后,逻辑门搬到了硅上。1961 年,Fairchild 公布了最早的平面集成电路之一,一个含四个晶体管和五个电阻的触发器。Texas Instruments 的 7400 系列 TTL 逻辑芯片从 1966 年起以廉价塑料封装出售,很快占据逻辑芯片市场一半以上,如今仍有许多型号在售,例如四与非门 SN7400。1968 年首次随 Apollo 7 飞行的 Apollo Guidance Computer 主要由同一种芯片构成,每片包含两个 3 输入或非门,每台计算机使用数千片。
1965 年,Gordon Moore 预测芯片上的元件数会每年翻倍,后来改为每两年翻倍。1971 年的 Intel 4004 用 2,300 个晶体管把完整的 4 位处理器放到一个芯片上(Computer History Museum 的时间线给出的数量为 2,250)。Apple 在 2020 年的 M1 有 160 亿个,约为前者的 700 万倍;NVIDIA 在 2024 年的 Blackwell GPU 则有 2,080 亿个。在它们内部,算术仍然由类似这块电路板上的加法器、多路选择器和触发器完成。
常见问题
为什么计算机用二进制而不用十进制?
导线只需处于高或低两种状态之一,晶体管也只需完全导通或完全截止。区分两种状态远比区分十种可靠,而布尔代数恰好能描述两态电路。
半加器与全加器有什么区别?
半加器相加两个位,给出和与进位。全加器相加三个位(两位数字和一个输入进位)。它由两个半加器和一个或门构成。
为什么叫行波进位加法器?
每个全加器都必须等待右侧一列传来的进位,自己的输出进位才能最终确定。进位依次经过各个位,就像掠过水面的波纹。
4 位行波进位加法器需要多久?
在这个模型中,每一位为进位增加两个门延迟。最坏情况是 9 个门延迟,7 + 9 则在 8 个后稳定。使用每个延迟为 9 ns 的 74HC00 类型逻辑门时,约为 81 ns。
为什么 LED 会暂时显示错误数字?
每一列自己的逻辑门一响应就显示和,此时来自右侧的进位尚未到达。这些短暂的错误输出称为毛刺。处理器等最慢路径完成后才使用结果。
和大于 15 时会怎样?
四个和位只能显示 0 到 15。第五个 LED C4 保存最高位的输出进位,位权为 16。有了它,电路板就能显示最大到 15 + 15 + 1 = 31 的任何和。
同一个电路能做减法吗?
能。反转 B 的每一位并打开输入进位,加法器就会用二进制补码计算 A 减 B。「加减器」电路板每位用一个异或门实现这一点,处理器也使用同样的方法,让一个加法器同时处理两种运算。
为什么与非门叫通用逻辑门?
任何逻辑函数都能只用与非门构成:非门是两个输入接在一起的与非门,与门是与非门后接非门,或门则是对两个反相输入做与非运算。或非门也有同样的特性。电路板的与非门谜题要求用四个与非门构成异或门。
为什么与门比与非门需要更多晶体管?
在 CMOS 中,把输出拉到地的晶体管是 n 沟道的,其中两个串联时,只有两个输入都为 1 才会拉低输出。这用 4 个晶体管构成反相函数,也就是与非门。与门需要额外的反相器,数量增至 6 个。
超前进位加法器总是更好吗?
它更快,但随着位数增加,需要更多而且输入数更多的逻辑门。4 位超前进位电路板使用 26 个逻辑门,行波进位电路板则用 20 个。宽位加法器使用小型超前进位模块,并通过第二级超前进位连接。
锁存器和触发器有什么区别?
锁存器会随输入变化而变化(SR 锁存器立即置位和复位)。触发器只在时钟边沿变化,因此满是触发器的整个电路会同步推进,每次一个时钟脉冲。
电路板上的 4 位加法器需要多少个晶体管?
按 CMOS 逻辑门计数为 168 个:八个异或门各 12 个,八个与门各 6 个,四个或门各 6 个。ALU 电路板需要 418 个。Intel 4004 的整个处理器约需 2,300 个。
术语
- 位:一个二进制数字,0 或 1。
- 逻辑门:输出是输入的固定函数的电路,例如与门、或门、非门、与非门、或非门或异或门。
- 真值表:列出每一种输入组合及其输出的表。
- 晶体管:由小电流或小电压控制较大电流的半导体元件。在逻辑电路中用作开关。
- CMOS:由 n 沟道和 p 沟道 MOSFET 配对构成的逻辑,静止时几乎不消耗电流。
- 半加器:相加两个位的一个异或门和一个与门。
- 全加器:相加两个位和一个进位的两个半加器和一个或门。
- 进位:一列的和为 2 或更大时,传递给下一列的 1。
- 门延迟:输入变化后,逻辑门改变输出所需的时间。也叫传播延迟。
- 行波进位加法器:全加器串成的链,每个进位都送入下一列。
- 超前进位:根据产生(g)和传递(p)信号并行计算进位的更快方法。
- 二进制补码:通常用来存储负数的方法;负 B 就是把 B 的每一位反转,再加 1。
- 多路选择器:由选择位决定,将多个输入中的一个传递到输出的电路。
- 译码器:把二进制数转换为每个输出一路信号的电路,例如数字的七个显示段。
- 锁存器:只要电源不断就保持一位数据的逻辑门回路。
- 触发器:只在时钟边沿接收输入的存储电路。
- ALU:算术逻辑单元,处理器中进行加法、减法及位组合的部分。
参考资料
- University of Victoria, CENG 465, Ripple Carry and Carry Lookahead Adders(半加器和全加器、行波进位、超前进位、门延迟). https://www.ece.uvic.ca/~fayez/courses/ceng465/lab_465/project1/adders.pdf (核查于 2026 年 10 月 17 日)
- Google Patents, US 2,966,305, Gerald B. Rosenberger(IBM), Simultaneous carry adder(申请于 1957 年 8 月 16 日). https://patents.google.com/patent/US2966305A/en (核查于 2026 年 10 月 17 日)
- Doron Swade, Charles Babbage and Computational Method, The Rutherford Journal 3(差分机中的逐次进位,分析机中的预测进位). https://www.rutherfordjournal.org/article030106.html (核查于 2026 年 10 月 17 日)
- MIT Libraries, DSpace@MIT, Claude E. Shannon, A symbolic analysis of relay and switching circuits(理学硕士论文). https://dspace.mit.edu/handle/1721.1/11173 (核查于 2026 年 10 月 17 日)
- Golomb, Berlekamp, Cover 等, Claude Elwood Shannon (1916–2001), Notices of the AMS 49(1), 2002(1938 年的文章及 Alfred Noble Prize), 经 Stanford ISL. https://isl.stanford.edu/~cover/papers/paper117.pdf (核查于 2026 年 10 月 17 日)
- Computer History Museum, Timeline of Computer History: 1937(Stibitz 在厨房餐桌上搭建的「Model K」继电器加法器). https://www.computerhistory.org/timeline/1937/ (核查于 2026 年 10 月 18 日)
- Project Gutenberg, George Boole, An Investigation of the Laws of Thought(1854), 全文. https://www.gutenberg.org/ebooks/15114 (核查于 2026 年 10 月 16 日)
- Computer History Museum, 1947: Invention of the Point-Contact Transistor(Bardeen 和 Brattain,1947 年 12 月). https://www.computerhistory.org/siliconengine/invention-of-the-point-contact-transistor/ (核查于 2026 年 10 月 17 日)
- The Nobel Prize, The Nobel Prize in Physics 1956. https://www.nobelprize.org/prizes/physics/1956/summary/ (核查于 2026 年 10 月 16 日)
- University of Texas at Austin, J. A. Abraham, VLSI Design lecture 3, Implementing Logic in CMOS(CMOS 与非门、或非门、复合逻辑门、传输门多路选择器). https://www.cerc.utexas.edu/~jaa/vlsi/lectures/3-2.pdf (核查于 2026 年 10 月 18 日)
- Cornell University, ECE 4740, lecture 14, Pass Transistors and Transmission Gates(静态 CMOS 中与门使用 6 个晶体管,异或门的成本). https://cpb-us-w2.wpmucdn.com/sites.coecis.cornell.edu/dist/4/81/files/2019/06/4740_lecture14-pass-transistors.pdf (核查于 2026 年 10 月 18 日)
- Computer History Museum, The Silicon Engine, 1963: Complementary MOS Circuit Configuration is Invented. https://www.computerhistory.org/siliconengine/complementary-mos-circuit-configuration-is-invented/ (核查于 2026 年 10 月 18 日)
- Computer History Museum, The Silicon Engine, 1963: Standard Logic IC Families Introduced(1966 年起的 TI 7400 系列). https://www.computerhistory.org/siliconengine/standard-logic-ic-families-introduced/ (核查于 2026 年 10 月 18 日)
- Computer History Museum, The Silicon Engine, 1960: First Planar Integrated Circuit is Fabricated(Micrologic 触发器,1961 年 3 月). https://www.computerhistory.org/siliconengine/first-planar-integrated-circuit-is-fabricated/ (核查于 2026 年 10 月 18 日)
- Computer History Museum, The Silicon Engine, 1965: "Moore's Law" Predicts the Future of Integrated Circuits. https://www.computerhistory.org/siliconengine/moores-law-predicts-the-future-of-integrated-circuits/ (核查于 2026 年 10 月 18 日)
- Computer History Museum, The Silicon Engine, 1971: Microprocessor Integrates CPU Function onto a Single Chip(4004,2,300 个晶体管). https://www.computerhistory.org/siliconengine/microprocessor-integrates-cpu-function-onto-a-single-chip/ (核查于 2026 年 10 月 18 日)
- Computer History Museum, Timeline of Computer History: 1941 年(Z3,2,300 个继电器)、1944 年(Harvard Mark 1,3,500 个继电器)、1956 年(TX-0)、1968 年(Apollo Guidance Computer)、1971 年(4004,2,250 个晶体管). https://www.computerhistory.org/timeline/1944/ (核查于 2026 年 10 月 18 日)
- The National Museum of Computing, Colossus(2,500 个电子管,1944 年 2 月投入运行). https://www.tnmoc.org/colossus (核查于 2026 年 10 月 18 日)
- Penn Engineering, University of Pennsylvania, ENIAC(1.8 万个真空管,1946 年 2 月公布). https://www.seas.upenn.edu/about/history-heritage/eniac/ (核查于 2026 年 10 月 18 日)
- Smithsonian National Air and Space Museum, Integrated Circuit, Dual 3 Input, Apollo Guidance Computer. https://airandspace.si.edu/collection-objects/integrated-circuit-dual-3-input-apollo-guidance-computer/nasm_A20170004000 (核查于 2026 年 10 月 18 日)
- Texas Instruments, SN74HC00 数据手册(4.5 V 时典型传播延迟为 9 ns). https://www.ti.com/lit/ds/symlink/sn74hc00.pdf (核查于 2026 年 10 月 18 日)
- Texas Instruments, SN74LS00 数据手册(典型延迟为 9 ns 和 10 ns). https://www.ti.com/lit/ds/symlink/sn74ls00.pdf (核查于 2026 年 10 月 18 日)
- Texas Instruments, SN74AC00 数据手册(5 V 时典型延迟为 6 ns 和 4.5 ns). https://www.ti.com/lit/ds/symlink/sn74ac00.pdf (核查于 2026 年 10 月 18 日)
- Texas Instruments, SN74LS283、SN74LS85、SN74LS47、SN74LS161A 和 SN7400 产品页. https://www.ti.com/product/SN74LS283 (核查于 2026 年 10 月 18 日)
- Omron, G5V-1 继电器数据手册(动作时间最长 5 ms). https://omronfs.omron.com/en_US/ecb/products/pdf/en-g5v_1.pdf (核查于 2026 年 10 月 18 日)
- Apple Newsroom, Apple unleashes M1(160 亿个晶体管,2020 年 11 月 10 日). https://www.apple.com/newsroom/2020/11/apple-unleashes-m1/ (核查于 2026 年 10 月 18 日)
- NVIDIA Newsroom, NVIDIA Blackwell Platform Arrives to Power a New Era of Computing(2,080 亿个晶体管,2024 年 3 月 18 日). https://nvidianews.nvidia.com/news/nvidia-blackwell-platform-arrives-to-power-a-new-era-of-computing (核查于 2026 年 10 月 18 日)
- 本页计算:对每种组合电路的每个输入,以及两个输入之间的每次切换,都逐一推演了逻辑门模型(8 位加法器采用抽样)。最坏稳定时间:4 位行波进位为 9,8 位行波进位按路径长度为 17(观察到 16),超前进位为 4,加减器为 11,比较器为 5,多路选择器为 3,译码器为 3,ALU 为 13 个门延迟。
解说文章与模拟采用 CC BY-NC-SA 4.0 许可,另有说明的除外。
更多展品
计算尺:用交互模型学习使用方法
在 25 cm 计算尺上,2 距 1 有 75.3 mm,因为 250 × log 2 = 75.3,将两段这样的长度首尾相接就能让数相乘。
触摸屏原理:玻璃如何找到你的手指
手机玻璃下方有一张透明电极网格,手指会让电极间传递的电荷出现小幅下降。
晶体管是怎样工作的
一块芯片上有 160 亿个晶体管,每一个都靠栅极上几伏的电压来开和关,而栅极从不接触下面的硅。
机械臂:移动关节,逐步了解工作原理
让六轴机械臂的指尖以 250 mm/s 横向滑过空间中某条特定直线,一个腕部关节就必须每秒转动 510°。
自行车变速原理:用模拟器换挡爬坡
在 50 比 11 的挡位下,每踩一圈公路车前进 9.57 米;在 34 比 32 下,则前进 2.24 米。
QR 二维码:遮挡后如何读取
用手遮住 QR 码的 30%,手机仍能读取。遮住一个角,却读不出来。