ABB. 59So funktioniert's
So funktioniert die DNA-Replikation: Okazaki-Fragmente in 3D
Eine DNA-Polymerase kann nur an einem Strangende anfügen, weshalb an jeder Replikationsgabel ein neuer Strang zusammenhängend wächst und der andere in kurzen Fragmenten.
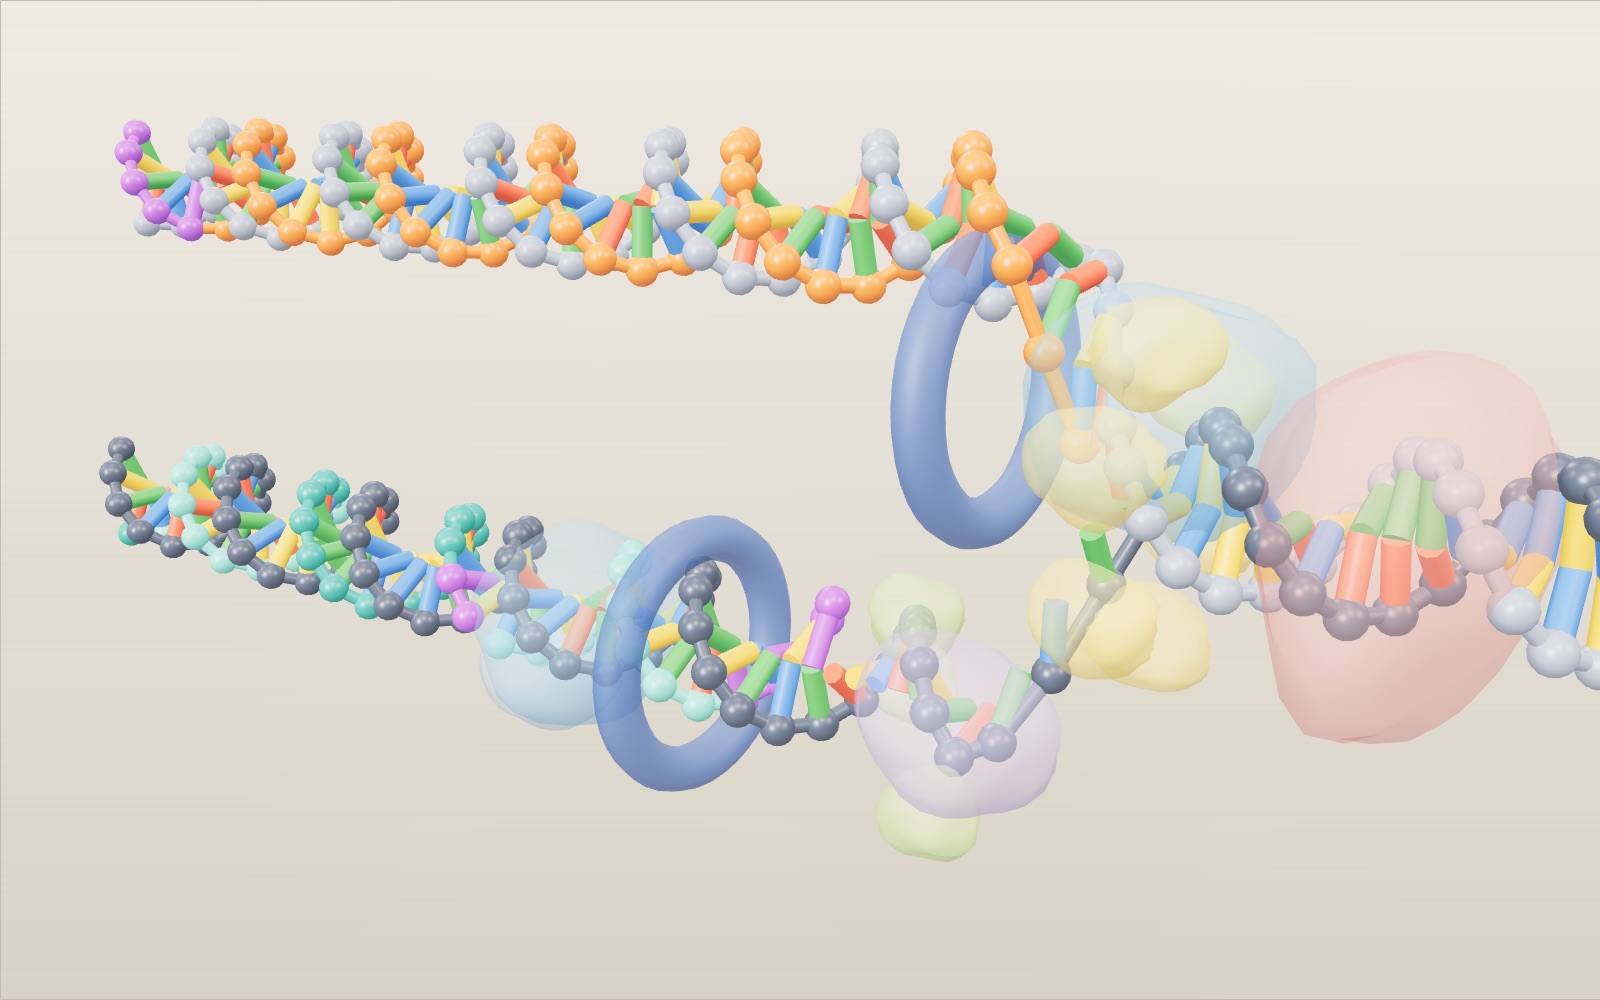
Dieses Gerät kann das 3D-Modell nicht anzeigen. Die Schritte des Rundgangs unten lassen sich als Text lesen.
1 / 11 84 Basenpaare DNA, maßstäblichDieser Abschnitt ist etwa 29 nm lang. Die Balken darunter geben den Maßstab an: Eine Windung umfasst in Lösung 10,5 Basenpaare (3,57 nm), während Lehrbücher auf 10 Basenpaare und 3,4 nm runden. Die Sequenz ist für das Modell erfunden.
Ziehen zum Drehen. Mausrad oder zwei Finger zum Zoomen.
Wie kopiert eine Zelle ihre DNA vor der Teilung?
Die DNA-Replikation läuft in mehreren Schritten an einer wandernden Y-förmigen Replikationsgabel ab. Die Helikase öffnet die Doppelhelix, und die Primase legt einen kurzen RNA-Primer an. Die DNA-Polymerase kann Nukleotide nur an ein 3′-Ende anfügen, weshalb der Leitstrang zusammenhängend wächst, während der Folgestrang rückwärts in Okazaki-Fragmenten entsteht; anschließend ersetzen DNA-Polymerase I und Ligase die Primer durch DNA und schließen die Lücken. Eine menschliche Replikationsgabel kopiert 50 bis 100 Nukleotide pro Sekunde, und eine menschliche Zelle kopiert ihre 6,4 Milliarden Basenpaare in einer S-Phase von etwa 8 bis 10 Stunden.
Eine Schnittwunde an Ihrer Hand heilt, weil sich Hautzellen teilen, und jede neue Zelle braucht ihren eigenen vollständigen DNA-Satz. In einer menschlichen Zelle bedeutet das, vor der Zweiteilung etwa 6 Milliarden Basenpaare zu kopieren. Eine Gruppe von Proteinen übernimmt die Kopierarbeit an einer wandernden Y-förmigen Verzweigung, der Replikationsgabel. Diese Proteine müssen die Helix entwinden, jeden neuen Strang beginnen, ihn Base für Base aufbauen, eigene Fehler erkennen und die zurückgelassenen Stücke verbinden.
Dieses Exponat bildet eine Replikationsgabel im molekularen Maßstab nach. Ein Abschnitt aus 84 Basenpaaren liegt quer über der Bühne. Eine Helikase öffnet ihn, die Primase legt kurze RNA-Startstücke an, zwei DNA-Polymerasen bauen die neuen Stränge auf, DNA-Polymerase I und DNA-Ligase bearbeiten den Folgestrang nach, und am Ende bewegen sich zwei Doppelhelices auseinander. Die Anfangsansicht beginnt direkt neben der Helikase beim Öffnen der Helix. Ziehen Sie am gelben Helikasering, um die Gabel selbst vorwärtszubewegen, drücken Sie „Nächste Base paaren“, um wie die Polymerase Basen einzusetzen, und tippen Sie auf ein Enzym, um seine Aufgabe zu lesen. Mit dem Schieberegler können Sie den Ablauf durchlaufen, mit „Geschwindigkeit“ das Tempo und damit die Länge der Okazaki-Fragmente verändern und mit dem Schalter „Korrekturlesen“ sehen, was geschieht, wenn die Polymerase ihre Arbeit nicht mehr überprüft. Die Angaben stammen aus dem Biologielehrbuch von OpenStax, von Nature Education, vom US-amerikanischen National Human Genome Research Institute und aus der Originalarbeit von Meselson und Stahl von 1958. Die Quellen stehen am Ende.
Die Doppelhelix im Maßstab des Modells
DNA besteht aus zwei umeinander gewundenen Strängen. Jeder Strang ist eine Kette aus Zuckern und Phosphaten, und jeder Zucker trägt eine von vier Basen: A, C, G oder T. A auf einem Strang paart sich mit T auf dem anderen, und C paart sich mit G. Diese Regel ermöglicht das Kopieren: Sobald die Stränge getrennt sind, enthält jeder alle Informationen, um seinen Partner wieder aufzubauen. Im Modell sind die Basen A grün, T rot, G gelb und C blau gefärbt. RNA verwendet U anstelle von T, und U ist violett.
Benachbarte Basenpaare liegen 0,34 nm auseinander, und die Helix ist 2 nm breit. In Lehrbüchern steht oft, dass die Helix alle 10 Basenpaare oder 3,4 nm eine Windung macht. Dieser Wert stammt aus Röntgenaufnahmen von DNA-Fasern. In Lösung gemessen, wie sie in einer Zelle vorliegt, ist DNA etwas weniger eng gewunden: James Wang fand 1979 einen Wert von 10,4 Basenpaaren pro Windung, und 10,5 ist der am häufigsten verwendete Wert. Das Modell verwendet 10,5, sodass eine Windung 10,5 × 0,34 = 3,57 nm misst. Die beiden Balken unter dem Modell zeigen beides: eine Modellwindung und zum Vergleich die 3,4 nm aus dem Lehrbuch. Das gesamte Modell ist 84 × 0,34 = 28,6 nm lang.
Die beiden Stränge verlaufen in entgegengesetzte Richtungen. Chemiker nummerieren die Kohlenstoffatome jedes Zuckers, und danach heißen die Strangenden 5′ und 3′. Ein Strang, der von links nach rechts von 5′ nach 3′ verläuft, paart sich mit einem, der von rechts nach links von 5′ nach 3′ verläuft. Dieses Detail, die antiparallelen Stränge, bestimmt den größten Teil dessen, was an der Gabel geschieht.
Was die Helix öffnet und offen hält
Das Enzym, das DNA öffnet, ist die Helikase. Sie löst die Wasserstoffbrücken zwischen den gepaarten Basen und nutzt dafür Energie aus ATP. An ihrer Arbeitsstelle teilt sich die Doppelhelix in zwei Einzelstränge; die dabei entstehende Form ist die Replikationsgabel. Im Modell ist die Helikase ein gelber Ring an der Stelle, an der sich die Stränge trennen, und sie wandert beim Fortschreiten der Gabel mit.
Zwei verdrillte Stränge auseinanderzuziehen hat eine Nebenwirkung. Die DNA vor der Gabel wird stärker aufgewickelt, wie ein verdrilltes Seil, das sich verknäuelt, wenn man seine Stränge an einem Ende auseinanderzieht. OpenStax beschreibt, wie die Topoisomerase diese Überverdrillung verhindert: Sie erzeugt vorübergehende Einzelstrangbrüche in der Helix vor der Gabel und verschließt sie wieder. Im Modell ist sie der rosafarbene Körper auf der noch ungeöffneten DNA, einige Windungen vor der Helikase.
Die geöffneten Einzelstränge würden sich wieder paaren, wenn sie sich selbst überlassen blieben. Einzelstrangbindende Proteine bedecken sie und halten sie auseinander, bis eine Polymerase eintrifft. Im Modell sind es die kleinen grünen Körper. Beobachten Sie, wo sie sich sammeln: Fast alle sitzen auf der unteren Matrize, weil dieser Strang vor dem Kopieren am längsten wartet. Der Grund dafür folgt im nächsten Teil.
Warum eine Polymerase einen Primer braucht
Die DNA-Polymerase fügt Nukleotide einzeln an, jeweils passend zur gegenüberliegenden Base auf der Matrize. Die Energie für jede neue Bindung stammt aus dem eintreffenden Nukleotid selbst, das als Triphosphat ankommt. Das Enzym hat jedoch zwei strenge Einschränkungen. Es kann nur am 3′-Ende eines Strangs anfügen, und ein Strang muss bereits vorhanden sein. Es kann nicht von null anfangen.
Die Primase löst das Startproblem. Sie ist eine RNA-Polymerase, und RNA-Polymerasen können eine neue Kette ohne Partner beginnen. Die Primase schreibt ein kurzes, zur Matrize komplementäres RNA-Stück, laut OpenStax etwa 5 bis 10 Nukleotide lang. Dieser Primer gibt der DNA-Polymerase ein freies 3′-Ende zum Verlängern. Im Modell sind Primer 5 Nukleotide lang und als violette Kugeln dargestellt. Ein Primer ganz links beginnt den oberen neuen Strang. Der untere neue Strang braucht immer wieder einen neuen Primer.
Nur eine Richtung und ihre Folgen für beide Stränge
Da die Polymerase nur an einem 3′-Ende anfügen kann, wächst jeder neue Strang in Richtung 5′ nach 3′. Betrachten Sie nun die beiden Matrizen. Auf der oberen Matrize weist die 5′-nach-3′-Richtung des neuen Strangs zur Gabel. Die Polymerase kann der Helikase folgen und denselben Strang weiter verlängern, sobald mehr Matrize freiliegt. Dieser kontinuierliche Strang ist der Leitstrang, im Modell orange, und er wird von einem einzigen Primer aus aufgebaut.
Auf der unteren Matrize muss der neue Strang in die andere Richtung verlaufen, von der Gabel weg. Beim Öffnen der Gabel erscheint neue Matrize hinter der Polymerase statt vor ihr. Sie lässt sich nur kopieren, indem nahe der Gabel ein neues Stück begonnen und rückwärts aufgebaut wird, bis es auf das zuvor gebildete Stück trifft. Jedes dieser Stücke ist ein Okazaki-Fragment, und der daraus aufgebaute Strang heißt Folgestrang; im Modell ist er türkis, mit abwechselnden Fragmenten in zwei Farbtönen.
Schalten Sie im Reiter „Steuerung“ die „Basenpaarfarben“ aus, um dies deutlich zu sehen. Alte Stränge werden grau, und die beiden Arten neuer Stränge behalten ihre eigenen Farben. Der Leitstrang ist eine lange orangefarbene Linie. Der Folgestrang ist eine Reihe kurzer türkisfarbener Stücke mit violetten Primern an ihren rechten Enden.
Okazaki-Fragmente auf dem Folgestrang
Der Folgestrang wiederholt einen Zyklus. Die Primase legt nahe der Gabel einen Primer an. Die Folgestrang-Polymerase, von einer ringförmigen Gleitklemme an der DNA gehalten, verlängert diesen Primer von der Gabel weg, bis sie auf das vorherige Fragment trifft. Dann löst sie sich und wandert zum nächsten Primer. Im Modell können Sie beobachten, wie die zweite Polymerase und ihre dunkelblaue Klemme nach jedem fertigen Stück zur Gabel zurückspringen.
Echte Fragmente sind viel länger als die 14 Nukleotide des Modells. Eine Übersichtsarbeit von Balakrishnan und Bambara nennt etwa 1200 Nukleotide für Okazaki-Fragmente in Bakterien und nur etwa 200 in eukaryotischen Zellen, wo ihre Länge dem Abstand der Nukleosomen folgt. Das Modell verkürzt sie, damit mehrere gleichzeitig auf den Bildschirm passen. Die Zeile „Okazaki“ der Anzeige zählt zwei Größen: wie viele Fragmente begonnen und wie viele mit ihrem Nachbarn verbunden wurden.
Primer durch DNA ersetzen und Einzelstrangbrüche schließen
Ein fertiges Fragment trägt an einem Ende noch RNA, und ein neuer DNA-Strang sollte keine RNA enthalten. In Bakterien entfernt die DNA-Polymerase I mit ihrer Exonukleaseaktivität jeden Primer und füllt die Lücke mit DNA; als Ausgangspunkt nutzt sie die DNA des dahinterliegenden Fragments. In eukaryotischen Zellen läuft dies anders: Polymerase δ verdrängt den Primer zu einem überstehenden Stück, und die Flap-Endonuklease 1 (FEN1) schneidet es ab. Auch RNase H kann zur Primerentfernung beitragen, aber RNase H und FEN1 sind unterschiedliche Enzyme. Das Modell zeigt die bakterielle Variante: ein hellblaues Enzym, das violette Kugeln in türkisfarbene umwandelt.
Nach dem Austausch liegen die beiden DNA-Stücke Ende an Ende, sind aber noch nicht verbunden. Eine Phosphodiesterbindung fehlt; diese Unterbrechung heißt Einzelstrangbruch. Die DNA-Ligase bildet diese Bindung zwischen dem 3′-Ende eines Stücks und dem 5′-Ende des nächsten. Im Modell sitzt die orangefarbene Ligase kurz auf dem Einzelstrangbruch, ein Ring blitzt auf, und die Verbindung im Rückgrat erscheint. Dann steigt die Zahl der verbundenen Fragmente.
Wie die Polymerase eine falsche Base zurücknimmt
Polymerasen setzen manchmal eine falsche Base ein. Nature Education nennt eine Häufigkeit von etwa 1 pro 100.000 Nukleotide. Eine falsche Base passt schlecht in die Helix, und ihr 3′-Ende liegt für das nächste Anfügen falsch. Die Polymerase bemerkt dies, geht zurück, schneidet das falsche Nukleotid mit ihrer 3′-nach-5′-Exonukleaseaktivität heraus und setzt das richtige ein. Das ist Korrekturlesen; OpenStax beschreibt es so, dass die Polymerase jede neu angefügte Base liest, bevor sie die nächste hinzufügt.
Das Modell enthält zwei absichtlich eingebaute Fehler auf dem Leitstrang: ein T gegenüber einem G und ein G gegenüber einem T. Beide sind Wobble-Paare, jene Art von Fehlpaarung, die Nature Education beschreibt. Bei eingeschaltetem „Korrekturlesen“ hält die Polymerase an beiden an: Die falsche Base wird magenta, schwenkt heraus, verschwindet und wird ersetzt. Während des Halts wartet auch die Helikase, sodass die Gabel zurückfällt. Schalten Sie „Korrekturlesen“ aus und spielen Sie denselben Abschnitt ab. Die Gabel erreicht jeden Punkt früher, und die Okazaki-Zähler eilen voraus, doch die beiden falschen Basen bleiben magenta umringt im neuen Strang, und die Anzeige nennt die Zahl der zurückgebliebenen Fehler.
Die Zahlen überprüfen
Das Standardtempo des Modells beträgt 5 Basenpaare pro Sekunde. Eine menschliche Replikationsgabel bewegt sich laut OpenStax mit 50 bis 100 Nukleotiden pro Sekunde; Nature Education nennt etwa 40. Das Modell läuft also etwa 10- bis 20-mal langsamer als eine echte menschliche Gabel. Eine bakterielle Gabel ist viel schneller: E. coli kopiert sein Chromosom aus 4,6 Millionen Basenpaaren mit zwei Gabeln in etwa 42 Minuten, was ungefähr 1000 Nukleotiden pro Sekunde an jeder Gabel entspricht.
Kann eine menschliche Gabel ein ganzes Genom kopieren? Bei 50 Nukleotiden pro Sekunde würden 6 Milliarden Basenpaare 6.000.000.000 ÷ 50 = 120 Millionen Sekunden dauern, fast vier Jahre. Zellen umgehen dies, indem sie viele Gabeln gleichzeitig starten; laut OpenStax können Menschen bis zu 100.000 Replikationsursprünge haben. Das National Human Genome Research Institute gibt für das Kopieren in einer menschlichen Zelle mehrere Stunden an.
Fehler summieren sich auf dieselbe Weise. Das Kopieren von 6 Milliarden Basenpaaren bedeutet, etwa 12 Milliarden neue Nukleotide einzubauen, eines gegenüber jeder Matrizenbase. Bei 1 Fehler unter 100.000 sind das vor jeder Überprüfung etwa 120.000 falsche Basen pro Teilung. Das Korrekturlesen behebt etwa 99 Prozent davon, sodass ungefähr 1200 übrig bleiben. Die Fehlpaarungsreparatur nach der Replikation senkt die Zahl weiter. Im Modell sind 2 eingebaute Fehler unter 84 Basenpaaren weit mehr als in Wirklichkeit; sie sind vorhanden, damit Sie die Korrektur sehen können.
Was das Modell auslässt
Das Modell zeigt eine Gabel. Echte Replikation beginnt an einem Ursprung und öffnet eine Blase mit zwei auseinanderwandernden Gabeln; die beiden Gabeln in E. coli laufen in entgegengesetzten Richtungen um das ringförmige Chromosom und treffen sich, wobei jede etwa einen halben Kreis kopiert. Die Fragmente und Primer des Modells sind verkürzt, und nur zwei Fehler sind an festen Stellen eingebaut.
Die Proteine sind weiche Körper, keine vermessenen Formen, und durchsichtig, damit Sie die DNA verfolgen können. Ihre Anordnung folgt Lehrbuchdiagrammen: Topoisomerase vor der Gabel, einzelstrangbindende Proteine auf freier Matrize, eine ringförmige Klemme um jede neue Doppelhelix neben ihrer Polymerase. Die beiden Polymerasen sind als getrennte Körper gezeichnet, damit jeder neue Strang leicht zu verfolgen ist. Auch der Leitstrang-Primer ganz links bleibt erhalten, weil die Gabel, die ihn entfernen würde, außerhalb des linken Randes liegt.
Die Proteinnamen folgen Bakterien: DNA-Polymerase III übernimmt das Hauptkopieren, DNA-Polymerase I ersetzt Primer. Eukaryotische Zellen verwenden für dieselben Schritte andere Enzyme: Pol ε am Leitstrang, Pol δ am Folgestrang, PCNA als Klemme sowie FEN1 mit Beiträgen von RNase H bei der Primerverarbeitung. Außerdem müssen sie beim Vorbeiziehen der Gabel Histone entfernen und wieder einsetzen, was laut OpenStax möglicherweise ein Teil der Erklärung ist, warum eukaryotische Gabeln langsamer sind.
Mehrere Zahlen auf der Bühne sind Modellwerte. Die Fragmentlänge entspricht der Geschwindigkeit mal einem Primer-Intervall von 2,8 Sekunden Bildschirmzeit, begrenzt auf 7 bis 36 Nukleotide, sodass 5 bp/s 14 nt ergeben. Das manuelle Paaren einer Base bewegt die Gabel um ein Basenpaar und überspringt die beiden programmierten Fehler, sodass nur Ihre eigenen Entscheidungen falsch sein können. Die Rechner unter der Bühne nehmen gleichmäßig verteilte, gleichzeitig aktive Ursprünge und nie stockende Gabeln an; sie skalieren den Zellumsatz eines 70 kg schweren Erwachsenen proportional zum Körpergewicht.
Woher wir wissen, dass jede neue Helix einen alten Strang behält
Als James Watson und Francis Crick 1953 die Doppelhelix veröffentlichten, bemerkten sie, dass die Paarungsregel einen Kopiermechanismus nahelegte. Es gab drei Vorstellungen davon, wie dieser funktionieren könnte. Bei der semikonservativen Replikation behält jede neue Helix einen alten Strang und erhält einen neuen. Bei der konservativen Replikation bleibt die alte Helix vollständig erhalten, während daneben eine ganz neue entsteht. Bei der dispersiven Replikation sind alte und neue DNA stückweise entlang beider Stränge vermischt.
Matthew Meselson und Franklin Stahl am California Institute of Technology prüften diese Vorstellungen 1958. Sie züchteten E. coli über viele Generationen auf einem Medium, dessen einziger Stickstoff das schwere Isotop Stickstoff-15 war, überführten die Zellen dann in gewöhnlichen Stickstoff-14 und nahmen während der Teilungen Proben. In einem Cäsiumchloridgradienten zentrifugierte DNA sammelt sich dort, wo ihre Dichte der Lösung entspricht, sodass schwere und leichte DNA getrennte Banden bilden. Vor dem Wechsel gab es eine schwere Bande. Nach einer Generation gab es eine einzige Bande auf halbem Weg zwischen schwer und leicht, was die konservative Replikation ausschloss. Nach zwei Generationen gab es zwei Banden, eine hybride und eine leichte, was das dispersive Modell ausschloss. Jede neue Helix hatte einen alten Strang behalten. Schalten Sie im Reiter „Steuerung“ „Meselson und Stahl“ ein, um diese drei Röhrchen in der Anzeige zu sehen.
Die Fragmente des Folgestrangs fanden Reiji Okazaki und seine Kollegen; sie berichteten 1968, dass neu gebildete DNA zunächst als kurze Stücke erscheint, die später zu langen Strängen verbunden werden. Die Enzyme selbst waren bereits früher im Reagenzglas untersucht worden. Arthur Kornberg und Severo Ochoa teilten sich den Nobelpreis für Physiologie oder Medizin 1959 „für ihre Entdeckung der Mechanismen bei der biologischen Synthese von Ribonukleinsäure und Desoxyribonukleinsäure“, wie das Nobelkomitee es formulierte.
Wie viele Gabeln schaffen ein menschliches Genom in Stunden?
Eine Gabelgeschwindigkeit ist eine Strecke entlang einer Matrize pro Zeiteinheit, nicht die Gesamtleistung aller Polymerasen einer Zelle. Bei angenommenen konstanten 1000 nt/s decken zwei bakterielle Gabeln pro Sekunde 2000 Basenpaare des elterlichen Chromosoms ab. Ein Chromosom mit 4.600.000 bp benötigt daher 4.600.000 ÷ 2000 = 2300 Sekunden, also etwa 38 Minuten. Die ungefähr 42 Minuten des Lehrbuchs sind mit diesen gerundeten Ausgangswerten vereinbar; die Rechnung sagt nicht die Zeit zwischen bakteriellen Zellteilungen voraus. Unter günstigen Wachstumsbedingungen können Bakterien eine weitere Replikationsrunde beginnen, bevor die vorherige endet.
Für ein menschliches Beispiel verwenden wir ein gerundetes haploides Genom von 3.200.000.000 bp und nehmen an, dass 10.000 gleichmäßig verteilte Ursprünge gleichzeitig starten. Jeder Ursprung entsendet zwei Gabeln mit 50 nt/s, insgesamt also 20.000 Gabeln und eine Abdeckungsrate von 1.000.000 bp/s. Teilt man die Genomlänge durch diese Rate, erhält man 3200 Sekunden, etwa 53 Minuten. Zwischen Ursprüngen liegen im Mittel 320.000 bp, und jede Gabel legt die Hälfte dieser Strecke zurück, bevor sie ihre Nachbarin trifft. Dasselbe Ergebnis folgt aus 160.000 ÷ 50.
Diese bewusst ideale Rechnung ist kürzer als die mehreren Stunden, die eine echte menschliche Zelle braucht. Ursprünge starten nicht alle gleichzeitig; verschiedene Chromosomenregionen werden zu unterschiedlichen Zeiten repliziert, und Gabeln treffen auf Chromatin und andere Hindernisse. Wären unter denselben Annahmen nur 2000 Ursprünge gleichzeitig aktiv, ergäbe die Rechnung 16.000 Sekunden, etwa 4,4 Stunden. Diese Ursprungszahlen sind angenommene Beispiele, keine Messwerte eines bestimmten Gewebes. Der Vergleich erklärt, weshalb allein das Zählen möglicher Ursprünge die Länge der S-Phase nicht bestimmen kann.
Die meisten menschlichen Körperzellen besitzen zwei Chromosomensätze. Im selben gerundeten Maßstab bedeutet das 6.400.000.000 bp zum Verdoppeln statt der haploiden 3.200.000.000 bp. Werden sowohl DNA-Menge als auch Zahl aktiver Ursprünge verdoppelt, bleibt die ideale Fertigstellungszeit unverändert. Die frühere Angabe von 6 Milliarden ist eine gröbere diploide Näherung, keine andere Regel zum Zählen von Basenpaaren.
Vom falschen Nukleotid zur bleibenden Mutation
Ein falscher Einbau, eine dem Korrekturlesen entkommene Fehlpaarung und eine nach der Reparatur erhaltene Mutation sind unterschiedliche Zählgrößen. Die Übersichtsarbeit von Fijalkowska und Kollegen liefert ein nützliches bakterielles Beispiel: anfängliche Einbaufehler um 10⁻⁵, ein entkommender Anteil um 10⁻² nach dem Korrekturlesen und um 10⁻³ nach der Fehlpaarungsreparatur. Multipliziert ergibt das 10⁻¹⁰ Fehler pro kopierter Base und Runde. Dies sind näherungsweise Beiträge, abhängig von Fehlpaarung und Sequenz, keine universellen Konstanten für jede Polymerase.
Für eine Rechenübung behalten wir das zuvor gerundete diploide Genom von 6 Milliarden bp bei. Beim Kopieren beider elterlichen Stränge werden etwa 12 Milliarden neue Nukleotide eingebaut. Bei 10⁻⁵ ergeben sich 120.000 anfängliche Fehler; bei 10⁻⁷ nach dem Korrekturlesen sind es 1200. Eine Endrate von 10⁻⁹ ließe erwartete 12 Fehler über die Replikationsprodukte verteilt zurück, während 10⁻¹⁰ 1,2 ergäbe. Ein nicht ganzzahliger Erwartungswert beschreibt einen Mittelwert über viele Teilungen; eine Zelle kann keinen Bruchteil einer veränderten Base enthalten. Korrekturlesen allein bewirkt nicht die gesamte Verringerung von 10⁻⁵ auf 10⁻⁹ oder 10⁻¹⁰.
Machen Sie aus diesen beispielhaften Summen nicht die Behauptung, jede menschliche Teilung erzeuge genau diese Zahl von Mutationen. Eine Fehlpaarung enthält auf ihren beiden Strängen noch widersprüchliche Anweisungen. Reparatur kann sie entfernen, oder eine spätere Kopierrunde kann die veränderte Sequenz in einem Nachkommen festschreiben. Die Produkte verteilen sich außerdem auf Tochterzellen. DNA-Schäden, Zelltyp und die Genauigkeit verschiedener Enzyme beeinflussen beobachtete Mutationszahlen. Das feste Fehlerpaar auf dem Bildschirm prüft die Korrekturabfolge, keine Verteilung von Mutationsraten; erneutes Abspielen zieht keine Stichprobe einer anderen Zelle.
Wie viele Fragmente müssen fertiggestellt werden?
Die Fragmentlänge verändert den Arbeitsaufwand, ohne die zu kopierende DNA-Menge zu ändern. Mit der ungefähren bakteriellen Fragmentlänge von 1200 nt aus der Übersichtsarbeit liegt der Folgestrangbeitrag für ein ringförmiges Chromosom von 4.600.000 bp in der Größenordnung 4.600.000 ÷ 1200, also etwa 3800 Fragmente. Warum nicht die doppelte Chromosomenlänge teilen? An jeder Gabel ist einer der beiden neu gebildeten Stränge ein Folgestrang. Über beide Gabeln summiert entspricht die diskontinuierlich gebildete Länge ungefähr einer Chromosomenlänge, nicht beiden neuen Strängen zusammen.
Bei einem gerundeten diploiden menschlichen Genom von 6.400.000.000 bp und durchschnittlich 200 nt langen Fragmenten beträgt die entsprechende Schätzung 32.000.000 Fragmente. Endeffekte und regionale Unterschiede verhindern, dass diese Divisionen exakte Zählungen ergeben. Dennoch zeigen sie, weshalb Primerentfernung und Ligation keine seltenen Abschlussarbeiten sein können. Eine Zelle muss in einer einzigen S-Phase Millionen Verbindungsstellen bearbeiten. Kurze Fragmente in Eukaryoten hängen mit der Nukleosomenorganisation zusammen und bedeuten nicht, dass menschliche Polymerasen nur 200 Nukleotide synthetisieren können, bevor sie jede Aktivität verlieren.
Das Exponat verkürzt jedes Fragment auf 14 nt und jeden Primer auf 5 nt. Dadurch nimmt ein Primer einen viel größeren Anteil eines Fragments ein als in den biologischen Beispielen. Schätzen Sie die RNA-Menge eines Chromosoms nicht aus dem Anteil violetter Kugeln auf dem Bildschirm. Achten Sie stattdessen auf die Reihenfolge: Der Primer liefert den Start, DNA ersetzt den Primer, und Ligase schließt den verbleibenden Einzelstrangbruch im Rückgrat. Ligase liest nicht selbst eine Matrize ab und füllt keinen langen fehlenden DNA-Abschnitt allein auf.
Chromosomenenden und PCR lösen unterschiedliche Probleme
Der gewöhnliche Folgestrangzyklus hängt davon ab, dass beim Entfernen eines Primers ein Nachbarfragment ein verlängerbares 3′-Ende bereitstellt. Am Ende eines linearen Chromosoms endet diese Anordnung. Telomere sind wiederholte DNA-Sequenzen mit zugehörigen Schutzproteinen an Chromosomenenden. In Zellen mit aktiver Telomerase nutzt das Enzym seine eigene RNA als Matrize, um ein DNA-Ende zu verlängern; andere Replikationskomponenten können anschließend komplementäre DNA kopieren. Telomerase kopiert nicht das ganze Genom und klebt nicht einfach die beiden Chromosomenenden zusammen. Die Gabel dieses Exponats ist ein innerer Abschnitt; ihre abschließende Trennung simuliert daher keine Telomerverkürzung.
Telomerverlust ist auch keine exakte Uhr, die durch Zählen von Teilungen das Alter eines Menschen angibt. NHGRI beschreibt die Verkürzung und das Auffüllen der Wiederholungen in bestimmten sich teilenden Zelltypen. Diese Prozesse unterscheiden sich zwischen Zellen. Eine Erklärung des Endreplikationsproblems ist kein Beleg dafür, dass eine Steigerung der Telomerase eine sichere Behandlung gegen das Altern wäre.
PCR kopiert einen ausgewählten DNA-Abschnitt außerhalb einer Zelle. Wie NHGRI erklärt, trennt Erhitzen die Matrizenstränge, und eine hitzebeständige Polymerase synthetisiert während wiederholter Temperaturzyklen neue DNA. Bei einer Standard-PCR bestimmen zugesetzte DNA-Primer die Grenzen des Ziels; Primase erzeugt nicht fortlaufend RNA-Primer an einer wandernden Gabel. Erhitzen ersetzt die strangöffnende Aufgabe der Helikase, aber nicht jede Aufgabe der zellulären Replikationsmaschinerie.
Unter der Annahme idealer Verdopplung erzeugen 20 Zyklen aus einer doppelsträngigen Ausgangsmatrize 2²⁰ = 1.048.576 Kopien. Das ist eine theoretische Vervielfachung, kein garantierter Laborertrag: Reagenzien werden knapp, und die Amplifikation ist nicht vollkommen effizient. PCR vervielfältigt außerdem das gewählte Ziel, statt automatisch alle Chromosomen einer Zelle zu verdoppeln. Der Regler „Geschwindigkeit“ des Exponats stellt keinen PCR-Temperaturzyklus dar.
Die Gabel selbst ziehen und Basen paaren
Der Helikasering ist der Griff der gesamten Maschine. Ziehen Sie ihn entlang der Helix, und die Gabel öffnet sich genau so weit, wie Sie ziehen: Die Elternstränge trennen sich, Bindungsproteine besetzen die freie Matrize, und die Polymerasen folgen. „Geschwindigkeit“ folgt Ihrer Hand, sodass ein schneller Zug den Höchstwert von 20 bp/s einstellen kann. Ziehen Sie andersherum, geschieht nichts. Eine echte Helikase bewegt sich unter Energieverbrauch aus ATP auf einem Strang in eine Richtung; die Gegenrichtung übernimmt eine zweite Gabel vom selben Ursprung.
Mit „Nächste Base paaren“ übernehmen Sie die Leitstrang-Polymerase. Die Gabel hält an, eine weiße Kugel markiert die nächste freie Stelle am neuen Strang, und ein roter Ring kennzeichnet die gegenüberliegende Matrizenbase. Vier Schaltflächen bieten A, T, G und C an. Die richtige Wahl folgt der Paarungsregel, A mit T und G mit C, und der Strang wächst um ein Basenpaar. Eine falsche Wahl bleibt kurz erhalten; bei eingeschaltetem „Korrekturlesen“ geht die Polymerase dann eine Position zurück, schneidet sie heraus und setzt die richtige Base ein, genau wie die 3′-nach-5′-Exonuklease. Ist „Korrekturlesen“ ausgeschaltet, bleibt die falsche Base umringt erhalten, und die Kopie trägt eine Fehlpaarung.
Eine echte Polymerase wählt nicht durch Lesen von Buchstaben. Das eintreffende Nukleotid muss im aktiven Zentrum zur Form eines korrekten Paars passen; ein falsches Paar passt schlecht und wird viel langsamer angefügt. Dennoch ist vor dem Korrekturlesen etwa 1 von 100.000 Einbauten falsch, sodass 20 richtige Entscheidungen hintereinander kein Beweis für einen zuverlässigen Kopierer sind. Das Paarungsspiel löst außerdem den automatischen Ablauf ab: Während Sie wählen, steht die Uhr still, und die programmierten Fehler an den Positionen 24 und 54 werden übersprungen.
Tippen Sie auf ein Protein auf der Bühne oder auf sein Namensschild, um seine Aufgabe zu lesen. Die Karten wiederholen die Teileliste in Kurzform, sodass Sie die Topoisomerase vor der Gabel, die Primase an der Folgestrangmatrize, die beiden Polymerasen mit ihren Klemmen, DNA-Polymerase I und die Ligase kennenlernen können, ohne die Bühne zu verlassen.
Warum eine schnellere Gabel längere Fragmente hinterlässt
Primase beginnt Primer nicht an festen DNA-Stellen. In E. coli kommt sie aus der Lösung, trifft die Helikase, schreibt einen Primer und geht wieder; Tougu und Marians zeigten 1996, dass dieses Treffen etwa alle 1 bis 2 Sekunden stattfindet und die Fragmentlänge bestimmt. Die Gabel bewegt sich unterdessen etwa 1000 Nukleotide pro Sekunde. Ein Fragment alle 1 bis 2 Sekunden bei 1000 Nukleotiden pro Sekunde ergibt 1000 bis 2000 Nukleotide lange Fragmente, passend zu den ungefähr 1200, die in Bakterien gemessen werden.
Das Modell behält diese Idee mit einer langsameren Uhr bei. Alle 2,8 Sekunden Bildschirmzeit beginnt ein neuer Primer; die Fragmentlänge entspricht daher „Geschwindigkeit“ mal 2,8. Bei standardmäßigen 5 bp/s ergibt das 14 nt und 6 Fragmente auf den 84 Basenpaaren. Bei 13 bp/s und darüber sind die Fragmente 36 nt lang, und nur 2 passen hinein; bei 3 bp/s sind sie 8 nt lang, und es gibt 12. Unterhalb von 3 bp/s behält das Modell 7 nt als kürzestes Fragment bei, damit ein Primer von 5 nt noch Platz für DNA lässt. Ändern Sie „Geschwindigkeit“ während eines Durchlaufs, wird der gesamte Folgestrang neu gezeichnet, als hätte die Gabel immer das neue Tempo gehabt.
Die andere Regel bleibt bei jeder Geschwindigkeit gleich: Jedes Fragment beginnt mit RNA und endet am vorherigen, und jede Verbindung braucht DNA-Polymerase I und eine Ligase. Eine langsame Gabel mit vielen kurzen Fragmenten hinterlässt daher mehr zu entfernende Primer und mehr zu schließende Einzelstrangbrüche. In Eukaryoten sind die Fragmente kürzer, etwa 200 Nukleotide, weil sie dem Abstand der Nukleosomen folgen. Eine menschliche Zelle stellt in jeder S-Phase mehrere zehn Millionen davon fertig.
Wie lange braucht eine menschliche Zelle zum Kopieren ihrer DNA?
Eine menschliche Körperzelle enthält etwa 6,4 Milliarden Basenpaare, zwei Sätze zu 3,2 Milliarden. Eine Gabel mit 50 Nukleotiden pro Sekunde bräuchte 6.400.000.000 ÷ 50 = 128 Millionen Sekunden, etwa 4 Jahre. Ein Ursprung mit zwei ausgehenden Gabeln halbiert dies auf etwa 2 Jahre. Der Rechner unter der Bühne beginnt dort, mit einem einzigen Ursprung, und lässt Sie die Zahl gleichzeitig startender Ursprünge bis auf 100.000 erhöhen, den Höchstwert, den OpenStax für das menschliche Genom nennt.
Bei 50 Nukleotiden pro Sekunde reichen 2223 Ursprünge (4446 Gabeln) aus, um in 8 Stunden fertig zu werden; bei 100 Nukleotiden pro Sekunde etwa die Hälfte, 1112. Mit 10.000 Ursprüngen sinkt die ideale Zeit bei 50 nt/s auf 107 Minuten. Coopers Zellbiologielehrbuch nennt etwa 8 Stunden für die S-Phase einer menschlichen Zelle, die sich alle 24 Stunden teilt, OpenStax etwa 10. Echte Zellen nutzen mehr Ursprünge als rechnerisch nötig, weil diese während der S-Phase nacheinander starten und Gabeln an beschädigter oder dicht gepackter DNA stocken.
Bakterien kommen mit einem Ursprung aus, weil ihr Chromosom kurz und ihre Gabeln schnell sind. Zwei Gabeln mit 1000 Nukleotiden pro Sekunde kopieren die 4,6 Millionen Basenpaare von E. coli in 4.600.000 ÷ 2000 = 2300 Sekunden, etwa 38 Minuten, nahe den 42 des Lehrbuchs. Frühe Fruchtfliegenembryonen gehen den umgekehrten Weg: Ein ganzer Zellzyklus dauert etwa 8 Minuten, weshalb die DNA von dicht beieinanderliegenden Ursprüngen aus kopiert werden muss.
Wie viel DNA kopiert Ihr Körper an einem Tag?
Sender und Milo schätzten 2021, dass ein erwachsener Körper täglich etwa 330 Milliarden Zellen ersetzt, davon fast 90 Prozent Blutzellen, bei insgesamt etwa 30 Billionen menschlichen Zellen. Jede neue Zelle trägt eine vollständige DNA-Kopie, sodass täglich mindestens ebenso viele Genomkopien entstehen. Eine Kopie umfasst 6,4 Milliarden Basenpaare; bei 0,34 nm pro Basenpaar sind das etwa 2,2 m DNA.
Für einen 70 kg schweren Erwachsenen ergeben 330 Milliarden Kopien zu 2,2 m ausmultipliziert etwa 718 Millionen km DNA pro Tag, das 4,8-Fache der 149,6 Millionen km von der Erde zur Sonne, oder etwa 8300 km pro Sekunde. Der Rechner unter der Bühne skaliert die Zellzahl mit Ihrem eingegebenen Gewicht: Bei 60 kg ergeben sich täglich etwa 616 Millionen km kopierte DNA. Das sind grobe Modellzahlen. Der Zellumsatz unterscheidet sich zwischen Menschen und mit dem Alter; rote Blutzellen verlieren beim Reifen ihren Kern, und manche neuen Zellen stammen aus Stammzellen, die ihre DNA an einem anderen Ort kopieren, als die Zelle schließlich eingesetzt wird.
Die Summe erinnert daran, wie gut das Kopieren sein muss. Bei einer endgültigen Fehlerrate von etwa 1 zu einer Milliarde erhält jede Genomkopie noch eine Handvoll Veränderungen, und die meisten landen in DNA, die kein Protein verändert. Reparatur, Zelltod und das Immunsystem entfernen viele Zellen, bei denen etwas schiefläuft.
Von Watson und Crick zur Gabeluhr: eine kurze Geschichte
Watson und Crick beendeten ihre Arbeit über die Doppelhelix von 1953 mit der Bemerkung, dass die Basenpaarung einen Kopiermechanismus nahelegte. 1956 stellte Arthur Kornbergs Gruppe mit einem Enzym aus E. coli, DNA-Polymerase I, DNA im Reagenzglas her; diese Arbeit wurde mit dem geteilten Nobelpreis für Physiologie oder Medizin 1959 gewürdigt. 1958 zeigten Meselson und Stahl mit schwerem Stickstoff, dass jede neue Doppelhelix einen alten Strang behält. 1963 fotografierte John Cairns ein ganzes E.-coli-Chromosom beim Kopieren: einen einzelnen, etwa 1 mm langen Ring mit wandernden Gabeln.
Als Nächstes kamen die Stücke des Folgestrangs. 1967 fanden mehrere Labore die DNA-Ligase, und Martin Gellert zeigte, dass E.-coli-Extrakte die Enden von Lambda-DNA zu Ringen schließen. 1968 markierten Reiji Okazaki, Tsuneko Okazaki und Kollegen neue DNA wenige Sekunden lang und fanden sie in kurzen Stücken, die später verbunden wurden. 1969 fanden Paula De Lucia und John Cairns eine Mutante mit sehr wenig Polymerase I, die ihre DNA trotzdem kopierte; dies deutete auf ein anderes Hauptenzym hin, Polymerase III.
Spätere Arbeiten erklärten den Rest der Maschine auf der Bühne. Watson beschrieb 1972 das Endproblem linearer DNA, Gellerts Gruppe fand 1976 die DNA-Gyrase, und Greider und Blackburn entdeckten 1985 die Telomerase. 1992 klärte Kuriyans Gruppe die Struktur der Gleitklemme auf, eines Rings um die DNA. Kary Mullis teilte sich 1993 den Chemiepreis für PCR, die Okazaki-Fragmentuhr von Tougu und Marians folgte 1996, und 2015 teilten sich Lindahl, Modrich und Sancar den Chemiepreis für DNA-Reparatur. Der Katalog unter der Bühne enthält für jede Entdeckung eine Karte mit der Originalarbeit.
Prüfungen auf der Bühne
Pausieren Sie zunächst mitten im Kopieren und schalten Sie unter „Steuerung“ die „Basenpaarfarben“ aus. Finden Sie den durchgehenden orangefarbenen Leitstrang und anschließend einen violetten Primer auf einem türkisfarbenen Folgestrangfragment. Verfolgen Sie die neuen Stränge anhand der Richtungsangaben von 5′ nach 3′. Ihre Wachstumsrichtungen müssen chemisch übereinstimmen, obwohl eine Polymerase zur Gabel wandert und die andere von ihr weg arbeitet. „Folgestrang“ bedeutet nicht, dass dieser Strang von 3′ nach 5′ synthetisiert wird.
Spielen Sie danach dieselbe Region mit ein- und ausgeschaltetem „Korrekturlesen“ ab, ohne „Geschwindigkeit“ zu ändern. Vergleichen Sie den magentafarbenen Fehlermarker mit den Anzeigen „Kopiert“ und „Okazaki“, wenn die Polymerase pausiert. So isolieren Sie die programmierte Verzögerung durch das Korrekturlesen. Eine Geschwindigkeitsänderung zwischen Durchläufen würde auch die Animationsuhr verändern und wäre kein fairer Vergleich. Schnelleres Abspielen ohne Korrekturlesen belegt nicht, dass echte Zellen vom Abschalten der Reparatur profitieren.
Schalten Sie schließlich „Meselson und Stahl“ ein und vergleichen Sie die Röhrchen aufeinanderfolgender Generationen. Nach einer Generation verwirft die mittlere Bande das konservative Modell, allein aber noch nicht dispersives Kopieren. Die zweite Generation liefert die Unterscheidung: getrennte hybride und leichte Banden statt einer einzelnen Bande, die sich zunehmend zur leichten Position verschiebt. Stickstoff-15 ist ein stabiles Isotop als Dichtemarkierung, keine radioaktive Markierungssubstanz. Die Röhrchen zeigen DNA-Dichte, nicht die Farbe neu synthetisierter Basen. Animation und Röhrchenexperiment beantworten verschiedene Fragen: Die eine veranschaulicht Gabelabläufe, das andere prüft die Verteilung elterlichen Materials auf Tochtermoleküle.
Ziehen Sie dann die Helikase schnell und langsam, lassen Sie die Gabel jeweils das Ende erreichen und zählen Sie die Folgestrangfragmente in der Okazaki-Anzeige. Geben Sie zuvor unter „Fragmente vorhersagen“ eine Vorhersage ab. Paaren Sie schließlich Basen von Hand mit ein- und ausgeschaltetem „Korrekturlesen“ und vergleichen Sie die Anzeige „Korrekturlesen“: Im ersten Fall werden falsche Entscheidungen zurückgenommen, im zweiten als verblieben gezählt.
Fragen
Warum kann die DNA-Polymerase nicht beide Stränge kontinuierlich aufbauen?
Sie kann Nukleotide nur an ein 3′-Ende anfügen, sodass jeder neue Strang von 5′ nach 3′ wächst. Die beiden Matrizen verlaufen entgegengesetzt, weshalb nur ein neuer Strang zur sich öffnenden Gabel wachsen kann. Der andere muss in Stücken entstehen, die von ihr weg wachsen.
Was unterscheidet Leitstrang und Folgestrang?
Der Leitstrang entsteht von einem einzigen Primer aus zusammenhängend und folgt der Helikase. Der Folgestrang entsteht in kurzen Okazaki-Fragmenten, jedes mit eigenem Primer, die später durch DNA-Ligase verbunden werden.
Warum besteht der Primer aus RNA?
Die DNA-Polymerase kann keine neue Kette beginnen, die Primase als RNA-Polymerase dagegen schon. Die kurze RNA gibt der DNA-Polymerase ein 3′-Ende zum Verlängern. Später wird die RNA entfernt und durch DNA ersetzt.
Wie oft macht die DNA-Polymerase einen Fehler?
Nature Education nennt während der Synthese etwa 1 falsches Nukleotid unter 100.000. Korrekturlesen behebt etwa 99 Prozent davon, und die Fehlpaarungsreparatur nach der Replikation fängt weitere ab.
Wie schnell wird DNA kopiert?
Laut OpenStax etwa 1000 Nukleotide pro Sekunde an jeder Gabel in E. coli. Für menschliche Zellen nennt OpenStax 50 bis 100 Nukleotide pro Sekunde, Nature Education etwa 40. Viele Gabeln arbeiten gleichzeitig.
Was bedeutet semikonservativ?
Jede der beiden neuen Doppelhelices enthält einen Strang des ursprünglichen Moleküls und einen neu gebildeten Strang. Meselson und Stahl zeigten dies 1958 mit schwerem und leichtem Stickstoff.
Was geschieht an den Enden eines Chromosoms?
An einem linearen Chromosom kann der letzte Primer des Folgestrangs nicht durch DNA ersetzt werden, weshalb sich die Enden bei jeder Teilung etwas verkürzen würden. Telomerase, ein Enzym mit eigener RNA-Matrize, fügt in den Zellen, in denen sie aktiv ist, TTAGGG-Wiederholungen an die Enden an.
Wächst der Folgestrang in die entgegengesetzte chemische Richtung?
Nein. Beide neuen Stränge wachsen von 5′ nach 3′. Der diskontinuierliche Strang wächst in einzelnen Fragmenten von der Gabel weg; seine Syntheserichtung ist nicht umgekehrt.
Erklärt Korrekturlesen allein die endgültige Fehlerrate?
Nein. Basenauswahl, Korrekturlesen und Fehlpaarungsreparatur leisten jeweils eigene Verringerungen. Das ungefähre bakterielle Beispiel von 10⁻⁵ bis 10⁻¹⁰ schließt alle ein; es ist keine universelle Mutationszahl für menschliche Zellen.
Ist Stickstoff-15 radioaktiv?
Nein. Es ist ein stabiles Stickstoffisotop. Meselson und Stahl verfolgten Dichteunterschiede in DNA, statt radioaktiven Zerfall nachzuweisen.
Ist PCR dasselbe wie die Gabel auf dem Bildschirm?
Beide verwenden Matrize und Polymerase, aber Standard-PCR trennt Stränge durch Erhitzen und wählt mit zugesetzten DNA-Primern ein Ziel. Das Modell zeigt dagegen eine helikasebetriebene zelluläre Gabel mit RNA-Primern und Folgestrangverarbeitung.
Warum sind manche Okazaki-Fragmente länger als andere?
Ihre Länge hängt davon ab, wie oft die Primase einen neuen Primer beginnt, verglichen mit der Bewegungsgeschwindigkeit der Gabel. In E. coli trifft die Primase etwa alle 1 bis 2 Sekunden auf die Helikase, während die Gabel etwa 1000 Nukleotide pro Sekunde zurücklegt; daraus ergeben sich Fragmente von 1000 bis 2000 Nukleotiden; eukaryotische Fragmente haben etwa 200. Auf der Bühne erzeugt eine höhere „Geschwindigkeit“ weniger, längere Fragmente.
Wie viel DNA kopiert mein Körper täglich?
Bei einem Erwachsenen werden täglich ungefähr 330 Milliarden Zellen ersetzt, und jede neue Zelle braucht eine Kopie von etwa 6,4 Milliarden Basenpaaren, ungefähr 2,2 m DNA. Das summiert sich auf mehrere Hundert Millionen Kilometer täglich, ein Mehrfaches des Abstands zwischen Erde und Sonne. Der Rechner unter der Bühne ermittelt dies für Ihr Gewicht als grobe Schätzung.
Begriffe
- Replikationsgabel: der Y-förmige Bereich, in dem die Doppelhelix geöffnet und kopiert wird.
- Helikase: das Enzym, das durch Lösen der Wasserstoffbrücken zwischen Basenpaaren die beiden Stränge trennt.
- Topoisomerase: ein Enzym, das durch Schneiden und Wiederverschließen von DNA die Überverdrillung vor der Gabel abbaut.
- Einzelstrangbindendes Protein (SSB): ein Protein, das einzelsträngige DNA bedeckt und ihre erneute Helixbildung verhindert.
- Primase: die RNA-Polymerase, die Primer bildet.
- Primer: ein kurzer RNA-Strang, der der DNA-Polymerase ein 3′-Ende als Ausgangspunkt gibt.
- Leitstrang: der neue Strang, der kontinuierlich zur Gabel hin aufgebaut wird.
- Folgestrang: der neue Strang, der in Stücken von der Gabel weg entsteht.
- Okazaki-Fragment: eines der kurzen Stücke des Folgestrangs.
- Gleitklemme: ein ringförmiges Protein, das die DNA-Polymerase an der DNA hält (PCNA in Eukaryoten).
- DNA-Ligase: das Enzym, das einen Einzelstrangbruch durch Bildung einer Phosphodiesterbindung verschließt.
- Korrekturlesen: Entfernen eines falsch angefügten Nukleotids durch die 3′-nach-5′-Exonuklease der Polymerase.
- Semikonservative Replikation: Kopieren, bei dem jede neue Helix einen alten Strang behält.
Quellen
OpenStax, Biology 2e, 14.2 DNA Structure and Sequencing (0,34 nm pro Basenpaar, 2 nm Breite, 3,4 nm und 10 Basenpaare pro Windung). https://openstax.org/books/biology-2e/pages/14-2-dna-structure-and-sequencing (geprüft am 16. Oktober 2026)
OpenStax, Biology 2e, 14.3 Basics of DNA Replication (Meselson und Stahl, semikonservative Replikation). https://openstax.org/books/biology-2e/pages/14-3-basics-of-dna-replication (geprüft am 16. Oktober 2026)
OpenStax, Biology 2e, 14.4 DNA Replication in Prokaryotes (Helikase, SSB, Topoisomerase, Primer mit 5 bis 10 Nukleotiden, Gleitklemme, DNA-Pol I und Ligase, E. coli mit 4,6 Millionen Basenpaaren in etwa 42 Minuten, 1000 Nukleotide pro Sekunde). https://openstax.org/books/biology-2e/pages/14-4-dna-replication-in-prokaryotes (geprüft am 16. Oktober 2026)
OpenStax, Biology 2e, 14.5 DNA Replication in Eukaryotes (6 Milliarden Basenpaare, bis zu 100.000 Ursprünge, 50 bis 100 Nukleotide pro Sekunde, Pol ε und Pol δ, PCNA, RNase H, Telomerase). https://openstax.org/books/biology-2e/pages/14-5-dna-replication-in-eukaryotes (geprüft am 16. Oktober 2026)
OpenStax, Biology 2e, 14.6 DNA Repair (Korrekturlesen durch 3′-Exonuklease, Fehlpaarungsreparatur). https://openstax.org/books/biology-2e/pages/14-6-dna-repair (geprüft am 16. Oktober 2026)
Nature Education, Scitable: Major Molecular Events of DNA Replication (etwa 40 Nukleotide pro Sekunde in Eukaryoten, Okazaki und Kollegen 1968). https://www.nature.com/scitable/topicpage/major-molecular-events-of-dna-replication-413/ (geprüft am 16. Oktober 2026)
Balakrishnan, L. und Bambara, R. A., Okazaki fragment metabolism, Cold Spring Harbor Perspectives in Biology 5, a010173 (2013) (Okazaki-Fragmente mit etwa 1200 Nukleotiden in Bakterien und etwa 200 in Eukaryoten). https://pmc.ncbi.nlm.nih.gov/articles/PMC3552508/ (geprüft am 16. Oktober 2026)
Nature Education, Scitable: DNA Replication and Causes of Mutation (etwa 1 Fehler pro 100.000 Nukleotide, Korrekturlesen behebt etwa 99 Prozent, Wobble-Paare). https://www.nature.com/scitable/topicpage/dna-replication-and-causes-of-mutation-409/ (geprüft am 16. Oktober 2026)
Nature Education, Scitable: Semi-Conservative DNA Replication: Meselson and Stahl (die drei Modelle und das Experiment von 1958). https://www.nature.com/scitable/topicpage/semi-conservative-dna-replication-meselson-and-stahl-421/ (geprüft am 16. Oktober 2026)
Meselson, M. und Stahl, F. W., The replication of DNA in Escherichia coli, Proceedings of the National Academy of Sciences 44, 671 bis 682 (1958). https://pmc.ncbi.nlm.nih.gov/articles/PMC528642/ (geprüft am 16. Oktober 2026)
Wang, J. C., Helical repeat of DNA in solution, Proceedings of the National Academy of Sciences 76, 200 bis 203 (1979) (10,4 ± 0,1 Basenpaare pro Windung). https://pmc.ncbi.nlm.nih.gov/articles/PMC382905/ (geprüft am 16. Oktober 2026)
National Human Genome Research Institute, Talking Glossary: DNA Replication (mehrere Stunden Kopierzeit für eine menschliche Zelle). https://www.genome.gov/genetics-glossary/DNA-Replication (geprüft am 16. Oktober 2026)
NobelPrize.org, The Nobel Prize in Physiology or Medicine 1959 (Severo Ochoa und Arthur Kornberg). https://www.nobelprize.org/prizes/medicine/1959/summary/ (geprüft am 16. Oktober 2026)
Fijalkowska, I. J., Schaaper, R. M. und Jonczyk, P., DNA replication fidelity in Escherichia coli: a multi-DNA polymerase affair, FEMS Microbiology Reviews 36, 1105 bis 1121 (2012) (aufeinanderfolgende Beiträge von Einbau, Korrekturlesen und Fehlpaarungsreparatur). https://pmc.ncbi.nlm.nih.gov/articles/PMC3391330/ (geprüft am 22. Oktober 2026)
National Human Genome Research Institute, Telomere (geschützte Chromosomenenden, Verkürzung und Telomerase in bestimmten Zellen). https://www.genome.gov/genetics-glossary/Telomere (geprüft am 22. Oktober 2026)
National Human Genome Research Institute, Polymerase Chain Reaction Fact Sheet (Trennung durch Hitze, Taq-Polymerase und wiederholte Kopierzyklen). https://www.genome.gov/about-genomics/fact-sheets/Polymerase-Chain-Reaction-Fact-Sheet (geprüft am 22. Oktober 2026)
Tougu, K. und Marians, K. J., The interaction between helicase and primase sets the replication fork clock, Journal of Biological Chemistry 271, 21398 bis 21405 (1996) (ein Okazaki-Fragment alle 1 bis 2 Sekunden in E. coli). https://doi.org/10.1074/jbc.271.35.21398 (geprüft am 27. Oktober 2026)
Sender, R. und Milo, R., The distribution of cellular turnover in the human body, Nature Medicine 27, 45 bis 48 (2021) (täglich etwa 330 Milliarden ersetzte Zellen, fast 90 Prozent Blutzellen). https://doi.org/10.1038/s41591-020-01182-9 (geprüft am 27. Oktober 2026)
Sender, R., Fuchs, S. und Milo, R., Revised estimates for the number of human and bacteria cells in the body, PLoS Biology 14, e1002533 (2016) (etwa 30 Billionen menschliche Zellen bei einem Referenzmann mit 70 kg). https://doi.org/10.1371/journal.pbio.1002533 (geprüft am 27. Oktober 2026)
Cooper, G. M., The Cell: A Molecular Approach, 2. Auflage, The Eukaryotic Cell Cycle (S-Phase etwa 8 Stunden eines menschlichen Zellzyklus von 24 Stunden). https://www.ncbi.nlm.nih.gov/books/NBK9876/ (geprüft am 27. Oktober 2026)
OpenStax, Biology 2e, 10.3 Control of the Cell Cycle (S-Phase etwa 10 Stunden in sich schnell teilenden menschlichen Zellen, Zellzyklus im Fruchtfliegenembryo etwa 8 Minuten). https://openstax.org/books/biology-2e/pages/10-3-control-of-the-cell-cycle (geprüft am 27. Oktober 2026)
Watson, J. D. und Crick, F. H. C., Molecular structure of nucleic acids, Nature 171, 737 bis 738 (1953). https://www.nature.com/articles/171737a0 (geprüft am 27. Oktober 2026)
Cairns, J., The bacterial chromosome and its manner of replication as seen by autoradiography, Journal of Molecular Biology 6, 208 bis 213 (1963). https://doi.org/10.1016/S0022-2836(63)80070-4 (geprüft am 27. Oktober 2026)
Gellert, M., Formation of covalent circles of lambda DNA by E. coli extracts, Proceedings of the National Academy of Sciences 57, 148 bis 155 (1967). https://doi.org/10.1073/pnas.57.1.148 (geprüft am 27. Oktober 2026)
Okazaki, R. und Kollegen, Mechanism of DNA chain growth, I, Proceedings of the National Academy of Sciences 59, 598 bis 605 (1968). https://doi.org/10.1073/pnas.59.2.598 (geprüft am 27. Oktober 2026)
De Lucia, P. und Cairns, J., Isolation of an E. coli strain with a mutation affecting DNA polymerase, Nature 224, 1164 bis 1166 (1969). https://doi.org/10.1038/2241164a0 (geprüft am 27. Oktober 2026)
Watson, J. D., Origin of concatemeric T7 DNA, Nature New Biology 239, 197 bis 201 (1972). https://doi.org/10.1038/newbio239197a0 (geprüft am 27. Oktober 2026)
Gellert, M., Mizuuchi, K., O'Dea, M. H. und Nash, H. A., DNA gyrase: an enzyme that introduces superhelical turns into DNA, Proceedings of the National Academy of Sciences 73, 3872 bis 3876 (1976). https://doi.org/10.1073/pnas.73.11.3872 (geprüft am 27. Oktober 2026)
Greider, C. W. und Blackburn, E. H., Identification of a specific telomere terminal transferase activity in Tetrahymena extracts, Cell 43, 405 bis 413 (1985). https://doi.org/10.1016/0092-8674(85)90170-9 (geprüft am 27. Oktober 2026)
Kong, X.-P., Onrust, R., O'Donnell, M. und Kuriyan, J., Three-dimensional structure of the beta subunit of E. coli DNA polymerase III holoenzyme: a sliding DNA clamp, Cell 69, 425 bis 437 (1992). https://doi.org/10.1016/0092-8674(92)90445-I (geprüft am 27. Oktober 2026)
NobelPrize.org, The Nobel Prize in Chemistry 1993 (Kary B. Mullis, PCR) und 2015 (Lindahl, Modrich und Sancar, DNA-Reparatur). https://www.nobelprize.org/prizes/chemistry/2015/summary/ (geprüft am 27. Oktober 2026)
Text und Simulation: CC BY-NC-SA 4.0, soweit nicht anders angegeben.
Themenpfad 7 von 8
Vom Herzschlag zur DNAWeitere Exponate

So funktioniert Genom-Editierung mit CRISPR-Cas9
Eine Guide-RNA liest nur 20 Buchstaben der DNA, und das genügt meist, um eine einzige Stelle unter den 3 Milliarden Basenpaaren eines menschlichen Genoms zu finden.

ATP-Synthase: Funktion und Rotation selbst untersuchen
In Mitochondrien dreht sich der Rotor der ATP-Synthase etwa 100-mal pro Sekunde. Jede volle Umdrehung setzt drei ATP-Moleküle frei.
Spaziergang durch eine Zelle: Tier, Pflanze und Bakterium
Millionenfach vergrößert ist ein Mitochondrium etwa so groß wie ein Sofa, ein ganzes E. coli ist 2 m lang, und das Kinesin, das neben Ihnen ein Vesikel schleppt, läuft mit 0,8 Metern pro Sekunde.
Erregungsleitung am Axon: Nervensignale selbst auslösen
Eine Nervenzelle liegt bei etwa −70 mV. Hebt ein Reiz sie auf etwa −55 mV, erzeugt sie einen stets gleich großen Impuls.

Warum sind Mammutbäume so groß? Wachstum und Jahresringe
Am Fuß des 83,8 m hohen, etwa 2200 Jahre alten General Sherman Tree stehen, seinen Stamm besteigen und den Zug auf das Wasser in der Höhe untersuchen.

Dinosaurier-Größenvergleich: 172 Tiere neben einem Menschen
Ein 600 m großer Park mit 172 Urzeittieren in Originalgröße, von den ersten Dinosauriern bis T. rex, nach Zeitaltern geordnet.