FIG. 59Comment ça marche
Comment fonctionne la réplication de l’ADN : fragments d’Okazaki en 3D
Une ADN polymérase ne peut ajouter qu’à une extrémité d’un brin : à chaque fourche de réplication, un nouveau brin s’allonge d’un seul tenant et l’autre en courts fragments.
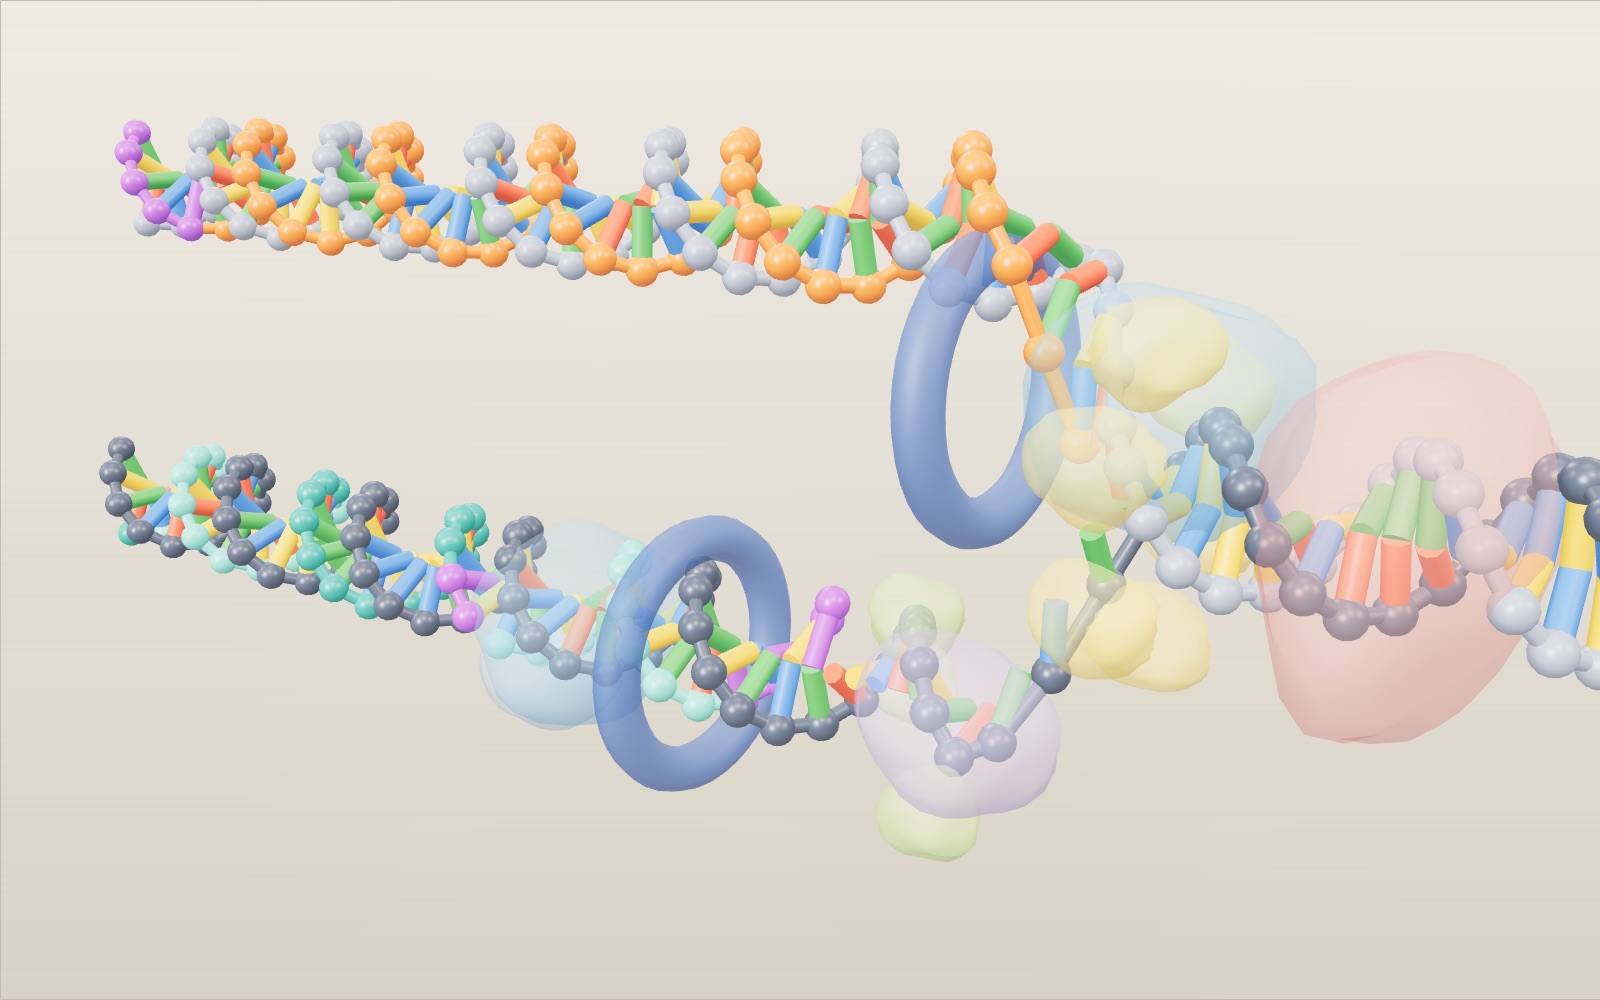
Cet appareil ne peut pas afficher le modèle 3D. Les étapes de la visite ci-dessous se lisent sous forme de texte.
1 / 11 84 paires de bases d’ADN, à l’échelleCette portion mesure environ 29 nm de long. Les barres en dessous donnent l’échelle : un tour représente 10,5 paires de bases (3,57 nm) en solution, tandis que les manuels arrondissent à 10 paires de bases et 3,4 nm. La séquence est inventée pour le modèle.
Faites glisser pour tourner. Molette ou pincement pour zoomer.
Comment une cellule copie-t-elle son ADN avant de se diviser ?
La réplication de l’ADN se déroule en plusieurs étapes au niveau d’une fourche mobile en forme de Y. L’hélicase ouvre la double hélice et la primase dépose une courte amorce d’ARN. L’ADN polymérase ne peut ajouter des nucléotides qu’à une extrémité 3′ : le brin directeur s’allonge donc d’un seul tenant, tandis que le brin retardé est fabriqué en sens inverse sous forme de fragments d’Okazaki, puis l’ADN polymérase I et la ligase remplacent les amorces par de l’ADN et referment les interruptions. Une fourche humaine copie de 50 à 100 nucléotides par seconde, et une cellule humaine copie ses 6,4 milliards de paires de bases pendant une phase S d’environ 8 à 10 heures.
Une coupure à la main cicatrise parce que les cellules de la peau se divisent, et chaque nouvelle cellule a besoin de son propre jeu complet d’ADN. Dans une cellule humaine, cela implique de copier environ 6 milliards de paires de bases avant que la cellule se sépare en deux. La copie est réalisée par un groupe de protéines travaillant au niveau d’une jonction mobile en Y, la fourche de réplication. Elles doivent dérouler l’hélice, commencer chaque nouveau brin, le construire base par base, repérer leurs propres erreurs et réunir les morceaux laissés derrière elles.
Cette exposition représente une fourche à l’échelle moléculaire. Une portion de 84 paires de bases traverse la scène. Une hélicase l’ouvre, la primase dépose de courtes amorces d’ARN, deux ADN polymérases construisent les nouveaux brins, l’ADN polymérase I et l’ADN ligase achèvent le brin retardé, puis deux doubles hélices s’écartent à la fin. La vue initiale commence juste à côté de l’hélicase pendant qu’elle ouvre l’hélice. Faites glisser l’anneau jaune de l’hélicase pour tirer vous-même la fourche, appuyez sur Apparier la base suivante pour insérer des bases comme la polymérase et touchez une enzyme pour lire son rôle. Utilisez le curseur pour parcourir le processus, la commande Vitesse pour modifier l’allure et, avec elle, la longueur des fragments d’Okazaki, et l’interrupteur Relecture pour voir ce qui se passe lorsque la polymérase cesse de vérifier son travail. Les informations proviennent du manuel Biology d’OpenStax, de Nature Education, du National Human Genome Research Institute des États-Unis et de l’article original de Meselson et Stahl de 1958. Les sources sont indiquées à la fin.
La double hélice à l’échelle du modèle
L’ADN est constitué de deux brins enroulés l’un autour de l’autre. Chaque brin est une chaîne de sucres et de phosphates, et chaque sucre porte l’une de quatre bases : A, C, G ou T. Un A d’un brin s’apparie avec un T de l’autre, et C s’apparie avec G. Cette règle rend la copie possible : une fois les brins séparés, chacun porte toute l’information nécessaire pour reconstruire son partenaire. Dans le modèle, les bases sont colorées en vert pour A, rouge pour T, jaune pour G et bleu pour C. L’ARN utilise U à la place de T, et U est violet.
Deux paires de bases voisines sont séparées de 0,34 nm et l’hélice mesure 2 nm de large. Les manuels indiquent souvent que l’hélice effectue un tour toutes les 10 paires de bases, soit 3,4 nm. Cette valeur provient d’images de fibres d’ADN obtenues par rayons X. Mesuré en solution, comme dans une cellule, l’ADN est un peu moins étroitement enroulé : James Wang a trouvé 10,4 paires de bases par tour en 1979, et 10,5 est la valeur la plus couramment utilisée. Le modèle utilise 10,5, si bien qu’un tour mesure 10,5 × 0,34 = 3,57 nm. Les deux barres sous le modèle présentent les deux valeurs : un tour du modèle et, pour comparaison, les 3,4 nm du manuel. Le modèle entier mesure 84 × 0,34 = 28,6 nm de long.
Les deux brins sont orientés en sens opposés. Les chimistes numérotent les atomes de carbone de chaque sucre, et les extrémités d’un brin sont appelées 5′ et 3′ d’après ces numéros. Un brin orienté de 5′ vers 3′ de gauche à droite est apparié à un brin orienté de 5′ vers 3′ de droite à gauche. Ce détail, l’antiparallélisme des brins, détermine l’essentiel de ce qui se passe à la fourche.
Ce qui ouvre l’hélice et la maintient ouverte
L’enzyme qui assure l’ouverture de la molécule d’ADN est l’hélicase. Elle rompt les liaisons hydrogène entre les bases appariées et utilise pour cela l’énergie de l’ATP. À l’endroit précis où cette enzyme agit, la double hélice se sépare en deux brins simples, et la forme ainsi créée est la fourche de réplication. Dans le modèle, l’hélicase est un anneau jaune situé au point de séparation des brins, qui se déplace avec la progression de la fourche.
Séparer deux brins torsadés a un effet secondaire. L’ADN devant la fourche s’enroule plus étroitement, comme une corde torsadée qui forme des boucles lorsqu’on écarte ses torons à une extrémité. OpenStax décrit comment la topoisomérase empêche ce surenroulement en pratiquant des coupures temporaires dans l’hélice devant la fourche, puis en les refermant. Dans le modèle, cette enzyme est représentée par la masse de couleur rose sur l’ADN encore fermé, quelques tours devant l’hélicase.
Les brins simples ouverts s’apparieraient de nouveau s’ils restaient seuls. Des protéines de liaison à l’ADN simple brin les recouvrent et les maintiennent séparés jusqu’à l’arrivée d’une polymérase. Dans le modèle, ce sont les petites masses vertes. Observez où elles se regroupent : presque toutes se trouvent sur la matrice du bas, parce que ce brin attend le plus longtemps avant d’être copié. La raison de cette attente est expliquée dans la partie suivante.
Pourquoi une polymérase a besoin d’une amorce
L’ADN polymérase ajoute les nucléotides un par un, chacun étant apparié à la base qui lui fait face sur la matrice. L’énergie nécessaire à chaque nouvelle liaison provient du nucléotide entrant lui-même, qui arrive sous forme de triphosphate. Mais l’enzyme possède deux limites strictes. Elle ne peut ajouter qu’à l’extrémité 3′ d’un brin, et elle exige qu’un brin soit déjà présent. Elle ne peut pas commencer à construire un brin à partir de rien.
La primase résout le problème du démarrage. C’est une ARN polymérase, et les ARN polymérases peuvent commencer une nouvelle chaîne sans partenaire. La primase synthétise un court morceau d’ARN, long d’environ 5 à 10 nucléotides selon OpenStax, complémentaire de la matrice. Cette amorce fournit à l’ADN polymérase une extrémité 3′ libre à prolonger. Dans le modèle, les amorces comptent 5 nucléotides et sont représentées par des perles violettes. Une amorce tout à gauche démarre le nouveau brin du haut. Le nouveau brin du bas a besoin d’une nouvelle amorce, encore et encore.
Une seule direction et ses conséquences pour les deux brins
Puisque la polymérase ne peut ajouter qu’à une extrémité 3′, chaque nouveau brin s’allonge dans le sens 5′ vers 3′. Regardez maintenant les deux matrices. Sur la matrice du haut, la direction 5′ vers 3′ du nouveau brin pointe vers la fourche. La polymérase peut suivre l’hélicase et continuer à allonger le même brin à mesure que la matrice se découvre. Ce brin continu est le brin directeur, orange dans le modèle, et il est construit à partir d’une seule amorce.
Sur la matrice du bas, le nouveau brin doit aller dans l’autre sens, en s’éloignant de la fourche. À mesure que la fourche s’ouvre, la nouvelle matrice apparaît derrière la polymérase plutôt que devant elle. La seule façon de la copier est de commencer un nouveau morceau près de la fourche et de le construire en sens inverse jusqu’à ce qu’il rencontre le morceau précédent. Chacun de ces morceaux est un fragment d’Okazaki, et le brin qu’ils constituent est le brin retardé, turquoise dans le modèle, avec deux nuances alternant entre les fragments.
Désactivez Couleurs des paires de bases dans l’onglet Réglages pour le voir clairement. Les anciens brins deviennent gris et les deux types de nouveaux brins conservent leurs couleurs propres. Le brin directeur est une longue ligne orange continue. Le brin retardé est une rangée de courts morceaux turquoise portant des amorces violettes à leur extrémité droite.
Les fragments d’Okazaki sur le brin retardé
Le brin retardé est fabriqué en répétant un même cycle. La primase dépose une amorce près de la fourche. La polymérase du brin retardé, maintenue sur l’ADN par une pince coulissante, prolonge cette amorce en s’éloignant de la fourche jusqu’à rencontrer le fragment précédent. Cette polymérase se détache ensuite de l’ADN et passe à l’amorce suivante. Dans le modèle, vous pouvez voir la seconde polymérase et sa pince bleu foncé revenir vers la fourche après avoir terminé chaque morceau.
Les fragments réels sont beaucoup plus longs que les 14 nucléotides du modèle. Une synthèse de Balakrishnan et Bambara donne environ 1200 nucléotides pour les fragments d’Okazaki chez les bactéries et seulement environ 200 dans les cellules eucaryotes, où leur longueur suit l’espacement des nucléosomes. Le modèle les raccourcit pour que plusieurs tiennent simultanément à l’écran. La ligne Okazaki de l’affichage compte deux nombres : combien de fragments ont été commencés et combien ont été reliés à leur voisin.
Remplacer les amorces par de l’ADN et refermer les interruptions
Un fragment dont la fabrication est terminée porte encore de l’ARN à l’une de ses extrémités, alors qu’un nouveau brin d’ADN ne doit pas contenir d’ARN. Chez les bactéries, l’ADN polymérase I retire chaque amorce grâce à son activité exonucléase et remplit l’espace avec de l’ADN, en utilisant comme point de départ l’ADN du fragment situé derrière elle. Dans les cellules eucaryotes, le travail est réalisé autrement : la polymérase δ déplace l’amorce sous forme de flap (languette), et l’endonucléase à flap 1 (FEN1) la coupe. La RNase H peut aussi contribuer au retrait des amorces, mais la RNase H et FEN1 sont des enzymes différentes. Le modèle présente la version bactérienne, une enzyme bleu pâle qui transforme les perles violettes en perles turquoise.
Après ce remplacement, les deux morceaux d’ADN sont bout à bout, mais ne sont pas encore reliés. Il manque une liaison phosphodiester, une interruption appelée « nick » (coupure simple brin). L’ADN ligase forme cette liaison entre l’extrémité 3′ d’un morceau et l’extrémité 5′ du suivant. Dans le modèle, la ligase orange reste un instant sur l’interruption, un anneau clignote et la liaison du squelette apparaît. C’est alors que le compteur des fragments reliés augmente.
Comment la polymérase retire une base incorrecte
Les polymérases insèrent parfois une base incorrecte. Nature Education indique une fréquence d’environ 1 pour 100 000 nucléotides. Une base qui n’est pas la bonne s’insère mal dans l’hélice, et son extrémité 3′ est mal positionnée pour l’ajout suivant. La polymérase remarque ce défaut de positionnement, revient en arrière, coupe le nucléotide incorrect grâce à son activité exonucléase de 3′ vers 5′ et insère le bon. C’est la relecture, qu’OpenStax décrit comme une lecture par la polymérase de chaque base nouvellement ajoutée avant d’ajouter la suivante.
Le modèle comporte deux erreurs introduites sur le brin directeur, un T face à un G et un G face à un T. Ce sont deux appariements oscillants (wobble), le type de mésappariement décrit par Nature Education. Lorsque Relecture est activée, la polymérase s’arrête à chacun : la base incorrecte devient magenta, pivote vers l’extérieur, disparaît et est remplacée. Pendant cet arrêt de la polymérase, l’hélicase attend également, si bien que la fourche prend du retard. Désactivez Relecture et rejouez la même portion. La fourche atteint chaque point plus tôt et les compteurs Okazaki avancent davantage, mais les deux bases incorrectes restent dans le nouveau brin, entourées de magenta, et l’affichage indique combien ont été conservées.
Vérifier les nombres
L’allure par défaut du modèle est de 5 paires de bases par seconde. Une fourche de réplication humaine avance de 50 à 100 nucléotides par seconde selon OpenStax, et Nature Education donne environ 40. Le modèle fonctionne donc environ 10 à 20 fois plus lentement qu’une vraie fourche humaine. Une fourche bactérienne est beaucoup plus rapide : E. coli copie son chromosome de 4,6 millions de paires de bases en environ 42 minutes avec deux fourches, ce qui correspond à environ 1000 nucléotides par seconde à chaque fourche.
Une seule fourche humaine peut-elle copier un génome entier ? À 50 nucléotides par seconde, 6 milliards de paires de bases demanderaient 6 000 000 000 ÷ 50 = 120 millions de secondes, presque quatre ans. Les cellules l’évitent en démarrant de nombreuses fourches à la fois ; OpenStax indique que les humains peuvent avoir jusqu’à 100 000 origines de réplication. Le National Human Genome Research Institute estime à plusieurs heures la durée de copie pour une cellule humaine.
Les erreurs s’additionnent de la même façon. Copier 6 milliards de paires de bases implique de déposer environ 12 milliards de nouveaux nucléotides, un face à chaque base matrice. À raison de 1 erreur pour 100 000, cela représente environ 120 000 bases incorrectes par division avant toute vérification. La relecture en corrige environ 99 pour cent, ce qui en laisse approximativement 1200. La réparation des mésappariements après réplication réduit encore ce nombre. Dans le modèle, 2 erreurs introduites parmi 84 paires de bases sont énormément plus fréquentes que dans la réalité ; elles sont là pour que vous puissiez voir la correction s’effectuer.
Ce que le modèle laisse de côté
Le modèle montre une fourche. La réplication réelle commence à une origine et ouvre une bulle dont les deux fourches s’écartent, et les deux fourches d’E. coli parcourent son chromosome circulaire dans des directions opposées avant de se rencontrer, chacune copiant approximativement la moitié du cercle. Les fragments et les amorces du modèle sont raccourcis, et seules deux erreurs sont introduites, à des endroits fixes.
Les protéines sont des masses souples, pas des formes mesurées, et elles sont transparentes pour que vous puissiez suivre l’ADN. Leur disposition suit les schémas des manuels : topoisomérase devant la fourche, protéines de liaison à l’ADN simple brin sur la matrice nue, pince coulissante autour de chaque nouvelle double hélice à côté de sa polymérase. Les deux polymérases sont représentées par des masses séparées pour que chaque nouveau brin soit facile à suivre. L’amorce du brin directeur, tout à gauche, reste également en place, car la fourche qui la retirerait se trouve au-delà du bord gauche.
Les noms des protéines suivent ceux des bactéries (l’ADN polymérase III réalise la copie principale, l’ADN polymérase I remplace les amorces). Les cellules eucaryotes utilisent d’autres enzymes pour les mêmes étapes : pol ε sur le brin directeur, pol δ sur le brin retardé, PCNA comme pince coulissante et FEN1, avec la contribution de la RNase H, pour le traitement des amorces. Elles doivent aussi retirer puis remettre les histones au passage de la fourche, ce qui, selon OpenStax, pourrait expliquer en partie pourquoi les fourches eucaryotes sont plus lentes.
Plusieurs nombres sur la scène sont des valeurs du modèle. La longueur des fragments correspond à Vitesse multipliée par un intervalle d’amorçage de 2,8 secondes de temps d’écran, maintenue entre 7 et 36 nucléotides, si bien que 5 bp/s donnent 14 nt. Apparier une base à la main fait avancer la fourche d’une paire de bases et saute les deux erreurs programmées, si bien que seuls vos propres choix peuvent être incorrects. Les calculateurs sous la scène supposent des origines régulièrement espacées qui démarrent toutes ensemble et des fourches qui ne s’arrêtent jamais, et ils ajustent le renouvellement cellulaire d’un adulte de 70 kg proportionnellement au poids corporel.
Comment savons-nous que chaque nouvelle hélice conserve un ancien brin ?
Lorsque James Watson et Francis Crick ont publié la double hélice en 1953, ils ont noté que la règle d’appariement suggérait un mécanisme de copie. Trois hypothèses étaient envisagées sur la façon dont elle pourrait fonctionner. Dans la réplication semi-conservative, chaque nouvelle hélice conserve un ancien brin et acquiert un nouveau brin. Dans la réplication conservative, l’ancienne hélice reste entière et une hélice entièrement nouvelle est construite à côté. Dans la réplication dispersive, ancien et nouvel ADN sont mélangés par morceaux le long des deux brins.
Matthew Meselson et Franklin Stahl, au California Institute of Technology, les ont testées en 1958. Ils ont cultivé E. coli pendant de nombreuses générations dans un milieu dont le seul azote était l’isotope lourd azote-15, puis transféré les cellules dans de l’azote-14 ordinaire et prélevé des échantillons au fil des divisions. L’ADN centrifugé dans un gradient de chlorure de césium se place là où sa densité correspond à celle de la solution, si bien que l’ADN lourd et l’ADN léger forment des bandes séparées. Avant le transfert, il y avait une bande lourde. Après une génération, il y avait une seule bande à mi-chemin entre lourd et léger, ce qui excluait la réplication conservative. Après deux générations, il y avait deux bandes, l’une hybride et l’autre légère, ce qui excluait le modèle dispersif. Chaque nouvelle hélice avait conservé un ancien brin. Activez Meselson et Stahl dans l’onglet Réglages pour voir ces trois tubes dans l’affichage.
Les fragments du brin retardé ont été découverts par Reiji Okazaki et ses collègues, qui ont rapporté en 1968 que l’ADN nouvellement fabriqué apparaît d’abord sous forme de courts morceaux, ensuite réunis en longs brins. Les enzymes elles-mêmes avaient été étudiées en éprouvette auparavant. Arthur Kornberg et Severo Ochoa ont partagé le prix Nobel de physiologie ou médecine de 1959 « pour leur découverte des mécanismes de la synthèse biologique de l’acide ribonucléique et de l’acide désoxyribonucléique », selon les termes du comité Nobel.
Combien de fourches termineraient un génome humain en quelques heures ?
La vitesse d’une fourche est une distance parcourue le long d’une matrice par unité de temps, pas la production cumulée de toutes les polymérases d’une cellule. Avec une vitesse supposée constante de 1000 nt/s, deux fourches bactériennes couvrent 2000 paires de bases du chromosome parental par seconde. Un chromosome de 4 600 000 bp nécessite donc 4 600 000 ÷ 2000 = 2300 secondes, soit environ 38 minutes. Les quelque 42 minutes du manuel sont compatibles avec ces données arrondies ; le calcul ne prédit pas le temps entre deux divisions cellulaires bactériennes. Dans des conditions de croissance favorables, les bactéries peuvent commencer un nouveau cycle de réplication avant la fin du précédent.
Pour un exemple humain, utilisez un génome haploïde arrondi à 3 200 000 000 bp et supposez que 10 000 origines régulièrement espacées démarrent toutes ensemble. Chaque origine émet deux fourches à 50 nt/s, donnant 20 000 fourches et une vitesse totale de couverture de 1 000 000 bp/s. Diviser la longueur du génome par cette vitesse donne 3200 secondes, soit environ 53 minutes. Les origines sont distantes en moyenne de 320 000 bp, et chaque fourche parcourt la moitié de cette distance avant de rencontrer sa voisine. On obtient la même réponse avec 160 000 ÷ 50.
Ce calcul volontairement idéal donne une durée inférieure aux plusieurs heures nécessaires à une cellule humaine réelle. Les origines ne démarrent pas toutes ensemble ; les différentes régions des chromosomes se répliquent à des moments différents, et les fourches rencontrent la chromatine et d’autres obstacles. Si seulement 2000 origines étaient actives simultanément selon les mêmes hypothèses, le calcul donnerait 16 000 secondes, soit environ 4,4 heures. Ces nombres d’origines sont des exemples supposés, pas des mesures d’un tissu particulier. La comparaison explique pourquoi le seul décompte des origines potentielles ne peut déterminer la durée de la phase S.
La plupart des cellules du corps humain possèdent deux jeux de chromosomes. À la même échelle arrondie, cela représente 6 400 000 000 bp à dupliquer, plutôt que les 3 200 000 000 bp haploïdes. Doubler à la fois la quantité d’ADN et le nombre d’origines actives laisse inchangée la durée idéale d’achèvement. La valeur précédente de 6 milliards est une approximation diploïde plus grossière, pas une autre règle de décompte des paires de bases.
D’un nucléotide incorrect à une mutation durable
Une insertion incorrecte, un mésappariement échappant à la relecture et une mutation conservée après réparation sont des décomptes différents. La synthèse de Fijalkowska et ses collègues fournit un exemple bactérien utile : erreurs initiales d’insertion autour de 10⁻⁵, fraction échappant à la relecture autour de 10⁻², puis autour de 10⁻³ après réparation des mésappariements. Leur multiplication donne 10⁻¹⁰ erreurs par base copiée et par cycle. Ce sont des contributions approximatives, dépendantes du mésappariement et de la séquence, pas des constantes universelles pour toutes les polymérases.
Pour un exercice de calcul, conservons le génome diploïde précédent arrondi à 6 milliards de bp. Copier les deux brins parentaux incorpore environ 12 milliards de nouveaux nucléotides. À 10⁻⁵, cela donne 120 000 erreurs initiales ; à 10⁻⁷ après relecture, cela en donne 1200. Un taux final de 10⁻⁹ laisserait une valeur attendue de 12 erreurs dans l’ensemble des produits de réplication, tandis que 10⁻¹⁰ en donnerait 1,2. Une espérance fractionnaire décrit une moyenne sur de nombreuses divisions ; une cellule ne peut contenir une fraction de base modifiée. La relecture seule ne fournit pas toute la réduction de 10⁻⁵ à 10⁻⁹ ou 10⁻¹⁰.
Ne transformez pas ces totaux illustratifs en affirmation selon laquelle chaque division humaine crée exactement autant de mutations. Un mésappariement contient encore des instructions contradictoires sur ses deux brins. La réparation peut l’éliminer, ou un cycle ultérieur de copie peut établir la séquence modifiée chez un descendant. Les produits se répartissent aussi entre les cellules filles. Les dommages à l’ADN, le type cellulaire et la fidélité des différentes enzymes influencent les nombres de mutations observés. La paire fixe d’erreurs à l’écran teste la séquence de correction, pas une distribution des taux de mutation ; la rejouer n’échantillonne pas une autre cellule.
Combien de fragments faut-il achever ?
La longueur des fragments modifie la charge de travail sans modifier la quantité d’ADN à copier. Avec la longueur approximative des fragments bactériens de 1200 nt donnée par la synthèse, la contribution du brin retardé pour un chromosome circulaire de 4 600 000 bp est de l’ordre de 4 600 000 ÷ 1200, soit environ 3800 fragments. Pourquoi ne pas diviser deux fois la longueur du chromosome ? À chaque fourche, l’un des deux brins nouvellement fabriqués est retardé. En additionnant les deux fourches, la longueur synthétisée de manière discontinue correspond approximativement à une longueur de chromosome, pas à celle des deux nouveaux brins réunis.
Avec un génome humain diploïde arrondi à 6 400 000 000 bp et des fragments de 200 nt en moyenne, l’estimation correspondante est de 32 000 000 fragments. Les effets d’extrémité et les différences entre régions empêchent ces divisions de donner des comptes exacts. Elles montrent néanmoins pourquoi le retrait des amorces et la ligature ne peuvent être de rares finitions. Une cellule doit traiter des millions de jonctions pendant une seule phase S. Les fragments courts des eucaryotes sont associés à l’organisation des nucléosomes, plutôt qu’à une capacité des polymérases humaines limitée à 200 nucléotides avant de perdre toute activité.
L’exposition réduit chaque fragment à 14 nt et chaque amorce à 5 nt. L’amorce occupe ainsi une fraction du fragment beaucoup plus grande que dans les exemples biologiques. N’estimez pas la quantité d’ARN dans un chromosome à partir de la proportion de perles violettes à l’écran. Observez plutôt l’ordre des événements : l’amorce fournit le point de départ, l’ADN remplace l’amorce et la ligase referme l’interruption restante du squelette. La ligase ne lit pas une matrice et ne remplit pas à elle seule une longue portion d’ADN manquante.
Les extrémités des chromosomes et la PCR résolvent des problèmes différents
Le cycle ordinaire du brin retardé dépend d’un fragment voisin fournissant une extrémité 3′ prolongeable lorsqu’une amorce est retirée. Au bout d’un chromosome linéaire, cette disposition n’est plus possible. Les télomères sont de l’ADN répété associé à des protéines protectrices aux extrémités des chromosomes. Dans les cellules où la télomérase est active, cette enzyme utilise son propre ARN comme matrice pour prolonger une extrémité d’ADN ; d’autres éléments de la machinerie de réplication peuvent ensuite copier l’ADN complémentaire. La télomérase ne copie pas le génome entier et ne colle pas simplement les deux extrémités du chromosome ensemble. La fourche de cette exposition est une portion interne : sa séparation finale ne simule donc pas le raccourcissement des télomères.
La perte de télomères n’est pas non plus une horloge exacte donnant l’âge d’une personne par décompte des divisions. Le NHGRI décrit le raccourcissement et le réapprovisionnement en répétitions dans certains types de cellules en division. Ces processus varient d’une cellule à l’autre. Expliquer le problème de réplication des extrémités ne prouve pas qu’augmenter la télomérase serait un traitement anti-âge sans danger.
La PCR copie une région sélectionnée d’ADN à l’extérieur d’une cellule. Comme l’explique le NHGRI, le chauffage sépare les brins matrices, et une polymérase résistante à la chaleur synthétise du nouvel ADN pendant des cycles répétés de température. Dans une réaction PCR standard, les amorces d’ADN fournies choisissent les limites de la cible ; la primase ne fabrique pas continuellement des amorces d’ARN à une fourche mobile. Le chauffage remplace le rôle d’ouverture des brins de l’hélicase, mais pas toutes les fonctions de la machinerie cellulaire de réplication.
Selon l’hypothèse d’un doublement idéal, 20 cycles produisent 2²⁰ = 1 048 576 copies à partir d’une seule matrice initiale double brin. C’est une multiplication théorique, pas un rendement garanti au laboratoire : les réactifs deviennent limitants et l’amplification n’est pas parfaitement efficace. La PCR amplifie aussi la cible choisie au lieu de dupliquer automatiquement tous les chromosomes d’une cellule. La commande Vitesse de l’exposition ne représente pas un cycle de température PCR.
Tirez vous-même la fourche et appariez les bases
L’anneau de l’hélicase est la poignée de toute la machine. Faites-le glisser le long de l’hélice et la fourche s’ouvre exactement jusqu’où vous tirez : les brins parentaux se séparent, les protéines de liaison se déposent sur la matrice nue et les polymérases suivent. La commande Vitesse suit votre main, si bien qu’une traction rapide peut la régler à sa valeur maximale de 20 bp/s. Si vous tirez cet anneau dans l’autre sens, rien ne se passe. Une vraie hélicase se déplace le long d’un brin dans une seule direction grâce à l’énergie de l’ATP, et la direction opposée est couverte par une seconde fourche quittant la même origine.
Apparier la base suivante vous fait jouer le rôle de la polymérase du brin directeur. La fourche s’arrête, une perle blanche marque la prochaine place libre sur le nouveau brin et un anneau rouge marque la base matrice en face. Quatre boutons proposent A, T, G et C. Le bon choix suit la règle d’appariement, A avec T et G avec C, et le brin s’allonge d’une paire de bases. Un mauvais choix est conservé un instant, puis, si Relecture est activée, la polymérase recule d’une position, le coupe et insère la bonne base, tout comme l’exonucléase de 3′ vers 5′. Lorsque Relecture est désactivée, la base incorrecte reste entourée d’un anneau et la copie porte un mésappariement.
Une vraie polymérase ne choisit pas en lisant des lettres. Le nucléotide entrant doit épouser la forme d’une paire correcte dans le site actif, tandis qu’une paire incorrecte s’y insère mal et est ajoutée beaucoup plus lentement. Malgré cela, environ 1 ajout sur 100 000 est incorrect avant relecture : 20 bons choix consécutifs ne prouvent donc pas la fiabilité d’un système de copie. Le jeu d’appariement prend également le relais du déroulement automatique : pendant votre choix, l’horloge s’arrête et les erreurs programmées aux positions 24 et 54 sont sautées.
Touchez n’importe quelle protéine présente sur la scène, ou son étiquette, pour lire le rôle qu’elle remplit. Les fiches reprennent brièvement la liste des composants, pour vous permettre de découvrir la topoisomérase devant la fourche, la primase sur la matrice retardée, les deux polymérases avec leurs anneaux, l’ADN polymérase I et la ligase sans quitter la scène.
Pourquoi une fourche plus rapide laisse des fragments plus longs
La primase ne commence pas une amorce à des positions fixes de l’ADN. Chez E. coli, elle arrive depuis la solution, rencontre l’hélicase, synthétise une amorce puis repart, et Tougu et Marians ont montré en 1996 que cette rencontre se produit environ toutes les 1 à 2 secondes et fixe la longueur des fragments. Pendant ce temps, la fourche avance d’environ 1000 nucléotides par seconde. Un fragment toutes les 1 à 2 secondes à 1000 nucléotides par seconde donne des fragments de 1000 à 2000 nucléotides, ce qui correspond aux quelque 1200 mesurés chez les bactéries.
Le modèle conserve cette idée avec une horloge plus lente. Une nouvelle amorce commence toutes les 2,8 secondes de temps d’écran : la longueur des fragments est donc Vitesse multipliée par 2,8. À la valeur par défaut de 5 bp/s, cela donne 14 nt et 6 fragments sur les 84 paires de bases. À partir de 13 bp/s, les fragments mesurent 36 nt et seuls 2 tiennent ; à 3 bp/s, ils mesurent 8 nt et sont au nombre de 12. En dessous de 3 bp/s, le modèle conserve 7 nt comme longueur minimale pour qu’une amorce de 5 nt laisse encore de la place à l’ADN. Modifiez Vitesse pendant une séquence et tout le brin retardé est redessiné comme si la fourche avait toujours avancé à la nouvelle allure.
L’autre règle reste identique à toute vitesse : chaque fragment commence par de l’ARN et se termine contre le précédent, et chaque jonction nécessite l’ADN polymérase I et une ligase. Une fourche lente produisant de nombreux fragments courts laisse donc davantage d’amorces à retirer et d’interruptions à refermer. Chez les eucaryotes, les fragments sont plus courts, environ 200 nucléotides, parce qu’ils suivent l’espacement des nucléosomes. Une cellule humaine en achève des dizaines de millions pendant chaque phase S.
Combien de temps une cellule humaine met-elle à copier son ADN ?
Une cellule du corps humain contient environ 6,4 milliards de paires de bases, deux jeux de 3,2 milliards. Une fourche à 50 nucléotides par seconde nécessiterait 6 400 000 000 ÷ 50 = 128 millions de secondes, soit environ 4 ans. Une origine émettant deux fourches réduit cette durée de moitié, à environ 2 ans. Le calculateur sous la scène commence là, avec une seule origine, et vous permet d’augmenter le nombre d’origines démarrant ensemble jusqu’à 100 000, le maximum donné par OpenStax pour le génome humain.
À 50 nucléotides par seconde, 2223 origines (4446 fourches) suffisent pour terminer en 8 heures, et à 100 nucléotides par seconde il en faut moitié moins, 1112. Avec 10 000 origines, la durée idéale descend à 107 minutes à 50 nt/s. Le manuel de biologie cellulaire de Cooper donne environ 8 heures pour la phase S d’une cellule humaine qui se divise toutes les 24 heures, et OpenStax en donne environ 10. Les vraies cellules utilisent davantage d’origines que ne l’exige le calcul, parce que les origines démarrent à tour de rôle pendant la phase S et que les fourches s’arrêtent sur l’ADN endommagé ou étroitement compacté.
Les bactéries se contentent d’une origine parce que leur chromosome est court et leurs fourches rapides. Deux fourches à 1000 nucléotides par seconde copient les 4,6 millions de paires de bases d’E. coli en 4 600 000 ÷ 2000 = 2300 secondes, environ 38 minutes, proche des 42 du manuel. Les jeunes embryons de drosophile suivent l’approche inverse : un cycle cellulaire entier prend environ 8 minutes, si bien que l’ADN doit être copié depuis des origines très rapprochées.
Quelle quantité d’ADN votre corps copie-t-il par jour ?
Sender et Milo ont estimé en 2021 qu’un corps adulte remplace environ 330 milliards de cellules par jour, dont près de 90 pour cent de cellules sanguines, sur environ 30 billions de cellules humaines. Chaque nouvelle cellule porte une copie complète de l’ADN, si bien qu’au moins autant de copies du génome sont fabriquées chaque jour. Une copie comprend 6,4 milliards de paires de bases, et à 0,34 nm par paire de bases, cela représente environ 2,2 m d’ADN.
En multipliant pour un adulte de 70 kg, 330 milliards de copies de 2,2 m donnent environ 718 millions de km d’ADN par jour, soit 4,8 fois les 149,6 millions de km séparant la Terre du Soleil, ou environ 8300 km chaque seconde. Le calculateur sous la scène ajuste le nombre de cellules au poids que vous saisissez : à 60 kg, la copie quotidienne atteint environ 616 millions de km. Ces nombres ne sont que des valeurs approximatives fournies par le modèle. Le renouvellement varie entre individus et avec l’âge, les globules rouges perdent leur noyau en mûrissant, et certaines nouvelles cellules proviennent de cellules souches qui copient leur ADN ailleurs que là où la cellule sera finalement utilisée.
La valeur de ce total rappelle à quel point le processus de copie doit être fidèle. Au taux final d’erreur d’environ 1 sur un milliard, chaque copie du génome acquiert encore quelques changements, dont la plupart touchent de l’ADN sans modifier une protéine. La réparation, la mort cellulaire et le système immunitaire éliminent de nombreuses cellules qui fonctionnent mal.
De Watson et Crick à l’horloge de la fourche : une brève histoire
Watson et Crick ont terminé leur article de 1953 sur la double hélice en notant que l’appariement des bases suggérait un mécanisme de copie. En 1956, le groupe d’Arthur Kornberg a fabriqué de l’ADN en éprouvette avec une enzyme d’E. coli, l’ADN polymérase I, travaux récompensés par le prix Nobel de physiologie ou médecine partagé en 1959. En 1958, Meselson et Stahl ont montré avec de l’azote lourd que chaque nouvelle double hélice conserve un ancien brin. En 1963, John Cairns a photographié un chromosome entier d’E. coli en cours de copie : un seul cercle d’environ 1 mm de long, avec des fourches mobiles.
Les morceaux du brin retardé sont venus ensuite. En 1967, plusieurs laboratoires ont découvert l’ADN ligase, et Martin Gellert a montré que des extraits d’E. coli referment les extrémités de l’ADN lambda en anneaux. En 1968, Reiji Okazaki, Tsuneko Okazaki et leurs collègues ont marqué l’ADN nouveau pendant quelques secondes et l’ont trouvé sous forme de courts morceaux ensuite réunis. En 1969, Paula De Lucia et John Cairns ont découvert un mutant possédant très peu de polymérase I mais copiant toujours son ADN, ce qui indiquait une autre enzyme principale, la polymérase III.
Les travaux ultérieurs ont expliqué le reste de la machine sur la scène. Watson a décrit le problème des extrémités de l’ADN linéaire en 1972, le groupe de Gellert a découvert l’ADN gyrase en 1976, et Greider et Blackburn ont découvert la télomérase en 1985. En 1992, le groupe de Kuriyan a résolu la structure de la pince coulissante, un anneau autour de l’ADN. Kary Mullis a partagé le prix de chimie de 1993 pour la PCR, l’horloge des fragments d’Okazaki de Tougu et Marians a suivi en 1996, et en 2015 Lindahl, Modrich et Sancar ont partagé le prix de chimie pour la réparation de l’ADN. Le catalogue sous la scène comporte une fiche pour chacun, avec l’article original.
Vérifications à effectuer sur la scène
Commencez par faire une pause pendant la copie et désactivez Couleurs des paires de bases dans Réglages. Repérez le brin directeur orange continu, puis une amorce violette sur un fragment turquoise du brin retardé. Suivez les nouveaux brins de 5′ vers 3′ à l’aide des étiquettes de direction. Leurs sens de croissance doivent être chimiquement identiques, même si une polymérase se déplace vers la fourche tandis que l’autre travaille en s’en éloignant. « Retardé » ne signifie pas que ce brin est synthétisé de 3′ vers 5′.
Rejouez ensuite la même région avec Relecture activée puis désactivée, sans modifier Vitesse. Comparez le marqueur d’erreur magenta aux affichages Copié et Okazaki lorsque la polymérase s’arrête. Cela isole le délai de relecture programmé. Modifier Vitesse entre les séquences changerait aussi l’horloge de l’animation et ne constituerait pas une comparaison équitable. Une lecture plus rapide sans relecture ne prouve pas que les vraies cellules bénéficient d’une désactivation de la réparation.
Enfin, activez Meselson et Stahl et comparez les tubes des générations successives. Après une génération, la bande intermédiaire exclut le modèle conservatif, mais n’exclut pas à elle seule la copie dispersive. La deuxième génération fournit la distinction : des bandes hybride et légère séparées plutôt qu’une bande unique se déplaçant progressivement vers le léger. L’azote-15 est un isotope stable utilisé comme marqueur de densité, pas un traceur radioactif. Les tubes indiquent la densité de l’ADN, pas la couleur des bases nouvellement synthétisées. L’animation et l’expérience des tubes répondent à des questions différentes : l’une illustre les opérations de la fourche, tandis que l’autre teste la répartition du matériel parental entre les molécules filles.
Tirez ensuite l’hélicase rapidement puis lentement, en laissant chaque fois la fourche atteindre la fin, et comptez les fragments du brin retardé dans l’affichage Okazaki. Faites d’abord une prévision dans Prédire les fragments. Enfin, appariez les bases à la main avec Relecture activée puis désactivée et comparez l’affichage Relecture : les mauvais choix sont retirés dans le premier cas et comptés comme conservés dans le second.
Questions
Pourquoi l’ADN polymérase ne peut-elle pas construire les deux brins en continu ?
Elle ne peut ajouter des nucléotides qu’à une extrémité 3′, si bien que chaque nouveau brin s’allonge de 5′ vers 3′. Les deux matrices sont orientées en sens opposés : un seul nouveau brin peut donc croître vers la fourche qui s’ouvre. L’autre doit être fabriqué en morceaux qui s’en éloignent.
Quelle différence entre le brin directeur et le brin retardé ?
Le brin directeur est fabriqué d’un seul tenant à partir d’une seule amorce et suit l’hélicase. Le brin retardé est fabriqué en courts fragments d’Okazaki, chacun avec sa propre amorce, qui sont ensuite réunis par l’ADN ligase.
Pourquoi l’amorce est-elle constituée d’ARN ?
L’ADN polymérase ne peut pas commencer une nouvelle chaîne, mais la primase, une ARN polymérase, le peut. Le court ARN fournit à l’ADN polymérase une extrémité 3′ à prolonger. L’ARN est ensuite retiré et remplacé par de l’ADN.
À quelle fréquence l’ADN polymérase commet-elle une erreur ?
Nature Education donne environ 1 nucléotide incorrect sur 100 000 pendant la synthèse. La relecture en corrige environ 99 pour cent, et la réparation des mésappariements après réplication en repère d’autres.
À quelle vitesse l’ADN est-il copié ?
Environ 1000 nucléotides par seconde à chaque fourche chez E. coli, selon OpenStax. Dans les cellules humaines, OpenStax donne de 50 à 100 nucléotides par seconde et Nature Education environ 40. De nombreuses fourches travaillent simultanément.
Que signifie semi-conservatif ?
Chacune des deux nouvelles doubles hélices contient un brin provenant de la molécule originale et un brin nouvellement fabriqué. Meselson et Stahl l’ont montré en 1958 avec de l’azote lourd et léger.
Que se passe-t-il aux extrémités d’un chromosome ?
Sur un chromosome linéaire, la dernière amorce du brin retardé ne peut pas être remplacée par de l’ADN, si bien que les extrémités raccourciraient un peu à chaque division. La télomérase, une enzyme possédant sa propre matrice d’ARN, ajoute des répétitions de TTAGGG aux extrémités dans les cellules où elle est active.
Le brin retardé croît-il dans la direction chimique opposée ?
Non. Les deux nouveaux brins s’allongent de 5′ vers 3′. Le brin discontinu croît en s’éloignant de la fourche en fragments séparés ; son sens de synthèse n’est pas inversé.
La relecture seule explique-t-elle le taux final d’erreur ?
Non. La sélection des bases, la relecture et la réparation des mésappariements apportent des réductions distinctes. L’exemple bactérien approximatif de 10⁻⁵ à 10⁻¹⁰ les inclut toutes ; ce n’est pas un nombre universel de mutations des cellules humaines.
L’azote-15 est-il radioactif ?
Non. C’est un isotope stable de l’azote. Meselson et Stahl ont suivi les différences de densité de l’ADN plutôt que de détecter une désintégration radioactive.
La PCR est-elle identique à la fourche à l’écran ?
Toutes deux utilisent une matrice et une polymérase, mais la PCR standard utilise le chauffage pour séparer les brins et des amorces d’ADN fournies pour sélectionner une cible. Le modèle montre au contraire une fourche cellulaire entraînée par une hélicase, avec des amorces d’ARN et le traitement du brin retardé.
Pourquoi certains fragments d’Okazaki sont-ils plus longs que d’autres ?
Leur longueur dépend de la fréquence à laquelle la primase commence une nouvelle amorce comparée à la vitesse de progression de la fourche. Chez E. coli, la primase rencontre l’hélicase environ toutes les 1 à 2 secondes tandis que la fourche avance d’environ 1000 nucléotides par seconde, donnant des fragments de 1000 à 2000 nucléotides ; les fragments eucaryotes font environ 200. Sur la scène, une Vitesse plus élevée donne des fragments moins nombreux et plus longs.
Quelle quantité d’ADN mon corps copie-t-il chaque jour ?
Environ 330 milliards de cellules sont remplacées quotidiennement chez un adulte, et chaque nouvelle cellule a besoin d’une copie d’environ 6,4 milliards de paires de bases, soit environ 2,2 m d’ADN. Cela représente plusieurs centaines de millions de kilomètres par jour, quelques fois la distance entre la Terre et le Soleil. Le calculateur sous la scène l’évalue pour votre poids sous forme d’estimation approximative.
Vocabulaire
- Fourche de réplication : région en forme de Y où la double hélice est ouverte et copiée.
- Hélicase : enzyme séparant les deux brins en rompant les liaisons hydrogène entre les paires de bases.
- Topoisomérase : enzyme relâchant le surenroulement devant la fourche en coupant puis en refermant l’ADN.
- Protéine de liaison à l’ADN simple brin (SSB) : protéine recouvrant l’ADN simple brin et l’empêchant de reformer une hélice.
- Primase : ARN polymérase fabriquant les amorces.
- Amorce : court brin d’ARN fournissant à l’ADN polymérase une extrémité 3′ pour commencer.
- Brin directeur : nouveau brin fabriqué en continu vers la fourche.
- Brin retardé : nouveau brin fabriqué par morceaux en s’éloignant de la fourche.
- Fragment d’Okazaki : un des courts morceaux du brin retardé.
- Pince coulissante : protéine en anneau maintenant l’ADN polymérase sur l’ADN (PCNA chez les eucaryotes).
- ADN ligase : enzyme refermant une interruption en formant une liaison phosphodiester.
- Relecture : retrait d’un nucléotide ajouté à tort par l’exonucléase de 3′ vers 5′ de la polymérase.
- Réplication semi-conservative : copie dans laquelle chaque nouvelle hélice conserve un ancien brin.
Sources
OpenStax, Biology 2e, 14.2 DNA Structure and Sequencing (0,34 nm par paire de bases, largeur de 2 nm, 3,4 nm et 10 paires de bases par tour). https://openstax.org/books/biology-2e/pages/14-2-dna-structure-and-sequencing (vérifié le 16 octobre 2026)
OpenStax, Biology 2e, 14.3 Basics of DNA Replication (Meselson et Stahl, réplication semi-conservative). https://openstax.org/books/biology-2e/pages/14-3-basics-of-dna-replication (vérifié le 16 octobre 2026)
OpenStax, Biology 2e, 14.4 DNA Replication in Prokaryotes (hélicase, SSB, topoisomérase, amorces de 5 à 10 nucléotides, pince coulissante, ADN pol I et ligase, 4,6 millions de paires de bases d’E. coli en environ 42 minutes, 1000 nucléotides par seconde). https://openstax.org/books/biology-2e/pages/14-4-dna-replication-in-prokaryotes (vérifié le 16 octobre 2026)
OpenStax, Biology 2e, 14.5 DNA Replication in Eukaryotes (6 milliards de paires de bases, jusqu’à 100 000 origines, 50 à 100 nucléotides par seconde, pol ε et pol δ, PCNA, RNase H, télomérase). https://openstax.org/books/biology-2e/pages/14-5-dna-replication-in-eukaryotes (vérifié le 16 octobre 2026)
OpenStax, Biology 2e, 14.6 DNA Repair (relecture par l’exonucléase 3′, réparation des mésappariements). https://openstax.org/books/biology-2e/pages/14-6-dna-repair (vérifié le 16 octobre 2026)
Nature Education, Scitable: Major Molecular Events of DNA Replication (environ 40 nucléotides par seconde chez les eucaryotes, Okazaki et al. 1968). https://www.nature.com/scitable/topicpage/major-molecular-events-of-dna-replication-413/ (vérifié le 16 octobre 2026)
Balakrishnan, L. et Bambara, R. A., Okazaki fragment metabolism, Cold Spring Harbor Perspectives in Biology 5, a010173 (2013) (fragments d’Okazaki d’environ 1200 nucléotides chez les bactéries et environ 200 chez les eucaryotes). https://pmc.ncbi.nlm.nih.gov/articles/PMC3552508/ (vérifié le 16 octobre 2026)
Nature Education, Scitable: DNA Replication and Causes of Mutation (environ 1 erreur pour 100 000 nucléotides, relecture corrigeant environ 99 pour cent, appariements oscillants (wobble)). https://www.nature.com/scitable/topicpage/dna-replication-and-causes-of-mutation-409/ (vérifié le 16 octobre 2026)
Nature Education, Scitable: Semi-Conservative DNA Replication: Meselson and Stahl (les trois modèles et l’expérience de 1958). https://www.nature.com/scitable/topicpage/semi-conservative-dna-replication-meselson-and-stahl-421/ (vérifié le 16 octobre 2026)
Meselson, M. et Stahl, F. W., The replication of DNA in Escherichia coli, Proceedings of the National Academy of Sciences 44, 671 à 682 (1958). https://pmc.ncbi.nlm.nih.gov/articles/PMC528642/ (vérifié le 16 octobre 2026)
Wang, J. C., Helical repeat of DNA in solution, Proceedings of the National Academy of Sciences 76, 200 à 203 (1979) (10,4 ± 0,1 paire de bases par tour). https://pmc.ncbi.nlm.nih.gov/articles/PMC382905/ (vérifié le 16 octobre 2026)
National Human Genome Research Institute, Talking Glossary: DNA Replication (plusieurs heures de copie pour une cellule humaine). https://www.genome.gov/genetics-glossary/DNA-Replication (vérifié le 16 octobre 2026)
NobelPrize.org, The Nobel Prize in Physiology or Medicine 1959 (Severo Ochoa et Arthur Kornberg). https://www.nobelprize.org/prizes/medicine/1959/summary/ (vérifié le 16 octobre 2026)
Fijalkowska, I. J., Schaaper, R. M. et Jonczyk, P., DNA replication fidelity in Escherichia coli: a multi-DNA polymerase affair, FEMS Microbiology Reviews 36, 1105 à 1121 (2012) (contributions successives de l’insertion, de la relecture et de la réparation des mésappariements). https://pmc.ncbi.nlm.nih.gov/articles/PMC3391330/ (vérifié le 22 octobre 2026)
National Human Genome Research Institute, Telomere (extrémités protectrices des chromosomes, raccourcissement et télomérase dans certaines cellules). https://www.genome.gov/genetics-glossary/Telomere (vérifié le 22 octobre 2026)
National Human Genome Research Institute, Polymerase Chain Reaction Fact Sheet (séparation par chauffage, polymérase Taq et cycles répétés de copie). https://www.genome.gov/about-genomics/fact-sheets/Polymerase-Chain-Reaction-Fact-Sheet (vérifié le 22 octobre 2026)
Tougu, K. et Marians, K. J., The interaction between helicase and primase sets the replication fork clock, Journal of Biological Chemistry 271, 21398 à 21405 (1996) (un fragment d’Okazaki toutes les 1 à 2 secondes chez E. coli). https://doi.org/10.1074/jbc.271.35.21398 (vérifié le 27 octobre 2026)
Sender, R. et Milo, R., The distribution of cellular turnover in the human body, Nature Medicine 27, 45 à 48 (2021) (environ 330 milliards de cellules remplacées par jour, près de 90 pour cent de cellules sanguines). https://doi.org/10.1038/s41591-020-01182-9 (vérifié le 27 octobre 2026)
Sender, R., Fuchs, S. et Milo, R., Revised estimates for the number of human and bacteria cells in the body, PLoS Biology 14, e1002533 (2016) (environ 30 billions de cellules humaines chez un homme de référence de 70 kg). https://doi.org/10.1371/journal.pbio.1002533 (vérifié le 27 octobre 2026)
Cooper, G. M., The Cell: A Molecular Approach, 2e édition, The Eukaryotic Cell Cycle (phase S d’environ 8 heures dans un cycle cellulaire humain de 24 heures). https://www.ncbi.nlm.nih.gov/books/NBK9876/ (vérifié le 27 octobre 2026)
OpenStax, Biology 2e, 10.3 Control of the Cell Cycle (phase S d’environ 10 heures dans les cellules humaines se divisant rapidement, cycle cellulaire de l’embryon de drosophile d’environ 8 minutes). https://openstax.org/books/biology-2e/pages/10-3-control-of-the-cell-cycle (vérifié le 27 octobre 2026)
Watson, J. D. et Crick, F. H. C., Molecular structure of nucleic acids, Nature 171, 737 à 738 (1953). https://www.nature.com/articles/171737a0 (vérifié le 27 octobre 2026)
Cairns, J., The bacterial chromosome and its manner of replication as seen by autoradiography, Journal of Molecular Biology 6, 208 à 213 (1963). https://doi.org/10.1016/S0022-2836(63)80070-4 (vérifié le 27 octobre 2026)
Gellert, M., Formation of covalent circles of lambda DNA by E. coli extracts, Proceedings of the National Academy of Sciences 57, 148 à 155 (1967). https://doi.org/10.1073/pnas.57.1.148 (vérifié le 27 octobre 2026)
Okazaki, R. et collègues, Mechanism of DNA chain growth, I, Proceedings of the National Academy of Sciences 59, 598 à 605 (1968). https://doi.org/10.1073/pnas.59.2.598 (vérifié le 27 octobre 2026)
De Lucia, P. et Cairns, J., Isolation of an E. coli strain with a mutation affecting DNA polymerase, Nature 224, 1164 à 1166 (1969). https://doi.org/10.1038/2241164a0 (vérifié le 27 octobre 2026)
Watson, J. D., Origin of concatemeric T7 DNA, Nature New Biology 239, 197 à 201 (1972). https://doi.org/10.1038/newbio239197a0 (vérifié le 27 octobre 2026)
Gellert, M., Mizuuchi, K., O'Dea, M. H. et Nash, H. A., DNA gyrase: an enzyme that introduces superhelical turns into DNA, Proceedings of the National Academy of Sciences 73, 3872 à 3876 (1976). https://doi.org/10.1073/pnas.73.11.3872 (vérifié le 27 octobre 2026)
Greider, C. W. et Blackburn, E. H., Identification of a specific telomere terminal transferase activity in Tetrahymena extracts, Cell 43, 405 à 413 (1985). https://doi.org/10.1016/0092-8674(85)90170-9 (vérifié le 27 octobre 2026)
Kong, X.-P., Onrust, R., O'Donnell, M. et Kuriyan, J., Three-dimensional structure of the beta subunit of E. coli DNA polymerase III holoenzyme: a sliding DNA clamp, Cell 69, 425 à 437 (1992). https://doi.org/10.1016/0092-8674(92)90445-I (vérifié le 27 octobre 2026)
NobelPrize.org, The Nobel Prize in Chemistry 1993 (Kary B. Mullis, PCR) et 2015 (Lindahl, Modrich et Sancar, réparation de l’ADN). https://www.nobelprize.org/prizes/chemistry/2015/summary/ (vérifié le 27 octobre 2026)
Textes et simulations : CC BY-NC-SA 4.0, sauf mention contraire.
D'autres expositions

CRISPR-Cas9 interactif : coupe et réparation de l’ADN
Un ARN guide ne lit que 20 lettres d’ADN, et cela suffit en général pour repérer un seul endroit parmi les 3 milliards de paires de bases d’un génome humain.

ATP synthase : explorez le fonctionnement de son rotor
Dans les mitochondries, le rotor de l’ATP synthase tourne environ 100 fois par seconde. Chaque tour libère trois molécules d’ATP.
Promenade dans une cellule : animale, végétale et bactérie
Agrandie un million de fois, une mitochondrie a à peu près la taille d’un canapé, une bactérie E. coli entière mesure 2 m et la kinésine qui remorque une vésicule à côté de vous marche à 0,8 mètre par seconde.
Propagation de l’influx nerveux : testez un neurone
Une cellule nerveuse reste vers −70 mV. Si un stimulus la porte vers −55 mV, elle produit une décharge toujours de même amplitude.

Séquoia géant : croissance et taille des arbres géants
Au pied du General Sherman Tree, haut de 83,8 m et âgé d’environ 2200 ans, grimpez au tronc et observez la traction sur l’eau en hauteur.

Taille des dinosaures comparée à l’humain : 172 animaux
Un parc de 600 m avec 172 animaux préhistoriques à leur taille réelle, des premiers dinosaures à T. rex, rangés par période.