FIG. 59Como funciona
Replicação do DNA passo a passo: fragmentos de Okazaki em 3D
Uma DNA polimerase só pode acrescentar a uma extremidade da fita, por isso, em cada forquilha de replicação, uma nova fita cresce numa peça única e a outra em fragmentos curtos.
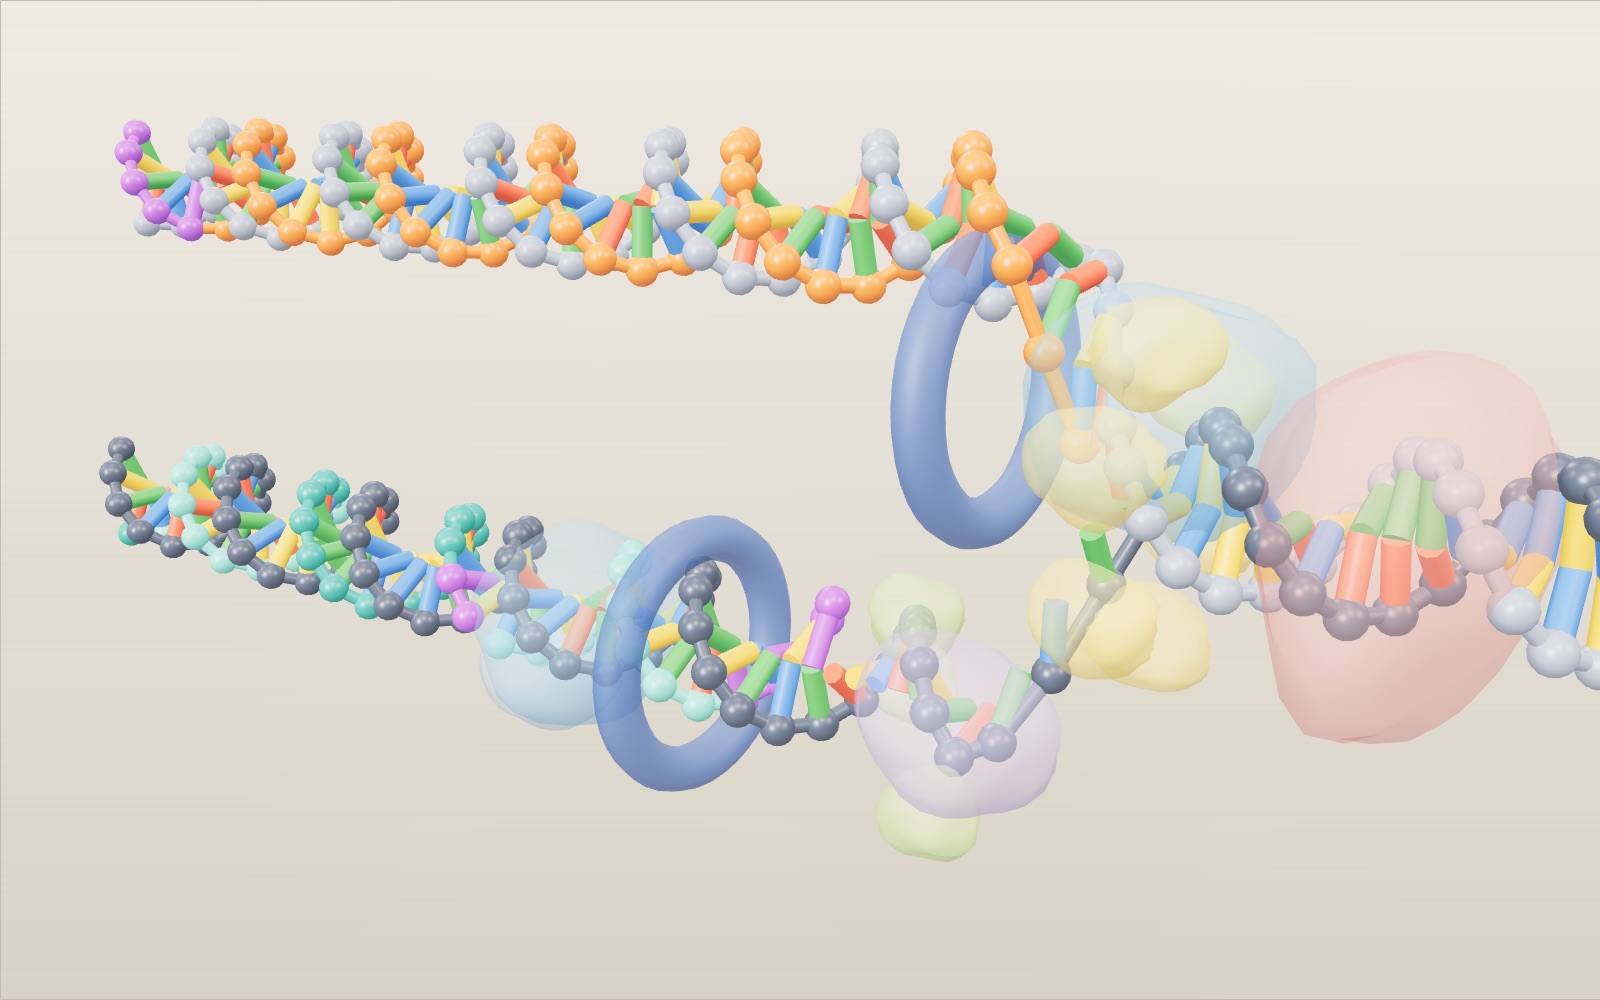
Este dispositivo não consegue mostrar o modelo 3D. Abaixo, você pode ler as etapas do guia em texto.
1 / 11 84 pares de bases de DNA, em escalaEste trecho tem cerca de 29 nm de comprimento. As barras abaixo fornecem a escala: uma volta corresponde a 10,5 pares de bases (3,57 nm) em solução, enquanto os livros arredondam para 10 pares de bases e 3,4 nm. A sequência foi inventada para o modelo.
Arraste para girar. Use a rolagem ou o gesto de pinça para ampliar.
Como uma célula copia seu DNA antes de se dividir?
A replicação do DNA ocorre em algumas etapas numa forquilha móvel em forma de Y. A helicase abre a dupla hélice e a primase produz um curto primer de RNA. A DNA polimerase só pode acrescentar nucleotídeos a uma extremidade 3′, por isso a fita contínua cresce numa peça única, enquanto a fita descontínua é produzida para trás em fragmentos de Okazaki, e a DNA polimerase I e a ligase depois substituem os primers por DNA e fecham as lacunas. Uma forquilha humana copia de 50 a 100 nucleotídeos por segundo, e uma célula humana copia seus 6,4 bilhões de pares de bases numa fase S de cerca de 8 a 10 horas.
Um corte na sua mão cicatriza porque as células da pele se dividem, e cada nova célula precisa de seu próprio conjunto completo de DNA. Numa célula humana, isso significa copiar cerca de 6 bilhões de pares de bases antes que a célula se divida em duas. A cópia é feita por um grupo de proteínas que trabalham numa junção móvel em forma de Y, a forquilha de replicação. Elas precisam desenrolar a hélice, iniciar cada nova fita, construí-la base por base, detectar seus próprios erros e unir os pedaços que deixam para trás.
Esta exposição constrói uma forquilha em escala molecular. Um trecho de 84 pares de bases atravessa a cena. Uma helicase o abre, a primase produz primers curtos de RNA, duas DNA polimerases constroem as novas fitas, a DNA polimerase I e a DNA ligase finalizam a fita descontínua, e no final duas duplas hélices se afastam. A vista inicial começa bem ao lado da helicase enquanto ela abre a hélice. Arraste o anel amarelo da helicase para puxar a forquilha você mesmo, pressione Parear a próxima base para inserir bases como a polimerase faz e toque em qualquer enzima para ler sua função. Use o controle deslizante para percorrer o processo, o controle Velocidade para mudar o ritmo e, com ele, o comprimento dos fragmentos de Okazaki, e o interruptor Revisão para ver o que acontece quando a polimerase para de conferir seu trabalho. Os fatos vêm do livro Biology da OpenStax, da Nature Education, do National Human Genome Research Institute dos Estados Unidos e do artigo original de 1958 de Meselson e Stahl. As fontes estão listadas no final.
A dupla hélice na escala do modelo
O DNA consiste em duas fitas enroladas uma na outra. Cada fita é uma cadeia de açúcares e fosfatos, e cada açúcar carrega uma de quatro bases: A, C, G ou T. A numa fita se pareia com T na outra, e C se pareia com G. Essa regra torna a cópia possível: quando as fitas estão separadas, cada uma carrega toda a informação necessária para reconstruir sua parceira. No modelo, as bases têm as cores verde para A, vermelho para T, amarelo para G e azul para C. O RNA usa U no lugar de T, e U é roxo.
Pares de bases vizinhos ficam separados por 0,34 nm e a hélice tem 2 nm de largura. Os livros frequentemente dizem que a hélice completa uma volta a cada 10 pares de bases, ou 3,4 nm. Esse valor vem de imagens de fibras de DNA obtidas por raios X. Medido em solução, como está numa célula, o DNA se enrola um pouco menos apertado: James Wang encontrou 10,4 pares de bases por volta em 1979, e 10,5 é o valor mais usado. O modelo usa 10,5, portanto uma volta mede 10,5 × 0,34 = 3,57 nm. As duas barras sob o modelo mostram ambos: uma volta do modelo e os 3,4 nm dos livros para comparação. O modelo inteiro tem 84 × 0,34 = 28,6 nm de comprimento.
As duas fitas seguem em sentidos opostos. Os químicos numeram os átomos de carbono de cada açúcar, e as extremidades de uma fita recebem os nomes 5′ e 3′ com base neles. Uma fita que segue de 5′ para 3′ da esquerda para a direita se pareia com outra que segue de 5′ para 3′ da direita para a esquerda. Esse detalhe, as fitas antiparalelas, determina a maior parte do que acontece na forquilha.
O que abre a hélice e a mantém aberta
A enzima que abre o DNA é a helicase. Ela rompe as ligações de hidrogênio entre as bases pareadas e usa energia do ATP para fazer isso. Onde ela atua, a dupla hélice se separa em duas fitas simples, e a forma que surge é a forquilha de replicação. No modelo, a helicase é um anel amarelo no ponto onde as fitas se separam, e se desloca conforme a forquilha avança.
Separar duas fitas entrelaçadas tem um efeito colateral. O DNA à frente da forquilha fica mais enrolado, como uma corda torcida que se enrosca quando você separa seus fios numa extremidade. A OpenStax descreve como a topoisomerase impede esse enrolamento excessivo ao fazer cortes temporários na hélice à frente da forquilha e depois fechá-los. No modelo, ela é a forma rosa sobre o DNA ainda fechado, algumas voltas à frente da helicase.
As fitas simples abertas voltariam a se parear se fossem deixadas sozinhas. As proteínas de ligação à fita simples as revestem e as mantêm separadas até a chegada de uma polimerase. No modelo, elas são as pequenas formas verdes. Observe onde se acumulam: quase todas ficam no molde inferior, porque essa fita espera mais tempo antes de ser copiada. O motivo é a próxima parte da história.
Por que uma polimerase precisa de um primer
A DNA polimerase acrescenta nucleotídeos um por vez, cada um pareado à base oposta no molde. A energia para cada nova ligação vem do próprio nucleotídeo que chega, na forma de um trifosfato. Mas a enzima tem duas limitações rígidas. Ela só pode acrescentar à extremidade 3′ de uma fita e precisa que uma fita já esteja presente. Ela não consegue começar do nada.
A primase resolve o problema do início. Ela é uma RNA polimerase, e as RNA polimerases conseguem iniciar uma nova cadeia sem uma parceira. A primase produz um curto trecho de RNA, de cerca de 5 a 10 nucleotídeos segundo a OpenStax, complementar ao molde. Esse primer fornece à DNA polimerase uma extremidade 3′ livre para alongar. No modelo, os primers têm 5 nucleotídeos de comprimento e aparecem como esferas roxas. Um primer na ponta esquerda inicia a nova fita superior. A nova fita inferior precisa de um novo primer repetidas vezes.
Um único sentido e suas consequências para as duas fitas
Como a polimerase só pode acrescentar a uma extremidade 3′, toda nova fita cresce no sentido de 5′ para 3′. Agora observe os dois moldes de DNA no modelo. No molde superior, o sentido de 5′ para 3′ da nova fita aponta para a forquilha. A polimerase pode acompanhar a helicase e continuar acrescentando à mesma fita conforme mais molde fica exposto. Essa fita produzida continuamente é a fita contínua, laranja no modelo, e é construída a partir de um único primer.
No molde inferior, a nova fita precisa seguir no sentido contrário, afastando-se da forquilha. Conforme a forquilha abre, novo molde aparece atrás da polimerase, em vez de à sua frente. A única maneira de copiá-lo é iniciar um novo pedaço perto da forquilha e construí-lo para trás até encontrar o pedaço produzido antes. Cada um desses pedaços é um fragmento de Okazaki, e a fita construída com eles é a fita descontínua, verde-azulada no modelo, com fragmentos alternados em dois tons.
Desative Cores dos pares de bases na aba Controles para ver isso claramente. As fitas antigas ficam cinza e os dois tipos de fita nova mantêm suas próprias cores. A fita contínua é uma longa linha laranja. A fita descontínua é uma fileira de pequenos pedaços verde-azulados com primers roxos em suas extremidades direitas.
Fragmentos de Okazaki na fita descontínua
A fita descontínua repete um ciclo. A primase produz um primer perto da forquilha. A polimerase da fita descontínua, mantida no DNA por uma abraçadeira deslizante em forma de anel, estende esse primer para longe da forquilha até encontrar o fragmento anterior. Depois se solta e passa para o próximo primer. No modelo, você pode observar a segunda polimerase e sua abraçadeira azul-escura voltarem em direção à forquilha após concluir cada pedaço.
Os fragmentos reais são muito mais longos que os 14 nucleotídeos do modelo. Uma revisão de Balakrishnan e Bambara apresenta cerca de 1200 nucleotídeos para fragmentos de Okazaki em bactérias e apenas cerca de 200 em células eucarióticas, onde o comprimento acompanha o espaçamento dos nucleossomos. O modelo os encurta para que vários caibam na tela ao mesmo tempo. A linha Okazaki do painel mostra dois números: quantos fragmentos foram iniciados e quantos foram unidos ao vizinho.
Substituir primers por DNA e fechar os entalhes
Um fragmento concluído ainda tem RNA numa extremidade, e uma nova fita de DNA não deve conter RNA. Em bactérias, a DNA polimerase I remove cada primer com sua atividade exonuclease e preenche a lacuna com DNA, usando o DNA do fragmento atrás dela como ponto de partida. Nas células eucarióticas, o trabalho é diferente: a polimerase δ desloca o primer formando uma aba, e a endonuclease de aba 1 (FEN1) a corta. A RNase H também pode contribuir para a remoção dos primers, mas RNase H e FEN1 são enzimas diferentes. O modelo mostra a versão bacteriana, uma enzima azul-clara que transforma as esferas roxas em verde-azuladas.
Após a troca, os dois pedaços de DNA ficam ponta a ponta, mas ainda não estão unidos. Falta uma ligação fosfodiéster, uma interrupção chamada entalhe (nick). A DNA ligase forma essa ligação entre a extremidade 3′ de um pedaço e a extremidade 5′ do seguinte. No modelo, a ligase laranja fica sobre o entalhe por um instante, um anel pisca e a ligação do esqueleto aparece. É nesse momento que a contagem de unidos aumenta.
Como a polimerase retira uma base errada
As polimerases às vezes inserem a base errada. A Nature Education informa uma taxa de cerca de 1 em cada 100.000 nucleotídeos. Uma base errada se encaixa mal na hélice, e sua extremidade 3′ fica na posição errada para a próxima adição. A polimerase percebe, recua, corta o nucleotídeo errado com sua atividade exonuclease de 3′ para 5′ e insere o correto. Isso é revisão, e a OpenStax a descreve como a polimerase lendo cada base recém-adicionada antes de acrescentar a próxima.
O modelo tem dois erros inseridos na fita contínua, um T diante de um G e um G diante de um T. Ambos são pares de balanço (wobble), o tipo de pareamento incorreto descrito pela Nature Education. Com Revisão ativada, a polimerase para em cada um: a base errada fica magenta, gira para fora, desaparece e é substituída. Enquanto ela está parada, a helicase também espera, por isso a forquilha se atrasa. Desative Revisão e reproduza o mesmo trecho. A forquilha chega antes a cada ponto e as contagens de Okazaki avançam, mas as duas bases erradas ficam na nova fita, cercadas de magenta, e o painel informa quantas foram mantidas.
Conferindo os números
O ritmo padrão do modelo é de 5 pares de bases por segundo. Uma forquilha de replicação humana avança de 50 a 100 nucleotídeos por segundo, de acordo com a OpenStax, e a Nature Education informa cerca de 40. Portanto, o modelo funciona cerca de 10 a 20 vezes mais devagar que uma forquilha humana real. Uma forquilha bacteriana é muito mais rápida: E. coli copia seu cromossomo de 4,6 milhões de pares de bases em cerca de 42 minutos com duas forquilhas, o que corresponde a aproximadamente 1000 nucleotídeos por segundo em cada forquilha.
Uma única forquilha humana consegue copiar um genoma inteiro? A 50 nucleotídeos por segundo, 6 bilhões de pares de bases levariam 6.000.000.000 ÷ 50 = 120 milhões de segundos, quase quatro anos. As células evitam isso iniciando muitas forquilhas ao mesmo tempo; a OpenStax afirma que humanos podem ter até 100.000 origens de replicação. O National Human Genome Research Institute estima em várias horas o tempo de cópia para uma célula humana.
Os erros se acumulam da mesma maneira. Copiar 6 bilhões de pares de bases significa acrescentar cerca de 12 bilhões de novos nucleotídeos, um diante de cada base do molde. Com 1 erro em 100.000, são cerca de 120.000 bases erradas por divisão antes de qualquer conferência. A revisão corrige cerca de 99 por cento delas, deixando aproximadamente 1200. O reparo de pareamentos incorretos após a replicação reduz ainda mais esse número. No modelo, 2 erros inseridos entre 84 pares de bases é muito mais que na vida real; eles estão ali para que você veja a correção acontecer.
O que o modelo deixa de fora
O modelo mostra uma forquilha. A replicação real começa numa origem e abre uma bolha com duas forquilhas que se afastam, e as duas forquilhas de E. coli viajam em sentidos opostos ao redor de seu cromossomo circular e se encontram, cada uma copiando aproximadamente metade do círculo. Os fragmentos e primers do modelo são encurtados, e apenas dois erros são inseridos, em posições fixas.
As proteínas são formas arredondadas, não formas medidas, e são transparentes para que você acompanhe o DNA. Sua disposição segue os diagramas dos livros: topoisomerase à frente da forquilha, proteínas de ligação à fita simples no molde exposto, um anel de abraçadeira ao redor de cada nova dupla hélice junto de sua polimerase. As duas polimerases aparecem como formas separadas para facilitar o acompanhamento de cada nova fita. O primer da fita contínua na ponta esquerda também permanece no lugar, porque a forquilha que o removeria está além da borda esquerda.
Os nomes das proteínas seguem as bactérias (a DNA polimerase III faz a cópia principal, a DNA polimerase I substitui os primers). As células eucarióticas usam enzimas diferentes nas mesmas etapas: pol ε na fita contínua, pol δ na fita descontínua, PCNA como abraçadeira e FEN1 com contribuições da RNase H no processamento dos primers. Elas também precisam remover e recolocar histonas conforme a forquilha passa, o que a OpenStax sugere ser parte do motivo pelo qual as forquilhas eucarióticas são mais lentas.
Vários números na cena são valores do modelo. O comprimento do fragmento é a Velocidade multiplicada por um intervalo de iniciação de 2,8 segundos de tempo de tela, mantido entre 7 e 36 nucleotídeos, portanto 5 bp/s resultam em 14 nt. Parear uma base manualmente move a forquilha um par de bases e pula os dois erros programados, de modo que apenas suas próprias escolhas ficam erradas. As calculadoras abaixo da cena pressupõem origens igualmente espaçadas que são ativadas simultaneamente e forquilhas que nunca param, e ajustam a renovação celular de um adulto de 70 kg em proporção ao peso corporal.
Como sabemos que cada nova hélice conserva uma fita antiga
Quando James Watson e Francis Crick publicaram a dupla hélice em 1953, observaram que a regra de pareamento sugeria um mecanismo de cópia. Havia três ideias distintas sobre como esse mecanismo funcionaria. Na replicação semiconservativa, cada nova hélice conserva uma fita antiga e ganha uma nova. Na replicação conservativa, a hélice antiga permanece inteira e uma completamente nova é construída ao lado dela. Na replicação dispersiva, DNA antigo e novo se misturam em pedaços ao longo das duas fitas.
Matthew Meselson e Franklin Stahl, no California Institute of Technology, testaram essas ideias em 1958. Cultivaram E. coli por muitas gerações num meio cujo único nitrogênio era o isótopo pesado nitrogênio-15, depois transferiram as células para nitrogênio-14 comum e coletaram amostras conforme elas se dividiam. O DNA centrifugado num gradiente de cloreto de césio se deposita onde sua densidade corresponde à da solução, portanto DNA pesado e leve formam bandas separadas. Antes da troca havia uma banda pesada. Após uma geração havia uma única banda a meio caminho entre pesada e leve, o que descartava a replicação conservativa. Após duas gerações havia duas bandas, uma híbrida e uma leve, o que descartava o modelo dispersivo. Cada nova hélice havia conservado uma fita antiga. Ative Meselson e Stahl na aba Controles para ver esses três tubos no painel.
Os fragmentos da fita descontínua foram descobertos por Reiji Okazaki e seus colegas, que relataram em 1968 que o DNA recém-produzido aparece primeiro como pedaços curtos que depois se unem em fitas longas. As próprias enzimas foram estudadas antes em tubos de ensaio. Arthur Kornberg e Severo Ochoa dividiram o Prêmio Nobel de Fisiologia ou Medicina de 1959 "por sua descoberta dos mecanismos da síntese biológica do ácido ribonucleico e do ácido desoxirribonucleico", nas palavras do comitê do Nobel.
Quantas forquilhas terminariam um genoma humano em horas?
A velocidade de uma forquilha é uma distância ao longo de um molde por unidade de tempo, não a produção combinada de todas as polimerases numa célula. A uma velocidade constante presumida de 1000 nt/s, duas forquilhas bacterianas cobrem 2000 pares de bases do cromossomo parental por segundo. Um cromossomo de 4.600.000 bp precisa, portanto, de 4.600.000 ÷ 2000 = 2300 segundos, ou cerca de 38 minutos. Os aproximadamente 42 minutos dos livros são compatíveis com esses valores arredondados; o cálculo não prevê o intervalo entre divisões celulares bacterianas. Sob condições favoráveis de crescimento, as bactérias podem iniciar outra rodada de replicação antes que a anterior termine.
Para um exemplo humano, use um genoma haploide arredondado de 3.200.000.000 bp e suponha que 10.000 origens igualmente espaçadas sejam todas ativadas juntas. Cada origem envia duas forquilhas a 50 nt/s, resultando em 20.000 forquilhas e uma taxa total de cobertura de 1.000.000 bp/s. Dividir o comprimento do genoma por essa taxa resulta em 3200 segundos, cerca de 53 minutos. Há em média 320.000 bp entre origens, e cada forquilha percorre metade dessa distância antes de encontrar sua vizinha. A mesma resposta resulta de 160.000 ÷ 50.
Esse cálculo deliberadamente ideal é mais curto que as várias horas necessárias para uma célula humana real. As origens não são ativadas todas juntas; regiões diferentes dos cromossomos se replicam em momentos diferentes, e as forquilhas encontram cromatina e outros obstáculos. Se apenas 2000 origens estivessem ativas juntas sob as mesmas premissas, o cálculo resultaria em 16.000 segundos, cerca de 4,4 horas. Essas contagens de origens são exemplos presumidos, não medições de um tecido específico. A comparação explica por que contar apenas as origens potenciais não determina a duração da fase S.
A maioria das células do corpo humano tem dois conjuntos de cromossomos. Na mesma escala arredondada, isso significa duplicar 6.400.000.000 bp, em vez dos 3.200.000.000 bp haploides. Dobrar tanto a quantidade de DNA quanto o número de origens ativas mantém inalterado o tempo ideal de conclusão. O valor anterior de 6 bilhões é uma aproximação diploide mais grosseira, não uma regra diferente para contar pares de bases.
De um nucleotídeo incorreto a uma mutação duradoura
Uma inserção errada, um pareamento incorreto que escapa à revisão e uma mutação mantida após o reparo são contagens diferentes. A revisão de Fijalkowska e colegas apresenta um exemplo bacteriano útil: erros iniciais de inserção em torno de 10⁻⁵, uma fração de escape em torno de 10⁻² após a revisão e em torno de 10⁻³ após o reparo de pareamentos incorretos. A multiplicação resulta em 10⁻¹⁰ erros por base copiada por rodada. Essas contribuições são aproximadas, dependentes do pareamento incorreto e da sequência, não constantes universais para toda polimerase.
Para um exercício aritmético, mantenha o genoma diploide arredondado anterior de 6 bilhões de bp. Copiar ambas as fitas parentais incorpora cerca de 12 bilhões de novos nucleotídeos. A 10⁻⁵, isso gera 120.000 erros iniciais; a 10⁻⁷ após a revisão, gera 1200. Uma taxa final de 10⁻⁹ deixaria uma expectativa de 12 erros nos produtos da replicação, enquanto 10⁻¹⁰ resultaria em 1,2. Um valor esperado fracionário descreve uma média ao longo de muitas divisões; uma célula não pode conter uma fração de uma base alterada. A revisão sozinha não fornece toda a redução de 10⁻⁵ para 10⁻⁹ ou 10⁻¹⁰.
Não transforme esses totais ilustrativos numa afirmação de que toda divisão humana cria exatamente esse número de mutações. Um pareamento incorreto ainda contém instruções conflitantes em suas duas fitas. O reparo pode removê-lo, ou uma rodada posterior de cópia pode estabelecer a sequência alterada numa célula descendente. Os produtos também se separam em células-filhas. Danos ao DNA, tipo celular e fidelidade de diferentes enzimas afetam as contagens observadas de mutações. O par fixo de erros da tela testa a sequência de correção, não uma distribuição de taxas de mutação; reproduzi-lo não é amostrar outra célula.
Quantos fragmentos precisam ser finalizados?
O comprimento dos fragmentos muda a carga de trabalho sem alterar a quantidade de DNA que precisa ser copiada. Usando o comprimento aproximado de 1200 nt para fragmentos bacterianos apresentado na revisão, a contribuição da fita descontínua para um cromossomo circular de 4.600.000 bp é da ordem de 4.600.000 ÷ 1200, ou cerca de 3800 fragmentos. Por que não dividir o dobro do comprimento do cromossomo? Em cada forquilha, uma das duas fitas recém-produzidas é descontínua. Somando ambas as forquilhas, o comprimento produzido descontinuamente é aproximadamente o de um cromossomo, não o das duas novas fitas juntas.
Com um genoma humano diploide arredondado de 6.400.000.000 bp e fragmentos de comprimento médio de 200 nt, a estimativa correspondente é de 32.000.000 de fragmentos. Efeitos das extremidades e diferenças entre regiões impedem que essas divisões forneçam contagens exatas. Mesmo assim, mostram por que a remoção dos primers e a ligação não podem ser raros retoques finais. Uma célula precisa processar milhões de junções numa única fase S. Os fragmentos curtos dos eucariotos estão associados à organização dos nucleossomos, em vez de significar que as polimerases humanas só conseguem sintetizar 200 nucleotídeos antes de perder toda a atividade.
A exposição comprime cada fragmento para 14 nt e cada primer para 5 nt. Isso faz o primer ocupar uma fração muito maior do fragmento que nos exemplos biológicos. Não estime a quantidade de RNA num cromossomo pela proporção de esferas roxas na tela. Observe, em vez disso, a ordem dos acontecimentos: o primer fornece o início, o DNA substitui o primer e a ligase fecha o entalhe restante do esqueleto. A ligase não lê um molde e preenche sozinha um longo trecho ausente de DNA.
As extremidades dos cromossomos e a PCR resolvem problemas diferentes
O ciclo comum da fita descontínua depende de um fragmento vizinho fornecer uma extremidade 3′ que possa ser alongada quando um primer é removido. Na extremidade de um cromossomo linear, essa disposição deixa de funcionar. Telômeros são DNA repetido com proteínas protetoras associadas nas extremidades dos cromossomos. Nas células com telomerase ativa, a enzima usa seu próprio RNA como molde para alongar uma extremidade de DNA; outras máquinas de replicação podem então copiar o DNA complementar. A telomerase não copia o genoma inteiro nem simplesmente cola as duas extremidades dos cromossomos. A forquilha desta exposição é um trecho interno, portanto sua separação final não simula o encurtamento dos telômeros.
A perda de telômeros também não é um relógio exato que indica a idade de alguém contando divisões. O NHGRI descreve o encurtamento e a reposição das repetições em certos tipos de células que se dividem. Esses processos variam entre células. Explicar o problema da replicação das extremidades não é evidência de que aumentar a telomerase seria um tratamento antienvelhecimento seguro.
A PCR copia uma região selecionada de DNA fora de uma célula. Como explica o NHGRI, o aquecimento separa as fitas do molde, e uma polimerase tolerante ao calor sintetiza novo DNA durante ciclos repetidos de temperatura. Numa reação padrão de PCR, primers de DNA fornecidos escolhem os limites do alvo; a primase não continua produzindo primers de RNA numa forquilha em movimento. O aquecimento substitui a função da helicase de abrir as fitas, mas não todas as funções da maquinaria de replicação celular.
Sob uma hipótese ideal de duplicação, 20 ciclos produzem 2²⁰ = 1.048.576 cópias a partir de um único molde inicial de fita dupla. Essa é uma multiplicação teórica, não um rendimento laboratorial garantido: os reagentes se tornam limitantes e a amplificação não é perfeitamente eficiente. A PCR também amplifica o alvo escolhido, em vez de duplicar automaticamente todos os cromossomos de uma célula. O controle Velocidade da exposição não representa um ciclo de temperatura da PCR.
Puxe a forquilha e pareie as bases você mesmo
O anel da helicase é a alça de toda a máquina. Arraste-o ao longo da hélice e a forquilha abre exatamente até onde você puxa: as fitas parentais se separam, as proteínas de ligação se acomodam no molde exposto e as polimerases acompanham. O controle Velocidade acompanha sua mão, por isso um puxão rápido pode ajustá-lo ao valor máximo de 20 bp/s. Puxe no sentido contrário e nada acontece. Uma helicase real se desloca ao longo de uma fita num único sentido, usando energia do ATP, e o sentido oposto é coberto por uma segunda forquilha que sai da mesma origem.
Parear a próxima base transforma você na polimerase da fita contínua. A forquilha para, uma esfera branca marca o próximo lugar livre na nova fita e um anel vermelho marca a base do molde diante dela. Quatro botões oferecem A, T, G e C. A escolha correta segue a regra de pareamento, A com T e G com C, e a fita cresce um par de bases. Uma escolha errada é mantida por um instante; depois, com Revisão ativada, a polimerase recua uma posição, corta a base e insere a correta, como faz a exonuclease de 3′ para 5′. Com Revisão desativada, a base errada permanece, cercada por um anel, e a cópia carrega um pareamento incorreto.
Uma polimerase real não escolhe lendo letras. O nucleotídeo que chega precisa se encaixar na forma de um par correto no sítio ativo, e um par errado se encaixa mal e é adicionado muito mais lentamente. Mesmo assim, cerca de 1 em 100.000 adições está errada antes da revisão, portanto 20 escolhas corretas seguidas não comprovam uma copiadora confiável. O jogo de pareamento também assume o lugar da execução automática: enquanto você escolhe, o relógio para, e os erros programados nas posições 24 e 54 são pulados.
Toque em qualquer proteína da cena, ou em sua etiqueta de nome, para ler o que ela faz. Os cartões repetem resumidamente a lista de peças, para que você conheça a topoisomerase à frente da forquilha, a primase no molde descontínuo, as duas polimerases com suas abraçadeiras, a DNA polimerase I e a ligase sem sair da cena.
Por que uma forquilha mais rápida deixa fragmentos mais longos
A primase não inicia um primer em lugares fixos do DNA. Em E. coli, ela chega da solução, encontra a helicase, produz um primer e sai, e Tougu e Marians mostraram em 1996 que esse encontro acontece cerca de uma vez a cada 1 a 2 segundos e determina o comprimento dos fragmentos. Enquanto isso, a forquilha avança cerca de 1000 nucleotídeos por segundo. Um fragmento a cada 1 a 2 segundos a 1000 nucleotídeos por segundo resulta em fragmentos de 1000 a 2000 nucleotídeos, compatíveis com os cerca de 1200 medidos em bactérias.
O modelo mantém essa ideia com um relógio mais lento. Um novo primer começa a cada 2,8 segundos de tempo de tela, portanto o comprimento do fragmento é a Velocidade multiplicada por 2,8. No padrão de 5 bp/s, isso resulta em 14 nt e 6 fragmentos nos 84 pares de bases. A partir de 13 bp/s, os fragmentos têm 36 nt e só cabem 2; a 3 bp/s, têm 8 nt e são 12. Abaixo de 3 bp/s, o modelo mantém 7 nt como fragmento mais curto, para que um primer de 5 nt ainda deixe espaço para DNA. Mude a Velocidade no meio de uma execução e toda a fita descontínua será redesenhada como se a forquilha sempre tivesse funcionado no novo ritmo.
A outra regra permanece igual em qualquer velocidade: cada fragmento começa com RNA e termina junto ao anterior, e cada união precisa de DNA polimerase I e de uma ligase. Uma forquilha lenta com muitos fragmentos curtos deixa, portanto, mais primers para remover e mais entalhes para fechar. Nos eucariotos, os fragmentos são mais curtos, cerca de 200 nucleotídeos, porque acompanham o espaçamento dos nucleossomos. Uma célula humana finaliza dezenas de milhões deles em cada fase S.
Quanto tempo uma célula humana leva para copiar seu DNA?
Uma célula do corpo humano contém cerca de 6,4 bilhões de pares de bases, dois conjuntos de 3,2 bilhões. Uma forquilha a 50 nucleotídeos por segundo precisaria de 6.400.000.000 ÷ 50 = 128 milhões de segundos, cerca de 4 anos. Uma origem que envia duas forquilhas reduz isso pela metade, para cerca de 2 anos. A calculadora sob a cena começa aí, com uma única origem, e permite aumentar o número de origens ativadas juntas até 100.000, o máximo apresentado pela OpenStax para o genoma humano.
A 50 nucleotídeos por segundo, 2223 origens (4446 forquilhas) bastam para terminar em 8 horas, e a 100 nucleotídeos por segundo basta metade, 1112. Com 10.000 origens, o tempo ideal cai para 107 minutos a 50 nt/s. O livro de biologia celular de Cooper informa cerca de 8 horas para a fase S de uma célula humana que se divide a cada 24 horas, e a OpenStax informa cerca de 10. As células reais usam mais origens que a aritmética exige, porque as origens são ativadas em momentos alternados durante a fase S e as forquilhas param diante de DNA danificado ou muito compactado.
As bactérias se viram com uma origem porque seu cromossomo é curto e suas forquilhas são rápidas. Duas forquilhas a 1000 nucleotídeos por segundo copiam os 4,6 milhões de pares de bases de E. coli em 4.600.000 ÷ 2000 = 2300 segundos, cerca de 38 minutos, próximo dos 42 dos livros. Embriões iniciais de mosca-das-frutas seguem o caminho contrário: um ciclo celular inteiro leva cerca de 8 minutos, por isso o DNA precisa ser copiado a partir de origens muito próximas umas das outras.
Quanto DNA seu corpo copia em um dia?
Sender e Milo estimaram em 2021 que um corpo adulto substitui cerca de 330 bilhões de células por dia, perto de 90 por cento delas células sanguíneas, de um total de aproximadamente 30 trilhões de células humanas. Cada nova célula carrega uma cópia completa do DNA, portanto pelo menos esse número de cópias do genoma é produzido diariamente. Uma cópia tem 6,4 bilhões de pares de bases e, a 0,34 nm por par de bases, isso equivale a cerca de 2,2 m de DNA.
Multiplicando para um adulto de 70 kg, 330 bilhões de cópias de 2,2 m resultam em cerca de 718 milhões de km de DNA por dia, 4,8 vezes os 149,6 milhões de km da Terra ao Sol, ou cerca de 8300 km a cada segundo. A calculadora abaixo da cena ajusta a contagem de células ao peso que você informa: a 60 kg, a cópia diária chega a cerca de 616 milhões de km. Esses números são aproximações do modelo. A renovação varia entre pessoas e com a idade, as hemácias perdem o núcleo ao amadurecer, e algumas células novas vêm de células-tronco que copiam seu DNA num lugar diferente de onde a célula será finalmente usada.
O total lembra o quanto a cópia precisa ser boa. Com a taxa final de erro de cerca de 1 em um bilhão, cada cópia do genoma ainda acumula algumas alterações, e a maioria delas ocorre em DNA que não altera uma proteína. O reparo, a morte celular e o sistema imunológico removem muitas células que apresentam problemas.
De Watson e Crick ao relógio da forquilha: uma breve história
Watson e Crick encerraram seu artigo de 1953 sobre a dupla hélice observando que o pareamento das bases sugeria um mecanismo de cópia. Em 1956, o grupo de Arthur Kornberg produziu DNA num tubo de ensaio com uma enzima de E. coli, a DNA polimerase I, trabalho que dividiu o Prêmio Nobel de Fisiologia ou Medicina de 1959. Em 1958, Meselson e Stahl mostraram com nitrogênio pesado que cada nova dupla hélice conserva uma fita antiga. Em 1963, John Cairns fotografou um cromossomo inteiro de E. coli sendo copiado: um único círculo de cerca de 1 mm de comprimento, com forquilhas em movimento.
Os pedaços da fita descontínua vieram depois. Em 1967, vários laboratórios descobriram a DNA ligase, e Martin Gellert mostrou que extratos de E. coli fecham as extremidades do DNA de lambda em anéis. Em 1968, Reiji Okazaki, Tsuneko Okazaki e colegas marcaram novo DNA durante alguns segundos e o encontraram em pedaços curtos que depois eram unidos. Em 1969, Paula De Lucia e John Cairns descobriram um mutante com pouquíssima polimerase I que ainda copiava seu DNA, apontando para uma enzima principal diferente, a polimerase III.
Trabalhos posteriores explicaram o restante da máquina na cena. Watson descreveu o problema das extremidades do DNA linear em 1972, o grupo de Gellert descobriu a DNA girase em 1976, e Greider e Blackburn descobriram a telomerase em 1985. Em 1992, o grupo de Kuriyan resolveu a estrutura da abraçadeira deslizante, um anel ao redor do DNA. Kary Mullis dividiu o prêmio de química de 1993 pela PCR, o relógio dos fragmentos de Okazaki de Tougu e Marians veio em 1996 e, em 2015, Lindahl, Modrich e Sancar dividiram o prêmio de química pelo reparo do DNA. O catálogo abaixo da cena tem um cartão para cada um, com o artigo original.
Verificações para fazer na cena
Primeiro pause no meio da cópia e desative Cores dos pares de bases em Controles. Encontre a fita contínua laranja e depois localize um primer roxo num fragmento verde-azulado da fita descontínua. Siga as novas fitas de 5′ para 3′ usando as etiquetas de direção. Seus sentidos de crescimento precisam concordar quimicamente, embora uma polimerase viaje em direção à forquilha e a outra trabalhe se afastando dela. "Descontínua" não significa que essa fita seja sintetizada de 3′ para 5′.
Depois reproduza a mesma região com Revisão ativada e desativada, mantendo Velocidade inalterada. Compare o marcador magenta de erro com os indicadores Copiado e Okazaki quando a polimerase pausa. Isso isola o atraso programado da revisão. Mudar a Velocidade entre as execuções também mudaria o relógio da animação e não seria uma comparação justa. Uma reprodução mais rápida com revisão desativada não comprova que as células reais se beneficiam de desativar o reparo.
Por fim, ative Meselson e Stahl e compare os tubos de gerações sucessivas. Após uma geração, a banda intermediária rejeita o modelo conservativo, mas não rejeita sozinha a cópia dispersiva. A segunda geração fornece a distinção: bandas híbrida e leve separadas, em vez de uma única banda que se desloca progressivamente para leve. Nitrogênio-15 é um isótopo estável usado como marcador de densidade, não um traçador radioativo. Os tubos informam a densidade do DNA, não a cor das bases recém-sintetizadas. A animação e o experimento dos tubos respondem a perguntas diferentes: a animação ilustra as operações da forquilha, enquanto o experimento dos tubos testa como o material parental se distribui entre as moléculas-filhas.
Depois puxe a helicase rápida e lentamente, deixando a forquilha chegar ao fim a cada vez, e conte os fragmentos da fita descontínua no indicador Okazaki. Faça uma previsão primeiro em Prever os fragmentos. Por fim, pareie bases manualmente com Revisão ativada e desativada e compare o indicador Revisão: escolhas erradas são retiradas no primeiro caso e contadas como mantidas no segundo.
Perguntas
Por que a DNA polimerase não consegue construir ambas as fitas continuamente?
Ela só pode acrescentar nucleotídeos a uma extremidade 3′, portanto toda nova fita cresce de 5′ para 3′. Os dois moldes seguem em sentidos opostos, por isso apenas uma nova fita pode crescer em direção à forquilha que se abre. A outra precisa ser produzida em pedaços que crescem se afastando dela.
Qual é a diferença entre a fita contínua e a descontínua?
A fita contínua é produzida numa peça única a partir de um único primer e acompanha a helicase. A fita descontínua é produzida em pequenos fragmentos de Okazaki, cada um com seu próprio primer, que depois são unidos pela DNA ligase.
Por que o primer é feito de RNA?
A DNA polimerase não consegue iniciar uma nova cadeia, mas a primase, uma RNA polimerase, consegue. O curto RNA fornece à DNA polimerase uma extremidade 3′ para alongar. Depois o RNA é removido e substituído por DNA.
Com que frequência a DNA polimerase comete um erro?
A Nature Education informa cerca de 1 nucleotídeo errado em 100.000 durante a síntese. A revisão corrige cerca de 99 por cento deles, e o reparo de pareamentos incorretos após a replicação detecta mais.
Com que rapidez o DNA é copiado?
Cerca de 1000 nucleotídeos por segundo em cada forquilha de E. coli, segundo a OpenStax. Nas células humanas, a OpenStax informa de 50 a 100 nucleotídeos por segundo e a Nature Education cerca de 40. Muitas forquilhas trabalham ao mesmo tempo.
O que significa semiconservativa?
Cada uma das duas novas duplas hélices contém uma fita da molécula original e uma fita recém-produzida. Meselson e Stahl demonstraram isso em 1958 com nitrogênio pesado e leve.
O que acontece nas extremidades de um cromossomo?
Num cromossomo linear, o último primer da fita descontínua não pode ser substituído por DNA, portanto as extremidades encurtariam um pouco a cada divisão. A telomerase, uma enzima com seu próprio molde de RNA, acrescenta repetições de TTAGGG às extremidades nas células onde está ativa.
A fita descontínua cresce no sentido químico oposto?
Não. Ambas as novas fitas crescem de 5′ para 3′. A fita descontínua cresce para longe da forquilha em fragmentos separados; seu sentido de síntese não foi invertido.
A revisão sozinha explica a taxa final de erro?
Não. A seleção de bases, a revisão e o reparo de pareamentos incorretos contribuem com reduções separadas. O exemplo bacteriano aproximado de 10⁻⁵ a 10⁻¹⁰ inclui todos eles; não é uma contagem universal de mutações para células humanas.
O nitrogênio-15 é radioativo?
Não. É um isótopo estável do nitrogênio. Meselson e Stahl acompanharam diferenças de densidade no DNA, em vez de detectar decaimento radioativo.
A PCR é igual à forquilha na tela?
Ambas usam um molde e uma polimerase, mas a PCR padrão usa aquecimento para separar as fitas e primers de DNA fornecidos para selecionar um alvo. O modelo, em vez disso, mostra uma forquilha celular movida pela helicase, com primers de RNA e processamento da fita descontínua.
Por que alguns fragmentos de Okazaki são mais longos que outros?
Seu comprimento depende da frequência com que a primase inicia um novo primer em comparação à velocidade da forquilha. Em E. coli, a primase encontra a helicase cerca de uma vez a cada 1 a 2 segundos enquanto a forquilha avança cerca de 1000 nucleotídeos por segundo, gerando fragmentos de 1000 a 2000 nucleotídeos; os fragmentos eucarióticos têm cerca de 200. Na cena, uma Velocidade maior resulta em menos fragmentos, mais longos.
Quanto DNA meu corpo copia por dia?
Aproximadamente 330 bilhões de células são substituídas diariamente num adulto, e cada nova célula precisa de uma cópia de cerca de 6,4 bilhões de pares de bases, aproximadamente 2,2 m de DNA. Isso soma várias centenas de milhões de quilômetros por dia, algumas vezes a distância da Terra ao Sol. A calculadora sob a cena faz essa conta para seu peso como uma estimativa aproximada.
Termos
- Forquilha de replicação: a região em forma de Y onde a dupla hélice está sendo aberta e copiada.
- Helicase: a enzima que separa as duas fitas rompendo as ligações de hidrogênio entre pares de bases.
- Topoisomerase: uma enzima que alivia o enrolamento excessivo à frente da forquilha cortando e religando o DNA.
- Proteína de ligação à fita simples (SSB): uma proteína que reveste o DNA de fita simples e impede que volte a formar uma hélice.
- Primase: a RNA polimerase que produz primers.
- Primer: uma curta fita de RNA que fornece à DNA polimerase uma extremidade 3′ para começar.
- Fita contínua: a nova fita produzida continuamente em direção à forquilha.
- Fita descontínua: a nova fita produzida em pedaços para longe da forquilha.
- Fragmento de Okazaki: um dos pequenos pedaços da fita descontínua.
- Abraçadeira deslizante: uma proteína em forma de anel que mantém a DNA polimerase no DNA (PCNA nos eucariotos).
- DNA ligase: a enzima que fecha um entalhe (nick) formando uma ligação fosfodiéster.
- Revisão: remoção de um nucleotídeo adicionado incorretamente pela exonuclease de 3′ para 5′ da polimerase.
- Replicação semiconservativa: cópia na qual cada nova hélice conserva uma fita antiga.
Fontes
OpenStax, Biology 2e, 14.2 DNA Structure and Sequencing (0,34 nm por par de bases, 2 nm de largura, 3,4 nm e 10 pares de bases por volta). https://openstax.org/books/biology-2e/pages/14-2-dna-structure-and-sequencing (consultado: 16 de outubro de 2026)
OpenStax, Biology 2e, 14.3 Basics of DNA Replication (Meselson e Stahl, replicação semiconservativa). https://openstax.org/books/biology-2e/pages/14-3-basics-of-dna-replication (consultado: 16 de outubro de 2026)
OpenStax, Biology 2e, 14.4 DNA Replication in Prokaryotes (helicase, SSB, topoisomerase, primers de 5 a 10 nucleotídeos, abraçadeira deslizante, DNA pol I e ligase, E. coli com 4,6 milhões de pares de bases em cerca de 42 minutos, 1000 nucleotídeos por segundo). https://openstax.org/books/biology-2e/pages/14-4-dna-replication-in-prokaryotes (consultado: 16 de outubro de 2026)
OpenStax, Biology 2e, 14.5 DNA Replication in Eukaryotes (6 bilhões de pares de bases, até 100.000 origens, 50 a 100 nucleotídeos por segundo, pol ε e pol δ, PCNA, RNase H, telomerase). https://openstax.org/books/biology-2e/pages/14-5-dna-replication-in-eukaryotes (consultado: 16 de outubro de 2026)
OpenStax, Biology 2e, 14.6 DNA Repair (revisão pela exonuclease 3′, reparo de pareamentos incorretos). https://openstax.org/books/biology-2e/pages/14-6-dna-repair (consultado: 16 de outubro de 2026)
Nature Education, Scitable: Major Molecular Events of DNA Replication (cerca de 40 nucleotídeos por segundo nos eucariotos, Okazaki et al. 1968). https://www.nature.com/scitable/topicpage/major-molecular-events-of-dna-replication-413/ (consultado: 16 de outubro de 2026)
Balakrishnan, L. e Bambara, R. A., Okazaki fragment metabolism, Cold Spring Harbor Perspectives in Biology 5, a010173 (2013) (fragmentos de Okazaki com cerca de 1200 nucleotídeos em bactérias e cerca de 200 nos eucariotos). https://pmc.ncbi.nlm.nih.gov/articles/PMC3552508/ (consultado: 16 de outubro de 2026)
Nature Education, Scitable: DNA Replication and Causes of Mutation (cerca de 1 erro por 100.000 nucleotídeos, a revisão corrige cerca de 99 por cento, pares de balanço (wobble)). https://www.nature.com/scitable/topicpage/dna-replication-and-causes-of-mutation-409/ (consultado: 16 de outubro de 2026)
Nature Education, Scitable: Semi-Conservative DNA Replication: Meselson and Stahl (os três modelos e o experimento de 1958). https://www.nature.com/scitable/topicpage/semi-conservative-dna-replication-meselson-and-stahl-421/ (consultado: 16 de outubro de 2026)
Meselson, M. e Stahl, F. W., The replication of DNA in Escherichia coli, Proceedings of the National Academy of Sciences 44, 671 a 682 (1958). https://pmc.ncbi.nlm.nih.gov/articles/PMC528642/ (consultado: 16 de outubro de 2026)
Wang, J. C., Helical repeat of DNA in solution, Proceedings of the National Academy of Sciences 76, 200 a 203 (1979) (10,4 ± 0,1 pares de bases por volta). https://pmc.ncbi.nlm.nih.gov/articles/PMC382905/ (consultado: 16 de outubro de 2026)
National Human Genome Research Institute, Talking Glossary: DNA Replication (várias horas de cópia para uma célula humana). https://www.genome.gov/genetics-glossary/DNA-Replication (consultado: 16 de outubro de 2026)
NobelPrize.org, The Nobel Prize in Physiology or Medicine 1959 (Severo Ochoa e Arthur Kornberg). https://www.nobelprize.org/prizes/medicine/1959/summary/ (consultado: 16 de outubro de 2026)
Fijalkowska, I. J., Schaaper, R. M. e Jonczyk, P., DNA replication fidelity in Escherichia coli: a multi-DNA polymerase affair, FEMS Microbiology Reviews 36, 1105 a 1121 (2012) (contribuições sequenciais da inserção, revisão e reparo de pareamentos incorretos). https://pmc.ncbi.nlm.nih.gov/articles/PMC3391330/ (consultado: 22 de outubro de 2026)
National Human Genome Research Institute, Telomere (extremidades protetoras dos cromossomos, encurtamento e telomerase em certas células). https://www.genome.gov/genetics-glossary/Telomere (consultado: 22 de outubro de 2026)
National Human Genome Research Institute, Polymerase Chain Reaction Fact Sheet (separação por calor, Taq polimerase e ciclos repetidos de cópia). https://www.genome.gov/about-genomics/fact-sheets/Polymerase-Chain-Reaction-Fact-Sheet (consultado: 22 de outubro de 2026)
Tougu, K. e Marians, K. J., The interaction between helicase and primase sets the replication fork clock, Journal of Biological Chemistry 271, 21398 a 21405 (1996) (um fragmento de Okazaki a cada 1 a 2 segundos em E. coli). https://doi.org/10.1074/jbc.271.35.21398 (consultado: 27 de outubro de 2026)
Sender, R. e Milo, R., The distribution of cellular turnover in the human body, Nature Medicine 27, 45 a 48 (2021) (cerca de 330 bilhões de células substituídas por dia, perto de 90 por cento de células sanguíneas). https://doi.org/10.1038/s41591-020-01182-9 (consultado: 27 de outubro de 2026)
Sender, R., Fuchs, S. e Milo, R., Revised estimates for the number of human and bacteria cells in the body, PLoS Biology 14, e1002533 (2016) (cerca de 30 trilhões de células humanas num homem de referência de 70 kg). https://doi.org/10.1371/journal.pbio.1002533 (consultado: 27 de outubro de 2026)
Cooper, G. M., The Cell: A Molecular Approach, 2ª edição, The Eukaryotic Cell Cycle (fase S de cerca de 8 horas num ciclo celular humano de 24 horas). https://www.ncbi.nlm.nih.gov/books/NBK9876/ (consultado: 27 de outubro de 2026)
OpenStax, Biology 2e, 10.3 Control of the Cell Cycle (fase S de cerca de 10 horas em células humanas que se dividem rapidamente, ciclo celular do embrião de mosca-das-frutas de cerca de 8 minutos). https://openstax.org/books/biology-2e/pages/10-3-control-of-the-cell-cycle (consultado: 27 de outubro de 2026)
Watson, J. D. e Crick, F. H. C., Molecular structure of nucleic acids, Nature 171, 737 a 738 (1953). https://www.nature.com/articles/171737a0 (consultado: 27 de outubro de 2026)
Cairns, J., The bacterial chromosome and its manner of replication as seen by autoradiography, Journal of Molecular Biology 6, 208 a 213 (1963). https://doi.org/10.1016/S0022-2836(63)80070-4 (consultado: 27 de outubro de 2026)
Gellert, M., Formation of covalent circles of lambda DNA by E. coli extracts, Proceedings of the National Academy of Sciences 57, 148 a 155 (1967). https://doi.org/10.1073/pnas.57.1.148 (consultado: 27 de outubro de 2026)
Okazaki, R. e colegas, Mechanism of DNA chain growth, I, Proceedings of the National Academy of Sciences 59, 598 a 605 (1968). https://doi.org/10.1073/pnas.59.2.598 (consultado: 27 de outubro de 2026)
De Lucia, P. e Cairns, J., Isolation of an E. coli strain with a mutation affecting DNA polymerase, Nature 224, 1164 a 1166 (1969). https://doi.org/10.1038/2241164a0 (consultado: 27 de outubro de 2026)
Watson, J. D., Origin of concatemeric T7 DNA, Nature New Biology 239, 197 a 201 (1972). https://doi.org/10.1038/newbio239197a0 (consultado: 27 de outubro de 2026)
Gellert, M., Mizuuchi, K., O'Dea, M. H. e Nash, H. A., DNA gyrase: an enzyme that introduces superhelical turns into DNA, Proceedings of the National Academy of Sciences 73, 3872 a 3876 (1976). https://doi.org/10.1073/pnas.73.11.3872 (consultado: 27 de outubro de 2026)
Greider, C. W. e Blackburn, E. H., Identification of a specific telomere terminal transferase activity in Tetrahymena extracts, Cell 43, 405 a 413 (1985). https://doi.org/10.1016/0092-8674(85)90170-9 (consultado: 27 de outubro de 2026)
Kong, X.-P., Onrust, R., O'Donnell, M. e Kuriyan, J., Three-dimensional structure of the beta subunit of E. coli DNA polymerase III holoenzyme: a sliding DNA clamp, Cell 69, 425 a 437 (1992). https://doi.org/10.1016/0092-8674(92)90445-I (consultado: 27 de outubro de 2026)
NobelPrize.org, The Nobel Prize in Chemistry 1993 (Kary B. Mullis, PCR) e 2015 (Lindahl, Modrich e Sancar, reparo do DNA). https://www.nobelprize.org/prizes/chemistry/2015/summary/ (consultado: 27 de outubro de 2026)
Texto e simulação: CC BY-NC-SA 4.0, salvo indicação em contrário.
Mais exposições

CRISPR-Cas9: simulador interativo de edição genética
Um RNA guia lê só 20 letras de DNA, e isso costuma bastar para escolher um único ponto entre os 3 bilhões de pares de bases de um genoma humano.

ATP sintase: explore como funciona seu rotor molecular
Nas mitocôndrias, o rotor da ATP sintase gira cerca de 100 vezes por segundo. Cada volta completa libera três moléculas de ATP.
Passeio dentro de uma célula: animal, vegetal e bactéria
Ampliada um milhão de vezes, uma mitocôndria fica mais ou menos do tamanho de um sofá, uma E. coli inteira mede 2 m e a cinesina que reboca uma vesícula ao seu lado anda a 0,8 metro por segundo.
Impulso nervoso e sinapse: teste como o sinal se propaga
Uma célula nervosa fica perto de −70 mV. Ao atingir cerca de −55 mV com um estímulo, dispara um potencial sempre da mesma amplitude.

Sequoia gigante: por que as sequoias crescem tanto?
Ao pé do General Sherman Tree, com 83,8 m e cerca de 2200 anos, escale o tronco e veja a tração sobre a água lá no alto.

Comparação de tamanho dos dinossauros: 172 animais
Um parque de 600 m com 172 animais pré-históricos em tamanho real, dos primeiros dinossauros ao T. rex, organizados por período.