图 59原理馆
DNA 复制原理:在 3D 中逐步观察冈崎片段
DNA 聚合酶只能在链的一端添加,因此每个复制叉处,一条新链连续生长,另一条则以短片段形式合成。
这台设备无法显示 3D 模型。下面的讲解步骤可以直接阅读文字。
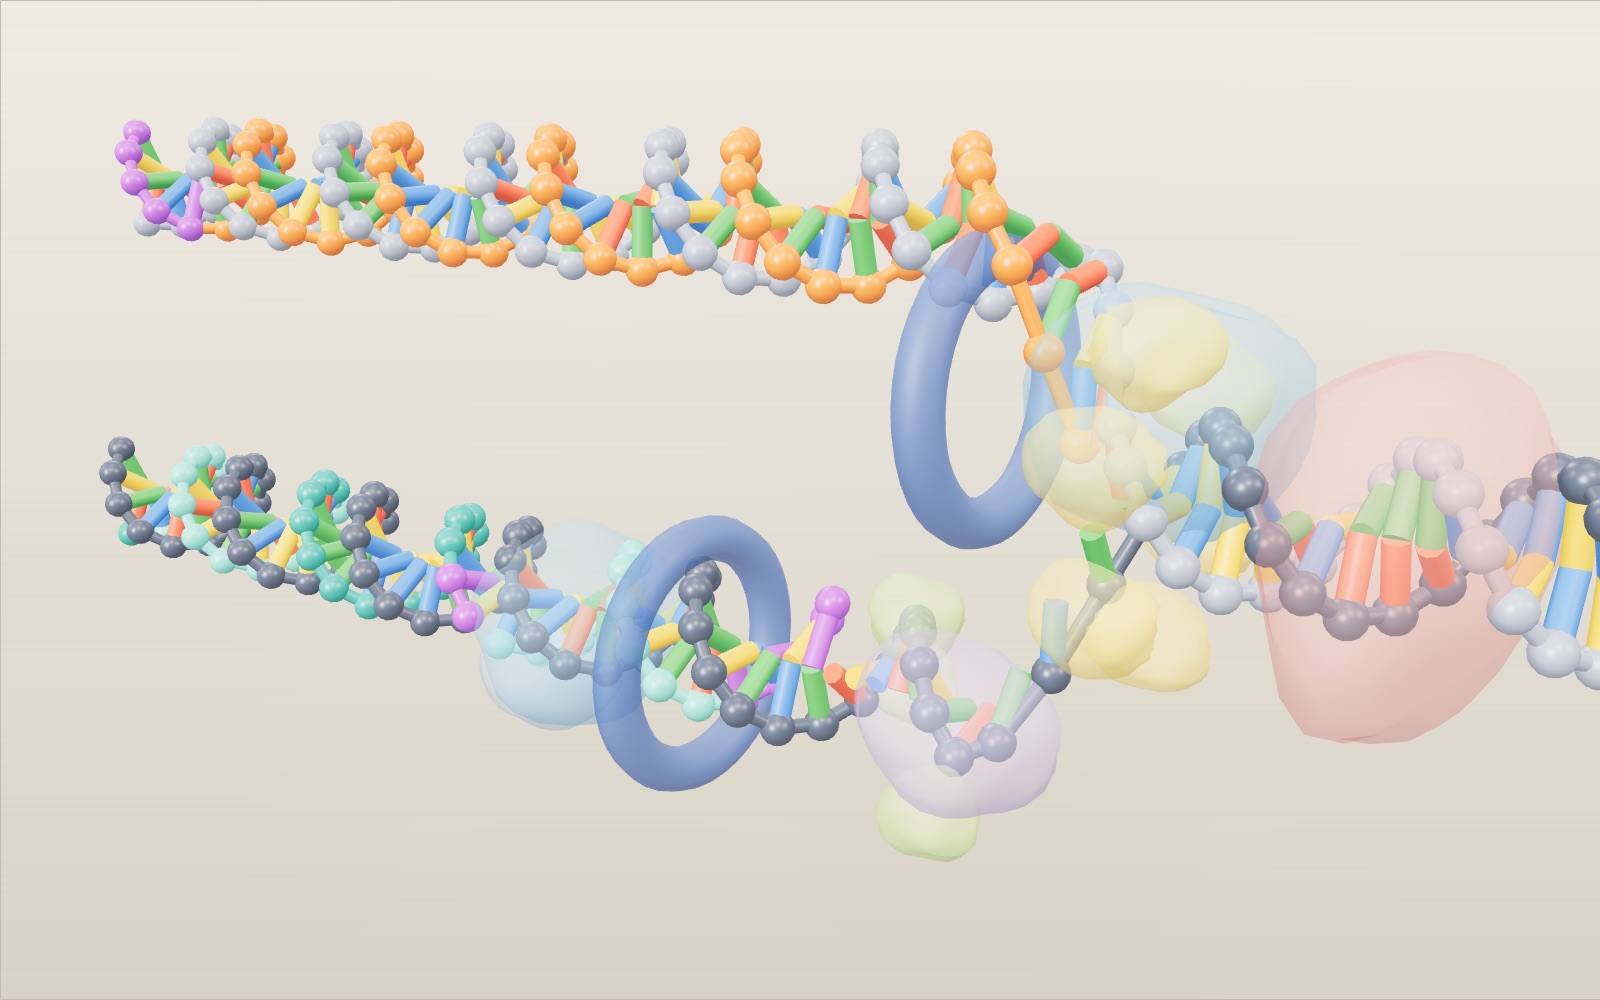
1 / 11 按比例展示 84 个碱基对的 DNA这段 DNA 约长 29 nm。下方标尺给出比例:在溶液中,一圈为 10.5 个碱基对(3.57 nm),教材则将其取整为 10 个碱基对、3.4 nm。序列为模型编造。
拖动可旋转,滚轮或双指缩放。
细胞分裂前怎样复制 DNA?
DNA 复制在不断移动的 Y 形复制叉处,分几个步骤进行。解旋酶解开双螺旋,引物酶合成一段短 RNA 引物。DNA 聚合酶只能在 3′ 端添加核苷酸,因此前导链连续生长,后随链则以冈崎片段的形式向后合成,随后 DNA 聚合酶 I 和连接酶用 DNA 替换引物并封闭缺口。人的一个复制叉每秒复制 50 至 100 个核苷酸,人体细胞在约 8 至 10 小时的 S 期内复制其 64 亿个碱基对。
手上的伤口能愈合,是因为皮肤细胞会分裂,而每个新细胞都需要自己完整的一套 DNA。对人体细胞而言,这意味着在一分为二之前,要复制约 60 亿个碱基对。复制工作由一组蛋白质在不断移动的 Y 形交汇处完成,这里就是复制叉。它们必须解开螺旋,启动每条新链,逐个碱基构建新链,发现自己的错误,并把留下的片段连接起来。
这件展品在分子尺度上构建了一个复制叉。长 84 个碱基对的一段 DNA 横贯舞台。解旋酶将它打开,引物酶合成短 RNA 起始片段,两个 DNA 聚合酶构建新链,DNA 聚合酶 I 和 DNA 连接酶整理后随链,最后两个双螺旋分开。开场镜头就在解旋酶旁边,展示它解开螺旋的过程。拖动黄色解旋酶环,亲手牵动复制叉;按「配对下一个碱基」,像聚合酶那样放入碱基;点按任一酶,阅读它的工作。用滑块浏览整个过程,用「速度」控制节奏,同时改变冈崎片段的长度,再用「校对」开关观察聚合酶不再检查自身工作时会发生什么。这里的资料来自 OpenStax 生物学教材、Nature Education、美国国家人类基因组研究所,以及梅塞尔森和斯塔尔在 1958 年发表的原始论文。参考资料列在文末。
模型尺度下的双螺旋
DNA 由两条相互缠绕的链组成。每条链都是糖和磷酸连接成的长链,每个糖上带有四种碱基之一:A、C、G 或 T。一条链上的 A 与另一条链上的 T 配对,C 与 G 配对。这条规则使复制成为可能:两条链一旦分开,每条都带有重建其配对链所需的全部信息。模型中,A 为绿色,T 为红色,G 为黄色,C 为蓝色。RNA 用 U 代替 T,U 为紫色。
相邻碱基对相距 0.34 nm,螺旋宽 2 nm。教材常说,螺旋每 10 个碱基对转一圈,即 3.4 nm。这个数字来自 DNA 纤维的 X 射线图像。在溶液中测量,也就是像细胞内那样的环境下,DNA 的缠绕略松:James Wang 在 1979 年测得每圈 10.4 个碱基对,最常采用的数值则是 10.5。模型使用 10.5,所以一圈为 10.5 × 0.34 = 3.57 nm。模型下方的两根标尺同时展示二者:一根表示模型的一圈,另一根表示教材的 3.4 nm,便于比较。整个模型长 84 × 0.34 = 28.6 nm。
两条链的方向相反。化学家给每个糖的碳原子编号,链的两端据此称为 5′ 端和 3′ 端。一条从左到右为 5′ 至 3′ 的链,与一条从右到左为 5′ 至 3′ 的链配对。这个细节称为双链反向平行,它决定了复制叉处的大部分过程。
什么打开螺旋,又让它保持打开?
打开 DNA 的酶是解旋酶。它利用 ATP 提供的能量,打断配对碱基之间的氢键。在它工作的地方,双螺旋分成两条单链,形成的形状就是复制叉。在模型中,解旋酶是位于两条链分开处的黄色环,随复制叉一同前进。
把两条缠绕的链拉开,会带来一个副作用。复制叉前方的 DNA 会越缠越紧,就像从一端拉开绳子的股线时,前方扭紧的绳子会打结。OpenStax 介绍,拓扑异构酶通过暂时切开复制叉前方的螺旋,再重新封合,防止这种过度缠绕。模型中,它是位于尚未打开的 DNA 上的粉红色团块,比解旋酶靠前几圈。
打开的单链如果无人干预,还会重新配对。单链结合蛋白覆盖在它们上面,使它们保持分开,直到聚合酶到达。模型中,它们是绿色小团块。观察它们聚集的位置:几乎都在下方模板上,因为这条链等待复制的时间最长。原因就在接下来这一部分。
聚合酶为什么需要引物?
DNA 聚合酶一次添加一个核苷酸,每个都与模板上相对位置的碱基配对。形成每个新键的能量来自进入的核苷酸本身,它以三磷酸形式到达。但这种酶有两项严格限制:它只能在链的 3′ 端添加,而且必须已经有一条链存在。它不能从零开始。
引物酶解决了起始问题。它是一种 RNA 聚合酶,而 RNA 聚合酶无需已有的配对链就能启动新链。根据 OpenStax,引物酶合成与模板互补的一小段 RNA,长约 5 至 10 个核苷酸。这段引物为 DNA 聚合酶提供可供延伸的游离 3′ 端。模型中的引物长 5 个核苷酸,画成紫色珠子。最左端的一个引物启动上方新链,下方新链则需要一再获得新引物。
只能沿一个方向合成,对两条链有什么影响?
由于聚合酶只能在 3′ 端添加,每条新链都沿 5′ 至 3′ 方向生长。现在看两条模板。在上方模板上,新链的 5′ 至 3′ 方向朝向复制叉。随着更多模板暴露,聚合酶可以跟着解旋酶,不断延伸同一条链。这条连续合成的链就是前导链,在模型中为橙色,由一个引物启动构建。
在下方模板上,新链必须朝另一个方向,也就是远离复制叉的方向生长。复制叉打开时,新暴露的模板出现在聚合酶身后,而不是前方。要复制它,只能在靠近复制叉处启动一个新片段,向后构建,直到与之前合成的片段相遇。每一段都称为冈崎片段,由这些片段构成的链称为后随链。模型中用深浅交替的两种蓝绿色表示这些片段。
在「控制」选项卡中关闭「碱基对颜色」,就能看得更清楚。旧链变为灰色,两类新链保留各自的颜色。前导链是一条橙色长线,后随链则是一排短的蓝绿色片段,每段右端带有紫色引物。
后随链上的冈崎片段
后随链重复着同一个循环。引物酶在靠近复制叉处放下引物。后随链聚合酶由环形滑动夹固定在 DNA 上,沿远离复制叉的方向延伸该引物,直到遇到前一个片段。然后它松开,移到下一个引物处。模型中,你可以观察第二个聚合酶及其深蓝色滑动夹在完成每段后,跳回靠近复制叉的位置。
真实片段远比模型的 14 个核苷酸长。Balakrishnan 和 Bambara 的综述指出,细菌的冈崎片段约长 1,200 个核苷酸,而真核细胞中仅约 200 个,其长度与核小体的间距相对应。模型将片段缩短,使屏幕上能同时放下几段。读数中的「冈崎片段」一行统计两个数字:已经启动了多少个片段,以及已有多少个与相邻片段连接。
用 DNA 替换引物并封闭切口
完成合成的片段一端仍有 RNA,而新合成的 DNA 链不应含有 RNA。在细菌中,DNA 聚合酶 I 利用其外切核酸酶活性去除每个引物,并以其后方片段的 DNA 为起点,用 DNA 填补空缺。真核细胞以不同方式完成这项工作:聚合酶 δ 将引物置换成瓣状结构,瓣状内切核酸酶 1(FEN1)再将其切除。RNase H 也可参与引物去除,但 RNase H 与 FEN1 是不同的酶。模型展示细菌的方式:浅蓝色的酶把紫色珠子变成蓝绿色珠子。
替换完成后,两段 DNA 首尾相接,却还没有连在一起。它们之间缺少一个磷酸二酯键,这种缺口称为切口。DNA 连接酶在一段的 3′ 端与下一段的 5′ 端之间形成这个键。模型中,橙色连接酶会在切口处停留片刻,圆环闪过,骨架上的连接随即出现。这时,已连接计数才会增加。
聚合酶怎样撤回错误碱基?
聚合酶有时会放入错误碱基。Nature Education 给出的频率约为每 100,000 个核苷酸中有 1 个。错误碱基在螺旋中嵌合不佳,其 3′ 端的位置也不适合下一次添加。聚合酶发现问题后后退,利用 3′ 至 5′ 外切核酸酶活性切除错误核苷酸,再放入正确的核苷酸。这就是校对。OpenStax 将其描述为聚合酶在添加下一个碱基之前,检查每个刚添加的碱基。
模型在前导链上预设了两个错误:G 对面有一个 T,T 对面有一个 G。两者都是 Nature Education 所述的摆动配对这一类错配。打开「校对」时,聚合酶会在每处停下:错误碱基变成品红色,向外摆出,消失,再被替换。停顿期间,解旋酶也会等待,因此复制叉会落后。关闭「校对」后,重放同一段。复制叉更早到达各处,冈崎片段计数也会领先,但两个错误碱基仍留在新链中,外有品红色圆环,读数会显示留下了多少个错误。
核对数字
模型的默认速度为每秒 5 个碱基对。根据 OpenStax,人的复制叉每秒移动 50 至 100 个核苷酸,Nature Education 给出的数值约为 40。因此,模型的速度比真实人体复制叉慢约 10 至 20 倍。细菌的复制叉快得多:E. coli 用两个复制叉,在约 42 分钟内复制其 460 万个碱基对的染色体,换算为每个复制叉每秒约 1,000 个核苷酸。
人的一个复制叉能复制整个基因组吗?以每秒 50 个核苷酸计算,60 亿个碱基对需要 6,000,000,000 ÷ 50 = 1.2 亿秒,接近四年。细胞通过同时启动许多复制叉来避免这种情况;OpenStax 指出,人类可有多达 100,000 个复制起点。美国国家人类基因组研究所则指出,一个人体细胞的复制需数小时。
错误也会这样累积。复制 60 亿个碱基对,意味着铺设约 120 亿个新核苷酸,每个模板碱基对面各有一个。按每 100,000 个中有 1 个错误计算,未经检查时,每次分裂约会产生 120,000 个错误碱基。校对能修正其中约 99%,留下约 1,200 个。复制后的错配修复会进一步降低这个数量。模型在 84 个碱基对中预设 2 个错误,远远高于真实情况;它们的作用是让你能看清纠错过程。
模型省略了什么?
模型展示一个复制叉。真实复制从复制起点开始,打开形成复制泡,两个复制叉向两侧分开;E. coli 的两个复制叉沿环状染色体相向而行,最终相遇,各自复制约半个圆。模型缩短了片段和引物,并且仅在固定位置预设两个错误。
蛋白质画成柔软团块,而非实测形状,并且采用透明外观,便于你追踪 DNA。它们的位置依据教材图示:拓扑异构酶在复制叉前方,单链结合蛋白位于裸露模板上,滑动夹环绕各条新双螺旋,紧邻相应聚合酶。两个聚合酶画成分开的团块,便于追踪每条新链。最左端的前导链引物也保留原位,因为本应将它移除的复制叉位于画面左边之外。
蛋白质名称采用细菌的命名方式:DNA 聚合酶 III 负责主要复制,DNA 聚合酶 I 替换引物。真核细胞用不同酶完成相同步骤:前导链使用 pol ε,后随链使用 pol δ,PCNA 充当滑动夹,引物加工由 FEN1 完成,RNase H 也有贡献。随着复制叉通过,它们还须移除并重新安放组蛋白。OpenStax 提出,这可能是真核复制叉较慢的部分原因。
舞台上的一些数字是模型设定值。片段长度等于「速度」乘以屏幕时间 2.8 秒的引发间隔,并限制在 7 至 36 个核苷酸之间,所以 5 bp/s 对应 14 nt。手动配对一个碱基,会让复制叉移动一个碱基对,同时跳过两个预设错误,因此错误只来自你自己的选择。舞台下方的计算器假设复制起点均匀分布、全部同时启动,且复制叉从不停滞,并按体重比例缩放 70 kg 成人的细胞更新量。
我们怎样知道每个新螺旋保留了一条旧链?
詹姆斯·沃森和弗朗西斯·克里克在 1953 年发表双螺旋结构时指出,配对规则暗示了一种复制机制。关于其运作方式,当时有三种设想。半保留复制中,每个新螺旋保留一条旧链,获得一条新链。保留复制中,旧螺旋保持完整,在旁边构建一个全新的螺旋。分散复制中,新旧 DNA 以片段形式混合分布在两条链上。
加州理工学院的马修·梅塞尔森和富兰克林·斯塔尔在 1958 年检验了这些设想。他们让 E. coli 在唯一氮源为重同位素氮-15 的培养基中生长许多代,然后将细胞转移到普通氮-14 培养基中,在细胞分裂时取样。DNA 在氯化铯密度梯度中离心,会停留在自身密度与溶液相同的位置,因此重 DNA 和轻 DNA 形成不同条带。转移之前只有一条重带。经过一代后,只有一条位于轻重之间的条带,这排除了保留复制。经过两代后,出现两条带,一条为杂合带,一条为轻带,这排除了分散复制模型。每个新螺旋都保留了一条旧链。在「控制」选项卡打开「梅塞尔森和斯塔尔」,即可在读数区看到这三支试管。
后随链片段由冈崎令治及其同事发现。他们在 1968 年报告,新合成的 DNA 最初以短片段出现,随后连接成长链。对酶本身的试管研究则更早。阿瑟·科恩伯格和塞韦罗·奥乔亚共同获得 1959 年诺贝尔生理学或医学奖,用诺贝尔委员会的话说,是「因为他们发现了核糖核酸和脱氧核糖核酸生物合成的机制」。
需要多少个复制叉,才能在数小时内完成人类基因组?
复制叉速度是单位时间内沿模板前进的距离,并非一个细胞内所有聚合酶的合计产量。假设速度恒为 1,000 nt/s,两个细菌复制叉每秒覆盖亲本染色体的 2,000 个碱基对。因此,4,600,000 bp 的染色体需要 4,600,000 ÷ 2,000 = 2,300 秒,即约 38 分钟。教材所说的约 42 分钟与这些取整输入相容;这个计算并不是对细菌两次细胞分裂间隔的预测。在适宜的生长条件下,细菌可在上一轮复制完成前就开始下一轮。
以人类为例,采用取整的单倍体基因组 3,200,000,000 bp,并假设 10,000 个均匀分布的复制起点全部同时启动。每个起点放出两个速度为 50 nt/s 的复制叉,总计 20,000 个复制叉,总覆盖速度为 1,000,000 bp/s。基因组长度除以该速度,得到 3,200 秒,约 53 分钟。起点之间平均相距 320,000 bp,每个复制叉在遇到相邻复制叉之前走过这段距离的一半。用 160,000 ÷ 50 计算,也得到相同答案。
这个刻意理想化的计算结果,比真实人体细胞所需的数小时更短。复制起点并不全部同时启动;染色体不同区域在不同时段复制,复制叉也会遇到染色质和其他障碍。如果在同样假设下,只有 2,000 个起点同时活跃,计算结果会是 16,000 秒,约 4.4 小时。这些起点数量是假设示例,并非某种特定组织的测量值。这一比较说明,仅统计潜在起点,无法确定 S 期长度。
人体大多数体细胞有两套染色体。按同样的取整尺度,待复制的量是 6,400,000,000 bp,而非单倍体的 3,200,000,000 bp。DNA 量与活跃起点数同时加倍,理想完成时间不变。前面使用的 60 亿,是更粗略的二倍体近似值,并非另一种碱基对计数规则。
从错误核苷酸到持续保留的突变
错误插入、逃过校对的错配,以及修复后仍保留的突变,是不同的计数。Fijalkowska 及其同事的综述给出了一个有用的细菌例子:初始插入错误率约为 10⁻⁵,校对后的逃逸比例约为 10⁻²,错配修复后则约为 10⁻³。相乘得到每轮每个复制碱基的错误率为 10⁻¹⁰。这些贡献都是近似值,取决于错配种类和序列,并非适用于所有聚合酶的普遍常数。
作为算术练习,仍采用前面取整的二倍体基因组 60 亿 bp。复制两条亲本链需掺入约 120 亿个新核苷酸。按 10⁻⁵ 计算,初始错误为 120,000 个;校对后按 10⁻⁷ 计算,则为 1,200 个。若最终错误率为 10⁻⁹,复制产物中错误数的期望值为 12;若为 10⁻¹⁰,则为 1.2。带小数的期望值描述多次分裂的平均值;一个细胞不可能含有零点几个改变的碱基。从 10⁻⁵ 降到 10⁻⁹ 或 10⁻¹⁰,并非全靠校对。
不要把这些示例总数解释成每次人体细胞分裂都会产生恰好这么多突变。一个错配的两条链仍含有相互冲突的指令。修复可能将其去除,也可能在后续一轮复制中,使改变后的序列在某个后代中固定下来。复制产物还会分配到子细胞中。DNA 损伤、细胞类型和不同酶的保真度,都影响观测到的突变数量。屏幕上的固定两个错误用于检验纠错顺序,而非展示突变率分布;重放并不等于对另一个细胞取样。
必须完成多少个片段?
片段长度会改变工作量,却不改变待复制的 DNA 总量。采用综述给出的细菌片段约长 1,200 nt,对于 4,600,000 bp 的环状染色体,后随链部分约需 4,600,000 ÷ 1,200,即约 3,800 个片段。为什么不把染色体长度加倍后再除?在每个复制叉,两条新合成链中只有一条是后随链。将两个复制叉合计,非连续合成的长度约为一条染色体的长度,而不是两条新链的总长。
采用取整的二倍体人类基因组 6,400,000,000 bp,片段平均长 200 nt,对应的估计值是 32,000,000 个片段。末端效应与不同区域之间的差异,使这些除法结果不能成为精确计数。即便如此,它们仍说明,引物去除和连接绝非偶尔进行的收尾工作。一个细胞在一次 S 期中就要加工数百万个接头。真核生物的短片段与核小体组织有关,而不意味着人类聚合酶只能合成 200 个核苷酸就完全失活。
展品把每个片段压缩到 14 nt,每个引物压缩到 5 nt。因此,引物在片段中所占比例远大于生物学示例。不要根据屏幕上紫色珠子的比例,估计染色体中的 RNA 量。应当观察事件顺序:引物提供起点,DNA 替换引物,连接酶封闭骨架上剩余的切口。连接酶本身不会读取模板并填补一长段缺失的 DNA。
染色体末端与 PCR 解决的是不同问题
普通的后随链循环依赖相邻片段在引物去除时提供可延伸的 3′ 端。到了线性染色体的末端,这种安排就无法继续。端粒是染色体末端的重复 DNA 及其相关保护蛋白。在端粒酶活跃的细胞中,这种酶用自身的 RNA 作模板延长 DNA 末端,随后其他复制机器便可复制互补 DNA。端粒酶不会复制整个基因组,也不是简单地把染色体两端粘在一起。这件展品的复制叉位于内部片段,因此最后的分离并不是端粒缩短的模拟。
端粒流失也不是一种能通过统计分裂次数来给出年龄的精确时钟。NHGRI 介绍了某些分裂细胞类型中的端粒缩短及重复序列补充。这些过程因细胞而异。对末端复制问题的解释,并不能证明提高端粒酶活性会是一种安全的抗衰老治疗。
PCR 在细胞外复制选定的 DNA 区域。如 NHGRI 所述,加热将模板链分开,耐热聚合酶在反复的温度循环中合成新 DNA。标准 PCR 反应中,加入的 DNA 引物确定靶区边界;并非由引物酶在移动的复制叉处不断合成 RNA 引物。加热替代了解旋酶打开双链的作用,却没有替代细胞复制机器的每一项工作。
在理想倍增假设下,从一个起始双链模板出发,20 个循环产生 2²⁰ = 1,048,576 份拷贝。这是理论倍增结果,不是保证的实验产量:试剂会成为限制因素,扩增效率也并非完美。PCR 扩增的还是选定靶区,而非自动复制细胞全部染色体。展品的「速度」控制不代表 PCR 温度循环。
亲手拉动复制叉并配对碱基
解旋酶环是整台机器的把手。沿螺旋拖动它,复制叉就精确打开到你拉动的位置:亲本链分开,结合蛋白落在裸露模板上,聚合酶跟随前进。「速度」控制随手的动作变化,因此快速拉动可使其达到最高值 20 bp/s。反向拉动则没有效果。真正的解旋酶利用 ATP 的能量,沿一条链向一个方向移动;同一起点发出的第二个复制叉负责相反方向。
「配对下一个碱基」让你充当前导链聚合酶。复制叉停下,白色珠子标出新链上下一个空位,红环标出它对面的模板碱基。四个按钮提供 A、T、G 和 C。正确选择遵循配对规则,A 配 T、G 配 C,新链便增加一个碱基对。错误选择会短暂保留;如果「校对」开启,聚合酶便后退一个位置,将其切除,再放入正确碱基,就像 3′ 至 5′ 外切核酸酶那样。如果「校对」关闭,错误碱基会保留并带有圆环,拷贝中便留下一个错配。
真正的聚合酶不是靠读字母来选择。进入的核苷酸必须在活性位点中符合正确碱基对的形状,错误配对嵌合不佳,添加速度也慢得多。即便如此,校对前每 100,000 次添加仍约有 1 次出错,因此连续选对 20 次,并不能证明复制机器可靠。配对游戏还会接管自动运行:你选择时,时钟停止,位置 24 和 54 的预设错误会被跳过。
点按舞台上的任一蛋白质或其名称标签,便可阅读其功能。卡片简要重述部件清单,因此无需离开舞台,就能认识复制叉前方的拓扑异构酶、后随链模板上的引物酶、带滑动夹的两个聚合酶、DNA 聚合酶 I,以及连接酶。
为什么复制叉越快,留下的片段越长?
引物酶不是在 DNA 的固定位置启动引物。在 E. coli 中,它从溶液中到达,与解旋酶相遇,合成一个引物后离开。Tougu 和 Marians 在 1996 年表明,这种相遇约每 1 至 2 秒发生一次,并决定了片段长度。与此同时,复制叉每秒移动约 1,000 个核苷酸。以每秒 1,000 个核苷酸、每 1 至 2 秒产生一个片段计算,片段长 1,000 至 2,000 个核苷酸,与细菌实测约 1,200 个相符。
模型保留了这一思想,但放慢了时钟。每经过 2.8 秒屏幕时间,启动一个新引物,因此片段长度等于「速度」乘以 2.8。默认 5 bp/s 时为 14 nt,84 个碱基对上有 6 个片段。在 13 bp/s 及以上时,片段长 36 nt,只能容纳 2 个;在 3 bp/s 时为 8 nt,共有 12 个。低于 3 bp/s 时,模型将最短片段保持为 7 nt,使 5 nt 的引物后仍留有合成 DNA 的空间。运行中改变「速度」,整条后随链都会重绘,仿佛复制叉始终以新速度运行。
另一条规则在任何速度下都不变:每个片段以 RNA 开始,在前一个片段处结束,每次连接都需要 DNA 聚合酶 I 和连接酶。因此,较慢的复制叉产生许多短片段,会留下更多待去除的引物和待封闭的切口。真核生物的片段较短,约 200 个核苷酸,因为它们与核小体间距相对应。人体细胞在每次 S 期都要完成数千万个这样的片段。
人体细胞复制 DNA 需要多久?
人体体细胞含有约 64 亿个碱基对,即两套各 32 亿个。一个复制叉每秒复制 50 个核苷酸,需 6,400,000,000 ÷ 50 = 1.28 亿秒,约 4 年。一个起点发出两个复制叉,可将时间减半到约 2 年。舞台下方的计算器从单一起点开始,允许你把同时启动的起点数增加到 100,000,这是 OpenStax 给出的人类基因组最高数值。
每秒 50 个核苷酸时,2,223 个起点(4,446 个复制叉)足以在 8 小时内完成;每秒 100 个核苷酸时,只需约一半,即 1,112 个。10,000 个起点以 50 nt/s 运行时,理想时间降至 107 分钟。Cooper 的细胞生物学教材指出,每 24 小时分裂一次的人体细胞,其 S 期约 8 小时;OpenStax 则给出约 10 小时。真实细胞使用的起点多于算术上所需,因为起点在 S 期轮流启动,复制叉还会在受损或紧密包装的 DNA 处停滞。
细菌只靠一个起点就足够,因为染色体短,复制叉又快。两个复制叉每秒各复制 1,000 个核苷酸,复制 E. coli 的 460 万个碱基对需 4,600,000 ÷ 2,000 = 2,300 秒,约 38 分钟,接近教材的 42 分钟。早期果蝇胚胎采取相反策略:整个细胞周期仅约 8 分钟,因此必须从密集分布的起点开始复制 DNA。
你的身体每天复制多少 DNA?
Sender 和 Milo 在 2021 年估计,成人每天更换约 3300 亿个细胞,接近 90% 是血细胞,人体细胞总量约为 30 万亿。每个新细胞都带有完整 DNA 拷贝,因此每天至少要制造同样多份基因组拷贝。一份为 64 亿个碱基对,每个碱基对长 0.34 nm,合计约 2.2 m 的 DNA。
对于 70 kg 成人,将 3300 亿份、每份 2.2 m 相乘,每天约为 7.18 亿 km 的 DNA,是地球到太阳 1.496 亿 km 距离的 4.8 倍,或相当于每秒约 8,300 km。舞台下方的计算器按你输入的体重缩放细胞数:60 kg 时,一天的复制总量约为 6.16 亿 km。这些都是粗略的模型数字。更新量因人和年龄而异,红细胞成熟时会失去细胞核,还有一些新细胞来自干细胞,后者复制 DNA 的地点与细胞最终使用的地点不同。
这个总量提醒我们,复制必须有多准确。即使最终错误率约为十亿分之一,每份基因组拷贝仍会出现少量改变,其中大多数位于不会改变蛋白质的 DNA 中。修复、细胞死亡和免疫系统会清除许多出现问题的细胞。
从沃森和克里克到复制叉时钟:简史
沃森和克里克在 1953 年双螺旋论文结尾指出,碱基配对暗示了复制机制。1956 年,阿瑟·科恩伯格的团队使用来自 E. coli 的酶,也就是 DNA 聚合酶 I,在试管中合成了 DNA;这项工作分享了 1959 年诺贝尔生理学或医学奖。1958 年,梅塞尔森和斯塔尔利用重氮同位素证明,每个新双螺旋保留一条旧链。1963 年,John Cairns 拍摄了整条正在复制的 E. coli 染色体:一个约 1 mm 长的单环,上面有移动的复制叉。
接着发现了后随链的片段。1967 年,几个实验室发现 DNA 连接酶,Martin Gellert 证明 E. coli 提取物能把 lambda DNA 的两端闭合成环。1968 年,冈崎令治、冈崎恒子及其同事对新 DNA 标记几秒,发现它先形成短片段,随后才连接起来。1969 年,Paula De Lucia 和 John Cairns 发现一种聚合酶 I 极少却仍能复制 DNA 的突变株,提示主要复制酶另有其人,即聚合酶 III。
后续工作解释了舞台上机器的其余部分。沃森在 1972 年描述线性 DNA 的末端问题,Gellert 团队在 1976 年发现 DNA 旋转酶,Greider 和 Blackburn 在 1985 年发现端粒酶。1992 年,Kuriyan 团队解析出滑动夹的结构,它是环绕 DNA 的一个环。凯利·穆利斯因 PCR 分享了 1993 年化学奖,Tougu 和 Marians 随后在 1996 年提出冈崎片段时钟,2015 年 Lindahl、Modrich 和 Sancar 因 DNA 修复共同获得化学奖。舞台下方的目录为每项发现提供一张卡片,并附原始论文。
在舞台上做哪些核对?
先在复制中途暂停,在「控制」中关闭「碱基对颜色」。找到连续的橙色前导链,再找到蓝绿色后随链片段上的紫色引物。依方向标签沿 5′ 至 3′ 追踪新链。虽然一个聚合酶朝向复制叉移动,另一个远离它工作,但新链的化学生长方向必须一致。「后随」不意味着这条链沿 3′ 至 5′ 合成。
接着保持「速度」不变,分别打开和关闭「校对」,重放同一区域。在聚合酶暂停时,比较品红色错误标记与「已复制」及「冈崎片段」读数。这能单独考察预设的校对延迟。如果两次运行之间改变速度,也会改变动画时钟,就不再是公平比较。关闭校对后重放更快,并不能证明真实细胞会从关闭修复中获益。
最后,打开「梅塞尔森和斯塔尔」,比较相继各代的试管。经过一代后的中间密度条带排除了保留复制,但本身还不能排除分散复制。第二代才提供区分:出现分开的杂合带和轻带,而非一条逐步向轻端移动的条带。氮-15 是用作密度标记的稳定同位素,不是放射性示踪剂。试管反映 DNA 密度,而非新合成碱基的颜色。动画和试管实验回答不同问题:前者说明复制叉如何工作,后者检验亲本材料怎样分配到子代分子中。
然后分别快速和缓慢拉动解旋酶,每次都让复制叉到达终点,并在「冈崎片段」读数中统计后随链片段。先在「预测片段数」中做预测。最后分别打开和关闭「校对」,手动配对碱基并比较「校对」读数:前一种情况下错误选择被撤回,后一种情况下则计入保留错误。
常见问题
DNA 聚合酶为什么不能连续构建两条链?
它只能在 3′ 端添加核苷酸,因此每条新链都沿 5′ 至 3′ 生长。两条模板方向相反,所以只有一条新链能朝着打开的复制叉生长。另一条必须分段合成,各段远离复制叉生长。
前导链与后随链有什么区别?
前导链从一个引物开始,跟随解旋酶连续合成。后随链由短的冈崎片段构成,每段各有自己的引物,随后由 DNA 连接酶连接。
引物为什么由 RNA 构成?
DNA 聚合酶不能启动新链,但作为 RNA 聚合酶的引物酶可以。短 RNA 给 DNA 聚合酶提供可延伸的 3′ 端。随后 RNA 被移除并替换为 DNA。
DNA 聚合酶多久会犯一次错?
Nature Education 给出的合成错误频率约为每 100,000 个核苷酸中有 1 个。校对修正其中约 99%,复制后的错配修复还会捕获更多。
DNA 复制有多快?
根据 OpenStax,E. coli 每个复制叉每秒约复制 1,000 个核苷酸。人体细胞方面,OpenStax 给出每秒 50 至 100 个,Nature Education 给出约 40 个。许多复制叉同时工作。
半保留是什么意思?
两个新的双螺旋中,每个都含有来自原分子的一条链,以及一条新合成的链。梅塞尔森和斯塔尔在 1958 年利用重、轻两种氮同位素证明了这一点。
染色体末端会发生什么?
在线性染色体上,后随链的最后一个引物无法被 DNA 替换,因此末端会随每次分裂略微缩短。端粒酶是一种带有自身 RNA 模板的酶,在其活跃的细胞中,会把 TTAGGG 重复序列添加到末端。
后随链的化学生长方向相反吗?
不。两条新链都沿 5′ 至 3′ 生长。非连续链以分开的片段向远离复制叉的方向生长,其合成方向并未反转。
单靠校对就能解释最终错误率吗?
不能。碱基选择、校对和错配修复分别降低错误率。细菌中约从 10⁻⁵ 降至 10⁻¹⁰ 的示例包括全部这些过程,并不是人体细胞通用的突变计数。
氮-15 有放射性吗?
没有。它是氮的稳定同位素。梅塞尔森和斯塔尔追踪的是 DNA 密度差异,而非检测放射性衰变。
PCR 与屏幕上的复制叉相同吗?
两者都使用模板和聚合酶,但标准 PCR 用加热分开双链,并用加入的 DNA 引物选定靶区。模型展示的则是解旋酶驱动的细胞内复制叉,带有 RNA 引物和后随链加工过程。
为什么有些冈崎片段比其他片段长?
其长度取决于引物酶启动新引物的频率与复制叉速度之间的关系。E. coli 中,引物酶约每 1 至 2 秒与解旋酶相遇一次,复制叉每秒移动约 1,000 个核苷酸,形成长 1,000 至 2,000 个核苷酸的片段;真核生物片段约为 200 个。舞台上,「速度」越快,片段越少、越长。
我的身体每天复制多少 DNA?
成人每天约更换 3300 亿个细胞,每个新细胞需要一份约 64 亿个碱基对、长约 2.2 m 的 DNA 拷贝。合计每天数亿千米,是地球到太阳距离的数倍。舞台下方的计算器根据你的体重给出粗略估算。
术语
- 复制叉:双螺旋正在打开和复制的 Y 形区域。
- 解旋酶:通过打断碱基对间的氢键,使两条链分开的酶。
- 拓扑异构酶:通过切开并重新封合 DNA,缓解复制叉前方过度缠绕的酶。
- 单链结合蛋白(SSB):覆盖单链 DNA,防止其重新形成螺旋的蛋白质。
- 引物酶:合成引物的 RNA 聚合酶。
- 引物:为 DNA 聚合酶提供起始 3′ 端的短 RNA 链。
- 前导链:朝向复制叉连续合成的新链。
- 后随链:远离复制叉分段合成的新链。
- 冈崎片段:后随链上的一个短片段。
- 滑动夹:将 DNA 聚合酶固定在 DNA 上的环形蛋白质(真核生物中为 PCNA)。
- DNA 连接酶:通过形成磷酸二酯键来封闭切口的酶。
- 校对:聚合酶利用其 3′ 至 5′ 外切核酸酶,去除错误添加的核苷酸。
- 半保留复制:每个新螺旋保留一条旧链的复制方式。
参考资料
OpenStax, Biology 2e, 14.2 DNA Structure and Sequencing(每个碱基对 0.34 nm,宽 2 nm,每圈 3.4 nm、10 个碱基对)。 https://openstax.org/books/biology-2e/pages/14-2-dna-structure-and-sequencing (核对日期:2026 年 10 月 16 日)
OpenStax, Biology 2e, 14.3 Basics of DNA Replication(Meselson 和 Stahl,半保留复制)。 https://openstax.org/books/biology-2e/pages/14-3-basics-of-dna-replication (核对日期:2026 年 10 月 16 日)
OpenStax, Biology 2e, 14.4 DNA Replication in Prokaryotes(解旋酶、SSB、拓扑异构酶,5 至 10 个核苷酸的引物,滑动夹,DNA pol I 和连接酶;E. coli 的 460 万个碱基对约需 42 分钟,每秒 1,000 个核苷酸)。 https://openstax.org/books/biology-2e/pages/14-4-dna-replication-in-prokaryotes (核对日期:2026 年 10 月 16 日)
OpenStax, Biology 2e, 14.5 DNA Replication in Eukaryotes(60 亿个碱基对,最多 100,000 个起点,每秒 50 至 100 个核苷酸,pol ε 与 pol δ、PCNA、RNase H、端粒酶)。 https://openstax.org/books/biology-2e/pages/14-5-dna-replication-in-eukaryotes (核对日期:2026 年 10 月 16 日)
OpenStax, Biology 2e, 14.6 DNA Repair(3′ 外切核酸酶校对,错配修复)。 https://openstax.org/books/biology-2e/pages/14-6-dna-repair (核对日期:2026 年 10 月 16 日)
Nature Education, Scitable: Major Molecular Events of DNA Replication(真核生物每秒约 40 个核苷酸,Okazaki 等,1968)。 https://www.nature.com/scitable/topicpage/major-molecular-events-of-dna-replication-413/ (核对日期:2026 年 10 月 16 日)
Balakrishnan, L. and Bambara, R. A., Okazaki fragment metabolism, Cold Spring Harbor Perspectives in Biology 5, a010173 (2013)(细菌的冈崎片段约长 1,200 个核苷酸,真核生物约 200 个)。 https://pmc.ncbi.nlm.nih.gov/articles/PMC3552508/ (核对日期:2026 年 10 月 16 日)
Nature Education, Scitable: DNA Replication and Causes of Mutation(每 100,000 个核苷酸约 1 个错误,校对修正约 99%,摆动配对)。 https://www.nature.com/scitable/topicpage/dna-replication-and-causes-of-mutation-409/ (核对日期:2026 年 10 月 16 日)
Nature Education, Scitable: Semi-Conservative DNA Replication: Meselson and Stahl(三种模型与 1958 年实验)。 https://www.nature.com/scitable/topicpage/semi-conservative-dna-replication-meselson-and-stahl-421/ (核对日期:2026 年 10 月 16 日)
Meselson, M. and Stahl, F. W., The replication of DNA in Escherichia coli, Proceedings of the National Academy of Sciences 44, 671 to 682 (1958). https://pmc.ncbi.nlm.nih.gov/articles/PMC528642/ (核对日期:2026 年 10 月 16 日)
Wang, J. C., Helical repeat of DNA in solution, Proceedings of the National Academy of Sciences 76, 200 to 203 (1979)(每圈 10.4 ± 0.1 个碱基对)。 https://pmc.ncbi.nlm.nih.gov/articles/PMC382905/ (核对日期:2026 年 10 月 16 日)
National Human Genome Research Institute, Talking Glossary: DNA Replication(一个人体细胞需数小时复制)。 https://www.genome.gov/genetics-glossary/DNA-Replication (核对日期:2026 年 10 月 16 日)
NobelPrize.org, The Nobel Prize in Physiology or Medicine 1959 (Severo Ochoa 和 Arthur Kornberg). https://www.nobelprize.org/prizes/medicine/1959/summary/ (核对日期:2026 年 10 月 16 日)
Fijalkowska, I. J., Schaaper, R. M. and Jonczyk, P., DNA replication fidelity in Escherichia coli: a multi-DNA polymerase affair, FEMS Microbiology Reviews 36, 1105 to 1121 (2012)(插入、校对和错配修复依次产生的贡献)。 https://pmc.ncbi.nlm.nih.gov/articles/PMC3391330/ (核对日期:2026 年 10 月 22 日)
National Human Genome Research Institute, Telomere(染色体末端保护,某些细胞中的缩短与端粒酶)。 https://www.genome.gov/genetics-glossary/Telomere (核对日期:2026 年 10 月 22 日)
National Human Genome Research Institute, Polymerase Chain Reaction Fact Sheet(热分离、Taq 聚合酶与反复复制循环)。 https://www.genome.gov/about-genomics/fact-sheets/Polymerase-Chain-Reaction-Fact-Sheet (核对日期:2026 年 10 月 22 日)
Tougu, K. and Marians, K. J., The interaction between helicase and primase sets the replication fork clock, Journal of Biological Chemistry 271, 21398 to 21405 (1996)(E. coli 每 1 至 2 秒产生一个冈崎片段)。 https://doi.org/10.1074/jbc.271.35.21398 (核对日期:2026 年 10 月 27 日)
Sender, R. and Milo, R., The distribution of cellular turnover in the human body, Nature Medicine 27, 45 to 48 (2021)(每天约更换 3300 亿个细胞,近 90% 为血细胞)。 https://doi.org/10.1038/s41591-020-01182-9 (核对日期:2026 年 10 月 27 日)
Sender, R., Fuchs, S. and Milo, R., Revised estimates for the number of human and bacteria cells in the body, PLoS Biology 14, e1002533 (2016)(70 kg 参考男性约有 30 万亿个人体细胞)。 https://doi.org/10.1371/journal.pbio.1002533 (核对日期:2026 年 10 月 27 日)
Cooper, G. M., The Cell: A Molecular Approach, 第 2 版, The Eukaryotic Cell Cycle(24 小时人体细胞周期中的 S 期约为 8 小时)。 https://www.ncbi.nlm.nih.gov/books/NBK9876/ (核对日期:2026 年 10 月 27 日)
OpenStax, Biology 2e, 10.3 Control of the Cell Cycle(快速分裂的人体细胞 S 期约 10 小时,果蝇胚胎细胞周期约 8 分钟)。 https://openstax.org/books/biology-2e/pages/10-3-control-of-the-cell-cycle (核对日期:2026 年 10 月 27 日)
Watson, J. D. and Crick, F. H. C., Molecular structure of nucleic acids, Nature 171, 737 to 738 (1953). https://www.nature.com/articles/171737a0 (核对日期:2026 年 10 月 27 日)
Cairns, J., The bacterial chromosome and its manner of replication as seen by autoradiography, Journal of Molecular Biology 6, 208 to 213 (1963). https://doi.org/10.1016/S0022-2836(63)80070-4 (核对日期:2026 年 10 月 27 日)
Gellert, M., Formation of covalent circles of lambda DNA by E. coli extracts, Proceedings of the National Academy of Sciences 57, 148 to 155 (1967). https://doi.org/10.1073/pnas.57.1.148 (核对日期:2026 年 10 月 27 日)
Okazaki, R. and colleagues, Mechanism of DNA chain growth, I, Proceedings of the National Academy of Sciences 59, 598 to 605 (1968). https://doi.org/10.1073/pnas.59.2.598 (核对日期:2026 年 10 月 27 日)
De Lucia, P. and Cairns, J., Isolation of an E. coli strain with a mutation affecting DNA polymerase, Nature 224, 1164 to 1166 (1969). https://doi.org/10.1038/2241164a0 (核对日期:2026 年 10 月 27 日)
Watson, J. D., Origin of concatemeric T7 DNA, Nature New Biology 239, 197 to 201 (1972). https://doi.org/10.1038/newbio239197a0 (核对日期:2026 年 10 月 27 日)
Gellert, M., Mizuuchi, K., O'Dea, M. H. and Nash, H. A., DNA gyrase: an enzyme that introduces superhelical turns into DNA, Proceedings of the National Academy of Sciences 73, 3872 to 3876 (1976). https://doi.org/10.1073/pnas.73.11.3872 (核对日期:2026 年 10 月 27 日)
Greider, C. W. and Blackburn, E. H., Identification of a specific telomere terminal transferase activity in Tetrahymena extracts, Cell 43, 405 to 413 (1985). https://doi.org/10.1016/0092-8674(85)90170-9 (核对日期:2026 年 10 月 27 日)
Kong, X.-P., Onrust, R., O'Donnell, M. and Kuriyan, J., Three-dimensional structure of the beta subunit of E. coli DNA polymerase III holoenzyme: a sliding DNA clamp, Cell 69, 425 to 437 (1992). https://doi.org/10.1016/0092-8674(92)90445-I (核对日期:2026 年 10 月 27 日)
NobelPrize.org, The Nobel Prize in Chemistry 1993 (Kary B. Mullis,PCR)和 2015(Lindahl、Modrich 和 Sancar,DNA 修复). https://www.nobelprize.org/prizes/chemistry/2015/summary/ (核对日期:2026 年 10 月 27 日)
解说文章与模拟采用 CC BY-NC-SA 4.0 许可,另有说明的除外。
路线 7 / 8
从心跳到 DNA更多展品

CRISPR-Cas9:基因编辑怎样工作
向导 RNA 只读取 DNA 的 20 个字母,这通常就足以在人类基因组的 30 亿个碱基对中选出一个位置。

ATP 合酶如何工作:可转动的三维模型
在线粒体中,ATP 合酶转子每秒约转 100 圈,每转一整圈就释放三个 ATP 分子。
走进细胞:动物细胞、植物细胞和细菌
放大一百万倍后,一个线粒体差不多有沙发那么大,一整个大肠杆菌长 2 m,拖着囊泡从你身边经过的驱动蛋白每秒走 0.8 米。
神经信号如何传播
神经细胞保持在约 −70 mV,刺激将其抬升至约 −55 mV 时,就会发出大小始终相同的尖峰。

巨杉为什么能长这么大:走近谢尔曼将军树与海岸红杉林
站在高 83.8 m、约 2,200 岁的谢尔曼将军树脚下,再攀上树干,观察高处的水承受多强的拉力。

恐龙大小对比:172 种真实大小的史前动物
一座 600 m 宽的园区,按时代排列 172 种按真实大小呈现的史前动物,从第一批恐龙到霸王龙。