FIG. 18Pas à pas
Systèmes d’écriture du monde : le hangeul et 22 autres
Le livre de 1446 présentant le hangeul dit que ㄱ dessine la racine de la langue fermant la gorge. Le hangeul côtoie ici 22 autres écritures, des coins d’argile au braille.
Cet appareil ne peut pas afficher le modèle 3D. Les étapes de la visite ci-dessous se lisent sous forme de texte.
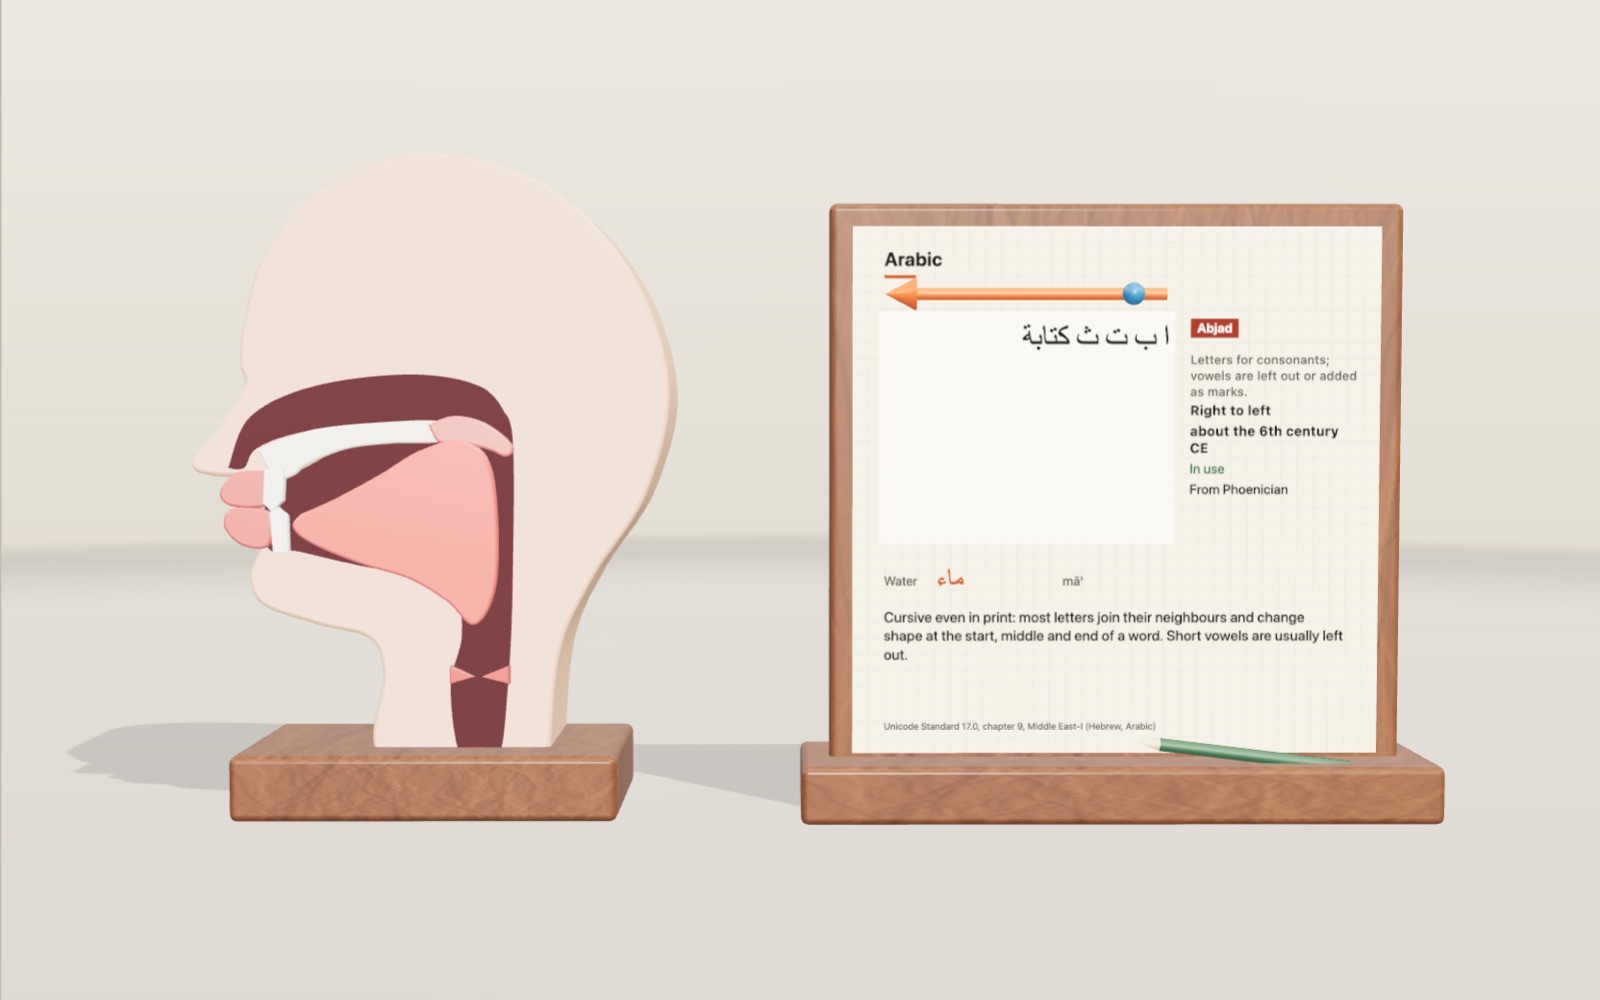
1 / 19 Une coupe de tête et un tableau d’écritureÀ gauche se trouve une tête coupée en son milieu ; à droite, un tableau pour écrire. La langue, les lèvres et le voile du palais bougent pour chaque consonne, et la lettre elle-même apparaît en orange sur la coupe.
Faites glisser pour tourner. Molette ou pincement pour zoomer.
Ce que montre le modèle
Prononcez lentement le mot coréen qui signifie rivière, gang. Au début, l’arrière de votre langue appuie contre le palais et retient l’air un instant. La lettre qui note ce son est ㄱ et, selon le livre qui présenta l’alphabet en 1446, sa forme représente exactement ce mouvement.
À gauche de la scène se trouve une tête coupée en son milieu, comme dans un atlas d’anatomie : les lèvres, les dents de devant, le palais dur osseux, le voile du palais suspendu derrière lui, la langue et la gorge jusqu’aux plis vocaux. Choisissez une des cinq consonnes de base : la langue, les lèvres et le voile du palais prennent la position correspondant à ce son, tandis que la lettre elle-même apparaît sur la coupe sous la forme d’un tube orange. Activez Flux d’air pour voir où passe le souffle : bloqué derrière la langue pour ㄱ, sortant par le nez pour ㄴ et ㅁ, comprimé dans un passage étroit pour ㅅ.
À droite se trouve un tableau d’écriture de douze pages. Six suivent le hangeul : les cinq lettres de base, les lettres obtenues par ajout de traits, les voyelles, un assembleur de syllabes, l’ordre des traits avec un exercice de tracé, et une table de majuscules grecques et cyrilliques. Six autres élargissent la comparaison à d’autres écritures : une fiche pour chacun de 23 systèmes d’écriture, le mot désignant l’eau dans 22 d’entre eux, votre nom dans 13, les kana à côté des kanji dont ils proviennent, des caractères chinois à trois époques et cinq supports d’écriture montrés en 3D à la place de la tête. Les lettres hangeul, grecques et cyrilliques, les kanji et les kana que vous pouvez repasser ne sont pas composés avec une police. Chacun est dessiné à partir d’une liste de traits enregistrés sous forme de coordonnées, dans l’ordre et le sens qu’une main suivrait pour les écrire, ce qui permet aussi au tableau de vérifier vos propres traits. Les autres écritures utilisent des caractères typographiques, avec de petits fichiers de polices pour les plus rares.
Cinq lettres dessinées d’après la bouche
L’alphabet grec a été adapté de l’alphabet phénicien, et le latin est issu du grec : les formes de leurs lettres ont donc été héritées et transformées sur une longue période. Avec le hangeul, le raisonnement nous est parvenu sur papier. Le livre s’appelle Hunminjeongeum, « les sons corrects pour l’instruction du peuple », et l’exemplaire accompagné du commentaire complet, le Haerye, explique comment chaque lettre a été créée.
Les consonnes ont pour point de départ cinq formes de base, chacune représentant l’organe qui joue le rôle principal dans la production du son. L’Institut national de la langue coréenne les résume ainsi :
| Lettre | Groupe en 1446 | Ce que représente la forme |
|---|---|---|
| ㄱ | son molaire | l’arrière de la langue touchant le voile du palais |
| ㄴ | son lingual | la pointe de la langue touchant la gencive juste derrière les dents supérieures |
| ㅁ | son labial | les deux lèvres fermées |
| ㅅ | son dental | une dent |
| ㅇ | son guttural | la gorge |
La formulation originale pour ㄱ est 象舌根閉喉之形, « elle reproduit la forme de la racine de la langue fermant la gorge ». Orientez le visage vers la gauche, comme dans le modèle, et la correspondance devient facile à voir. La langue longe le palais vers l’arrière, puis descend dans le fond : une ligne horizontale qui se replie vers le bas, soit ㄱ. Pour ㄴ, la pointe de la langue se dresse contre la gencive à l’avant, tandis que le corps de la langue se prolonge vers l’arrière : une ligne verticale qui tourne à droite.
ㅁ est la bouche fermée vue de face, un carré. ㅅ est une dent pointue. ㅇ est la gorge ouverte, un cercle, et c’est aussi la seule lettre de base qui, aujourd’hui, ne représente aucun son en début de syllabe. Dans 우유 (lait), les deux lettres ㅇ servent seulement à occuper la position initiale.
Ajouter des traits pour des sons plus forts
Cinq lettres ne suffisent pas pour pouvoir écrire une langue entière : les autres ont donc été construites à partir d’elles. La règle est simple : un son produit au même endroit, mais plus fortement, reçoit un trait supplémentaire. ㄴ devient ㄷ, et ㄷ devient ㅌ. ㅁ donne ㅂ puis ㅍ, ㅅ donne ㅈ puis ㅊ, ㅇ donne ㆆ puis ㅎ. Le groupe molaire ne comporte qu’une étape, de ㄱ à ㅋ.
Sur la deuxième page du tableau, chaque ligne montre une de ces familles, les nouveaux traits étant dessinés en orange. Lancez la commande Lecture et les différentes lignes se succèdent, chaque lettre se dessinant après la précédente.
Trois lettres ne suivent pas ce schéma. ㆁ (une nasale vélaire, aujourd’hui notée par un simple ㅇ en fin de syllabe), ㄹ et ㅿ ont reçu leurs propres formes plutôt qu’un trait supplémentaire. Le livre de 1446 les appelle lettres de forme différente.
Le système peut aussi se développer d’une seconde manière. Écrire deux fois une lettre simple côte à côte donne les consonnes tendues ㄲ, ㄸ, ㅃ, ㅆ et ㅉ. L’Institut national de la langue coréenne souligne que l’opposition à trois termes entre sons simples, aspirés et tendus (ㄱ, ㅋ, ㄲ) se reflète directement dans les formes : un trait supplémentaire pour l’aspiration, une lettre doublée pour la tension.
Des voyelles issues du ciel, de la terre et de l’être humain
Les voyelles reposent sur une autre idée. Trois lettres de base représentent les trois éléments de la philosophie d’Asie orientale : un point rond · pour le ciel, une ligne horizontale ㅡ pour la terre et une ligne verticale ㅣ pour une personne debout entre les deux.
Toutes les autres voyelles de base sont des combinaisons. Placez le point au-dessus de ㅡ et vous obtenez ㅗ ; au-dessous, ㅜ. Placez-le à droite de ㅣ et vous obtenez ㅏ ; à gauche, ㅓ. Deux points au lieu d’un donnent ㅛ, ㅠ, ㅑ et ㅕ, les mêmes voyelles précédées d’un bref son y. Dans l’impression de 1446, le point était réellement rond. Avec le temps, il est devenu le petit trait que nous écrivons aujourd’hui, et la page des voyelles montre les deux formes l’une au-dessus de l’autre.
Des voyelles plus longues se construisent en réunissant à nouveau des lettres : ㅗ avec ㅏ donne ㅘ, ㅜ avec ㅓ donne ㅝ. ㅐ et ㅔ étaient elles aussi des voyelles à deux éléments lors de la création de l’alphabet, ce qui explique qu’elles ressemblent à ㅏ et ㅓ avec un ㅣ supplémentaire. La voyelle en forme de point n’est plus utilisée, car le son qu’elle notait a disparu de la langue.
Comment les lettres s’assemblent en une syllabe
Un alphabet place habituellement les lettres en ligne. Le hangeul possède des lettres distinctes pour les consonnes et les voyelles, mais les écrit dans des blocs, un par syllabe. Le mot désignant l’abeille, kkulbeol, ne s’écrit pas ㄲㅜㄹㅂㅓㄹ sur une ligne, mais sous la forme des deux blocs 꿀벌.
Un bloc comporte jusqu’à trois positions : la consonne initiale, la voyelle et la consonne finale. La place de chacune dépend de la voyelle. Avec une voyelle verticale comme ㅏ, l’initiale se place à sa gauche ; avec une voyelle horizontale comme ㅗ, elle se place au-dessus ; avec une voyelle combinée comme ㅘ, elle se loge dans l’angle. La finale va toujours en dessous. Sur la page des syllabes, les trois positions sont délimitées par trois couleurs, et chaque choix redessine le bloc.
Les nombres, calculs à l’appui
L’orthographe moderne utilise 19 consonnes initiales, 21 voyelles et 27 finales, dont 16 sont des lettres simples et 11 des groupes comme ㄺ. En comptant « aucune finale » comme un choix, on obtient 28 possibilités pour la dernière position.
La norme Unicode encode chaque bloc possible comme un caractère à part entière et les range dans un ordre fixe : le code de n’importe quelle syllabe peut donc se calculer :
code = 0xAC00 + (initiale × 21 + voyelle) × 28 + finale
Pour 한, l’initiale ㅎ porte le numéro 18, la voyelle ㅏ le numéro 0 et la finale ㄴ le numéro 4. Le code est donc 44 032 + (18 × 21 + 0) × 28 + 4 = 54 620, noté U+D55C. Le même calcul donne le total : 19 × 21 × 28 = 11 172 syllabes. Le tableau montre cette somme pour tout bloc que vous construisez, et l’affichage dans l’angle montre le caractère que votre ordinateur trouve à ce numéro.
L’ordre des traits et la vérification du tableau
Le hangeul s’écrit de haut en bas et de gauche à droite, un trait à la fois. L’ordre utilisé sur le tableau suit cette règle générale : dans ㄹ, le crochet supérieur vient d’abord, puis la barre centrale, puis l’angle inférieur ; dans 한, les lettres suivent l’ordre initiale, voyelle, finale. Les supports pédagogiques diffèrent pour quelques lettres (ㅈ est parfois enseigné en deux traits, parfois en trois) : considérez donc l’ordre présenté ici comme une version courante.
Quand vous dessinez sur le tableau, le trait que vous venez de tracer est rééchantillonné en 32 points régulièrement espacés sur sa longueur, tout comme le trait attendu par le tableau. Celui-ci calcule ensuite la distance moyenne entre les points correspondants. Si elle est inférieure à 7,5 % de la largeur du carré d’écriture (6 % pour une syllabe entière), le trait est accepté. Si votre trait ne correspond que lorsqu’un des deux est inversé, vous l’avez tracé dans le mauvais sens. S’il correspond mieux à un trait ultérieur qu’au trait en cours, vous avez sauté une étape. Pour le cercle de ㅇ, le tableau essaie aussi tous les points de départ, afin de distinguer un cercle commencé au mauvais endroit d’un cercle tracé dans le mauvais sens. Les traits refusés clignotent en rouge puis s’effacent, et l’affichage vous indique laquelle de ces erreurs s’est produite.
Le grec et le cyrillique côte à côte
La dernière page place douze majuscules grecques à côté des lettres cyrilliques utilisées pour les mêmes sons. La norme Unicode décrit le cyrillique comme une écriture développée au neuvième siècle à partir du grec, et de nombreuses paires partagent encore une forme : Α et А, Γ et Г, Π et П, Φ et Ф. D’autres se sont éloignées. Δ est devenu Д avec des pieds, Λ est devenu Л, et le son de Σ s’écrit С. Quelques paires se ressemblent mais se lisent autrement qu’en lettres latines, comme Ρ et Р, qui valent tous deux un r.
Chaque paire se dessine trait par trait, d’abord le grec en bleu, puis le cyrillique en rouge. Les majuscules grecques et cyrilliques n’ont pas d’ordre des traits officiel unique : l’ordre retenu ici est simplement naturel pour une personne qui écrit de la main droite.
Ce que le modèle ne montre pas
La tête est un schéma, pas une image issue d’un scanner. Le contour de la langue possède treize points de contrôle et passe entre cinq formes fixes, tandis qu’une vraie langue change continuellement de forme. Le voile du palais pivote autour d’une seule charnière, et la gorge ne montre que l’épiglotte et les plis vocaux.
La correspondance entre la lettre et l’organe est l’explication de 1446, pas une mesure. Pour ㄱ, le livre parle de « racine de la langue », alors que les descriptions modernes évoquent généralement l’arrière de la langue contre le voile du palais ; le modèle montre cette seconde version. Les chercheurs notent aussi que certaines lettres, comme ㅂ et ㅍ, s’expliquent difficilement par le seul ajout de traits. Les lettres du tableau sont dessinées dans un style simple, d’épaisseur constante, pour que les traits soient faciles à suivre. L’écriture manuscrite et celle au pinceau présentent des courbes et des amincissements que ce style ne montre pas.
Une brève histoire
Le roi Sejong acheva la création des 28 lettres au cours de l’hiver 1443. Le Hunminjeongeum Haerye fut imprimé à partir de planches de bois au neuvième mois lunaire de 1446. Il comporte 33 feuillets : quatre du texte du roi lui-même, avec sa préface et le son de chaque lettre, et 29 de commentaires écrits par huit lettrés de l’Académie des sages, sous la direction de Jeong In-ji. Le commentaire est divisé en sections sur la création des lettres, les initiales, les voyelles et les finales, l’assemblage des lettres et des exemples d’utilisation.
Un exemplaire fut retrouvé en 1940 dans une maison familiale d’Andong. Il fut classé Trésor national le 20 décembre 1962 et est conservé au musée d’art Kansong à Séoul. Il fut inscrit au registre Mémoire du monde de l’UNESCO en octobre 1997. Sur les 28 lettres d’origine, quatre ne sont plus utilisées dans l’orthographe standard : la voyelle en point, ㆆ, ㆁ et ㅿ. Il reste ainsi les 24 lettres de base enseignées aujourd’hui.
Vingt-trois écritures classées selon leur fonctionnement
Appuyez sur 23 écritures et le tableau devient une fiche comparative. La liste va du cunéiforme, imprimé dans l’argile à Uruk vers 3200 avant notre ère, au braille, publié à Paris en 1829. Chaque fiche donne le type d’écriture, son sens d’écriture, la date la plus ancienne indiquée par sa source, son éventuel usage quotidien actuel, l’écriture dont elle est issue lorsque celle-ci est connue, un exemple, le mot désignant l’eau et une courte description. La barre sous les commandes change d’écriture une étape à la fois, et le répertoire sous la scène présente les 23 avec des filtres.
Le badge coloré indique le type, première chose à regarder, car il vous dit ce que représente un signe isolé.
Un alphabet possède des lettres distinctes pour les consonnes et les voyelles. Le grec fut la première écriture de la liste à le faire ; le latin, le cyrillique, l’arménien et le géorgien ont suivi la même idée, ainsi que les runes. Un abjad note les consonnes et omet la plupart des voyelles. Le phénicien possédait 22 lettres consonantiques et rien d’autre. L’hébreu et l’arabe fonctionnent encore ainsi : le lecteur restitue les voyelles grâce à sa connaissance de la langue, et des points ou de petites marques peuvent être ajoutés pour les enfants, les textes sacrés ou les mots inhabituels. La norme Unicode le dit clairement pour l’hébreu : les points-voyelles sont généralement omis, sauf dans les textes liturgiques.
Un abugida donne à chaque lettre consonantique une voyelle inhérente qu’une marque permet de modifier. En dévanagari, क vaut ka ; ajoutez le signe ि et il devient कि, ki ; ajoutez le virama et la voyelle disparaît. Le thaï, le tibétain et le bengali appartiennent à la même famille brahmi et fonctionnent globalement de la même manière. L’éthiopien est un abugida d’un autre aspect : chaque consonne possède sept formes, une par ordre vocalique, et les traits et boucles supplémentaires s’attachent au signe de base. ለ, ሉ, ሊ, ላ se lisent le, lu, li, la.
Un syllabaire possède un signe par syllabe, sans parties visibles. Les kana japonais et le cherokee de Sequoyah sont les deux exemples de cette exposition. Le cherokee compte aujourd’hui 85 signes ; la première version en avait 86. Les kana possèdent 46 signes de base dans chacun de leurs deux ensembles.
Une écriture logosyllabique mêle des signes pour des mots entiers et des signes pour des sons. Le cunéiforme, les hiéroglyphes égyptiens, les caractères chinois et le maya appartiennent tous à ce groupe, ce qui explique aussi leurs centaines ou milliers de signes. De nombreux caractères chinois combinent une partie qui suggère le sens et une autre qui suggère le son.
Le hangeul reçoit sa propre étiquette, alphabet à traits, car ses formes notent comment le son est produit : la position de la langue ou des lèvres dans les cinq consonnes de base, un trait supplémentaire pour un son plus fort et le point, l’horizontale et la verticale pour les voyelles. Le braille est classé comme code à points. Six points en relief répartis en deux colonnes donnent 64 configurations, et la norme Unicode précise qu’aucune n’a de sens fixe : chaque langue attribue le sien.
Le sens suivi par la ligne
La plupart des écritures du tableau vont de gauche à droite, mais pas toutes. Lorsque la fiche comparative est ouverte, une flèche orange se trouve devant le tableau, et une bille bleue la parcourt dans le sens de l’écriture.
Le phénicien, l’hébreu et l’arabe vont de droite à gauche. L’arabe ajoute une seconde difficulté : il est cursif même à l’impression ; la plupart des lettres se lient donc à la suivante, et une lettre prend des formes différentes au début, au milieu et à la fin d’un mot. Les hiéroglyphes égyptiens pouvaient suivre l’un ou l’autre sens, et les signes représentant des personnes, des oiseaux et des animaux regardent le début de la ligne. Le lecteur rencontre les signes face à face. Sur le tableau, la ligne de hiéroglyphes va de droite à gauche : chaque signe est donc dessiné en miroir pour regarder vers la droite. Activez Autre sens et la ligne va de gauche à droite ; les signes se retournent pour regarder le nouveau début.
Le mongol va de haut en bas, et les colonnes se succèdent de gauche à droite. C’est inhabituel ; les livres chinois, japonais et coréens composés verticalement alignent leurs colonnes de droite à gauche. Avec un texte vertical, la flèche pointe vers le bas, et une seconde flèche courte sous l’exemple montre le sens de succession des colonnes. Le tableau dessine le mongol comme les moteurs typographiques : la ligne est mise en forme horizontalement puis tournée d’un quart de tour dans le sens horaire, ce qui correspond à l’utilisation prévue des polices mongoles.
Autre sens fonctionne pour toutes les écritures. Aucune de ces écritures ne s’écrit réellement ainsi. Cette option sert à montrer ce qui change. Le latin composé de droite à gauche reste lisible, mais chaque mot paraît incorrect ; l’arabe composé lettre par lettre dans l’autre sens perd ses liaisons, ce qui montre combien sa forme réside dans les connexions entre lettres plutôt que dans les lettres elles-mêmes.
Le même mot dans 22 écritures
Un mot place côte à côte le mot désignant l’eau dans 22 écritures, chacune dans la principale langue qu’elle note aujourd’hui ou notait lorsqu’elle était utilisée, avec une translittération latine en dessous. L’anglais water côtoie le russe вода, le hindi पानी, le thaï น้ำ, l’amharique ውሃ et le cherokee ᎠᎹ. Le cunéiforme note le sumérien a avec un seul signe, 𒀀. Le hiéroglyphe se compose de trois lignes ondulées représentant l’eau. Le braille écrit water en cinq cellules.
Vues ensemble, les 22 cases montrent les types d’un coup d’œil. Les écritures logosyllabiques n’ont besoin que d’un ou deux signes pour le mot entier. Les alphabets ont besoin de quatre ou cinq lettres. Les abjads écrivent m-y-m en phénicien et en hébreu sans les voyelles. Le maya est absent de cette page parce que ses signes ne sont pas encore dans Unicode ; sa fiche montre à la place les chiffres mayas, qui sont encodés : un point vaut un, une barre vaut cinq et une coquille vaut zéro.
Écrire votre nom dans d’autres écritures
Votre nom retranscrit un nom dans 13 écritures. Saisissez-le en lettres latines ou en hangeul. L’outil transforme d’abord le nom en une courte liste de sons. Le hangeul est romanisé lettre par lettre avec la table de romanisation révisée : 마주환 devient ainsi majuhwan. Les lettres latines sont lues à l’aide d’une petite table de digrammes : sh, ch, th, ph, ng, ee, oo et quelques autres. Chaque écriture note ensuite ces sons à sa manière.
La manière de les noter montre le type de l’écriture. Les katakana et l’éthiopien ont besoin d’un signe pour chaque combinaison consonne-voyelle : Maria donne donc マリア en katakana et ማሪያ en éthiopien. Le dévanagari écrit la consonne avec un signe vocalique, मारिया, et utilise le virama sur une consonne sans voyelle. L’arabe et l’hébreu écrivent les consonnes et utilisent les lettres de voyelles longues pour les voyelles, manière habituelle de noter les noms étrangers dans ces écritures, et l’hébreu passe aux formes finales ם, ן, ף, ץ à la fin d’un mot. Le grec et le cyrillique procèdent presque lettre pour lettre. Le braille note les lettres latines avec un signe de majuscule devant.
Le tableau le précise clairement : il s’agit d’une retranscription issue d’une table de règles, et les orthographes réelles diffèrent souvent. Un nom coréen romanisé sans les règles de changement phonétique peut paraître étrange ; Kim peut être écrit Gim selon la table officielle. Les noms ont dans chaque pays des orthographes usuelles qu’aucune table ne permet de prévoir. L’outil sert à montrer comment fonctionnent les écritures, pas à produire un nom pour un passeport.
Les kana issus des kanji et l’évolution des caractères chinois
Kana issus des kanji montre 15 kana à côté des caractères chinois dont ils proviennent. Les hiragana sont issus de formes cursives de caractères entiers : あ vient de 安, い de 以, か de 加. Les katakana ont repris une partie d’un caractère : ア est le côté gauche de 阿, イ le côté gauche de 伊, エ est 江 sans son radical de l’eau. Les paires suivent la table d’un article de l’université du Kansai qui cite le dictionnaire illustré des origines des kana de Morioka. Une des tâches ci-dessous vous demande d’en associer six.
Évolution des han dessine six caractères à trois étapes : la forme sur les os oraculaires des Shang, d’environ 1300 à 1050 avant notre ère, la forme du petit sceau et l’écriture régulière. Le soleil commence comme un cercle avec une marque à l’intérieur et finit comme un rectangle traversé d’une barre. L’eau commence comme une rivière sinueuse avec des gouttes de chaque côté ; dans l’écriture régulière, la rivière est le trait central à crochet, et les gouttes sont devenues les traits latéraux. Les dessins d’os oraculaires et de sceaux sont des versions simplifiées créées pour ce modèle : ils montrent donc l’idée de chaque forme plutôt qu’une inscription particulière.
L’ordre des traits au pinceau
La page de l’ordre des traits possède désormais une seconde rangée : huit caractères chinois et douze kana. Un pinceau suit la plume pendant l’animation de l’ordre, et Revenir sur les traits permet de parcourir les traits manuellement, en avant et en arrière. 水 possède quatre traits : le milieu à crochet, la partie gauche, le petit trait en haut à droite et le long mouvement vers le bas à droite. 木 commence par la barre, puis la verticale, puis les deux traits descendants. Dans 山, le milieu vient d’abord, puis le côté gauche et le bas en un seul trait, puis le côté droit.
Vous pouvez repasser chacun d’eux sur le tableau. Le même test de correspondance que pour le hangeul décide si chaque trait est au bon endroit, dans le bon sens et dans le bon ordre. Désactivez Pinceau pour voir les traits avec l’épaisseur uniforme de la plume.
Les supports sur lesquels on écrivait
Supports remplace la tête par cinq objets, un à la fois, et le tableau explique chacun.
La tablette d’argile est le support le plus ancien. Le cunéiforme a commencé comme comptabilité des rations de pain et de bière dans des villes comme Uruk, et le British Museum indique qu’il fut utilisé pendant plus de 3000 ans. Un scribe enfonçait l’extrémité d’un roseau taillé dans l’argile humide ; chaque pression laisse un coin, ce qui explique que les signes soient des groupes de coins et que le cunéiforme comporte si peu de courbes. La tablette du modèle possède sept lignes réglées de groupes de coins et un roseau à côté.
Le rouleau de papyrus vient d’Égypte. Des bandes de tige de papyrus étaient disposées en deux couches perpendiculaires, pressées et séchées, puis les feuilles étaient collées pour former un rouleau. Le modèle montre une feuille portant des colonnes de hiéroglyphes à l’encre noire et rouge, avec le reste du rouleau sur le côté.
Les lamelles de bambou portaient l’écriture chinoise bien avant le papier. Le texte était écrit de haut en bas sur des bandes étroites, puis celles-ci étaient attachées côte à côte avec une corde. La collection de lamelles des Royaumes combattants de l’université Tsinghua, de 475 à 221 avant notre ère, contient plus de 70 textes, dont plus de 60 avaient été perdus pendant plus de 2000 ans. Les colonnes verticales allant de droite à gauche, ancien sens des livres chinois, découlent naturellement d’un faisceau de lamelles.
Le codex de parchemin est une peau animale pliée en pages et reliée au dos. Le Codex Sinaiticus, une Bible grecque écrite au quatrième siècle, est un des plus anciens exemples conservés ; la British Library le catalogue comme un codex de parchemin. Son texte est en majuscules sans espaces entre les mots, comme le montrent les pages du modèle.
Les caractères métalliques mobiles viennent en dernier. Chaque caractère est fondu sur un bloc de métal ; les blocs sont assemblés dans un cadre, encrés et pressés sur le papier. Sur le caractère lui-même, chaque signe est inversé en miroir, et le modèle montre les faces retournées. L’UNESCO indique que le Jikji fut imprimé avec des caractères métalliques mobiles au temple Heungdeok-sa de Cheongju en juillet 1377 ; son second volume est conservé à la Bibliothèque nationale de France.
Quand un pays change d’écriture
La liste des événements sous la scène comporte plusieurs changements d’écriture. Le 1er novembre 1928, la Türkiye adopta la loi 1353, qui remplaça l’écriture arabe par des lettres latines pour le turc ; le Journal officiel la publia le 3 novembre. L’indonésien et le malais, autrefois notés en écriture arabe, utilisent désormais des lettres latines, et l’azerbaïdjanais est passé du cyrillique à un alphabet latin fondé sur le turc. Le vietnamien s’écrit dans un alphabet latin comportant de nombreux signes diacritiques, le chữ Quốc ngữ, dont l’orthographe est issue des travaux des missionnaires ; le dictionnaire d’Alexandre de Rhodes imprimé à Rome en 1651 l’utilisait.
D’autres changements ont conservé l’écriture tout en la réduisant. La table japonaise des jōyō kanji de 2010 répertorie 2136 caractères d’usage général, et les quatre lettres hangeul abandonnées dans l’orthographe moderne ont laissé les 24 lettres de base enseignées aujourd’hui. De nouvelles écritures apparaissent encore : Sequoyah acheva le syllabaire cherokee en 1821 et, quelques années plus tard, le Conseil cherokee l’utilisait pour le journal bilingue Cherokee Phoenix. James Evans conçut des syllabaires pour les langues algonquiennes à la fin des années 1830, et les locuteurs de l’inuktitut les utilisent aujourd’hui.
Réunir toutes les écritures dans une seule norme
Chaque lettre des 23 fiches, sauf le maya, est un caractère Unicode. Unicode 17.0, publié le 9 septembre 2025, contient 159 801 caractères. Son nouveau bloc CJK Extension J a ajouté 4298 idéogrammes et porté le nombre de caractères han encodés au-delà de 100 000. Les syllabes hangeul sont un cas particulier : plutôt que d’énumérer 11 172 blocs un par un, Unicode les place dans un ordre qu’une formule reproduit, et la page des syllabes montre cette formule en action.
Les écritures avec des règles de mise en forme exigent plus qu’une liste de caractères. Les lettres arabes doivent se lier, les consonnes dévanagari doivent se combiner avec les signes vocaliques et entre elles, les lettres mongoles changent selon leur position et les signes vocaliques thaïs se placent au-dessus, au-dessous, avant ou après leur consonne. Le tableau confie ce travail au moteur de texte du navigateur. Pour les écritures rares absentes de la plupart des appareils, l’exposition charge de petits sous-ensembles des polices Noto sous licence SIL Open Font License, environ 116 KB au total, contenant seulement les caractères dessinés ici.
À vous d’essayer
Sept tâches se trouvent sous les commandes. Choisissez, dans une liste, les trois écritures qui vont de droite à gauche. Déterminez laquelle de quatre écritures note seulement les consonnes. Construisez 닭, poulet, dans l’assembleur de syllabes ; sa finale est la consonne double ㄺ, et le calcul Unicode donne U+B2ED. Associez six kana aux kanji dont ils proviennent. Choisissez la plus ancienne de cinq écritures. Repassez 水 dans l’ordre des traits. Saisissez un nom de deux syllabes ou plus et lisez sa graphie éthiopienne. Les tâches terminées conservent leur coche sur votre appareil.
Questions
Pourquoi ㄱ ressemble-t-il à l’arrière de la langue ?
Le commentaire de 1446 dit que ㄱ reproduit la forme de la racine de la langue fermant la gorge. Vue de côté, le visage tourné à gauche, la langue longe le dessous du palais vers l’arrière puis descend au fond, ce qui correspond à l’horizontale et à la verticale de ㄱ.
ㅇ est-il muet ?
Au début d’une syllabe, oui. Il occupe seulement la position initiale, comme dans 우유. À la fin d’une syllabe, il se prononce comme une nasale, comme à la fin de gang. En 1446, cette nasale avait sa propre lettre, ㆁ, qui a ensuite fusionné avec ㅇ.
Combien de syllabes le hangeul peut-il écrire ?
Unicode encode 19 × 21 × 28 = 11 172 blocs syllabiques précomposés. La plupart n’apparaissent jamais dans de vrais mots, mais chacun peut être construit sur le tableau.
Que sont devenues les quatre lettres qui ne sont plus utilisées ?
La voyelle en point est tombée en désuétude parce que le son qu’elle notait a disparu. ㆆ, ㆁ et ㅿ sont également absentes de l’orthographe standard moderne, qui utilise 24 lettres de base.
L’ordre des traits est-il fixe ?
La règle générale, de haut en bas et de gauche à droite, est commune à tous les supports pédagogiques. Quelques lettres sont enseignées légèrement différemment : le tableau accepte donc seulement l’ordre qu’il montre et vous signale lorsque vous ne le suivez pas.
Pourquoi les lettres grecques et cyrilliques se ressemblent-elles ?
Le cyrillique fut développé au neuvième siècle sur la base de l’alphabet grec, et de nombreuses majuscules ont conservé la forme grecque. La norme Unicode note que les plus anciens textes cyrilliques conservés sont des manuscrits en vieux-slave du dixième siècle, et que les détails du développement de cette écriture ont été perdus.
Comment le tableau décide-t-il qu’un trait est faux ?
Il compare 32 points régulièrement espacés sur votre trait à 32 points du trait attendu. Un écart moyen inférieur à 7,5 % du carré compte comme une correspondance. Le même test exécuté à l’envers, ou avec les traits suivants, lui indique si vous avez inversé le trait ou sauté une étape.
Puis-je repasser une syllabe que j’ai construite moi-même ?
Oui. Construisez un bloc sur la page des syllabes et appuyez sur « Repasser ce bloc ». Le tableau l’écrit en suivant l’ordre initiale, voyelle, finale.
Quel est le système d’écriture le plus ancien ?
Parmi les écritures présentées ici, le cunéiforme et les hiéroglyphes égyptiens sont les plus anciens, tous deux datant d’environ 3200 avant notre ère. Le tableau date le cunéiforme des comptes d’Uruk, suivant le British Museum. Dans la tâche demandant la plus ancienne de cinq écritures, le cunéiforme est la réponse parce que les hiéroglyphes ne figurent pas parmi les choix.
Quelle différence entre un abjad et un abugida ?
Un abjad écrit les consonnes et omet les voyelles, ou les ajoute sous forme de marques facultatives, comme l’hébreu et l’arabe. Un abugida part aussi des consonnes, mais chaque consonne porte une voyelle qu’une marque modifie ; en dévanagari, क vaut ka et कि vaut ki. Dans un abjad, les lettres seules ne permettent pas de connaître la voyelle ; dans un abugida, elles le permettent toujours.
Pourquoi certaines écritures vont-elles de droite à gauche ?
Le sens a été fixé il y a longtemps et transmis de l’écriture d’origine à celles qui en sont issues. Le phénicien allait de droite à gauche, et l’hébreu et l’arabe ont conservé ce sens. L’écriture grecque a traversé une période où le sens changeait d’une ligne à l’autre avant de se fixer de gauche à droite, ce dont le latin et le cyrillique ont hérité. Le tableau montre chaque écriture dans son sens habituel, et Autre sens montre son aspect dans l’autre sens.
Pourquoi les hiéroglyphes sont-ils retournés ?
Les hiéroglyphes de personnes et d’animaux regardent le début de la ligne. Unicode les enregistre tournés vers la gauche, comme l’exige une ligne allant de gauche à droite. Le tableau écrit la ligne de droite à gauche : il inverse donc chaque signe en miroir pour qu’il regarde toujours le début.
Pourquoi le maya manque-t-il sur la page de l’eau ?
Les signes mayas ne sont pas encore encodés dans Unicode : il n’existe donc aucune manière standard de les saisir ou de les enregistrer. Seuls les chiffres mayas sont encodés. La fiche maya dessine ces chiffres à la place des lettres.
Mon nom est-il correctement écrit ?
Probablement pas exactement. L’outil retranscrit les sons à l’aide d’une table de règles, une écriture à la fois. Il ne connaît pas l’orthographe usuelle d’un nom dans un pays donné, et un nom hangeul est romanisé sans règles de changement phonétique. Le résultat montre comment chaque écriture construit un mot ; ce n’est pas une traduction.
Vocabulaire
- Initiale, voyelle, finale (choseong, jungseong, jongseong) : les trois positions dans un bloc syllabique hangeul.
- Lettre de base : une des cinq consonnes dessinées d’après les organes de la parole, ou une des trois voyelles ·, ㅡ et ㅣ.
- Trait ajouté (gahoek) : un trait supplémentaire qui transforme une lettre en celle d’un son plus fort produit au même endroit.
- Lettre de forme différente : ㆁ, ㄹ et ㅿ, qui ont reçu leurs propres formes plutôt qu’un trait ajouté.
- Voile du palais : la partie musculaire arrière du palais. Abaissé, il laisse l’air sortir par le nez.
- Haerye : la partie commentée du livre de 1446, qui explique comment les lettres ont été créées et utilisées.
- Syllabe précomposée : un bloc hangeul entier encodé comme un seul caractère Unicode.
- Abjad : une écriture qui note les consonnes et omet la plupart des voyelles, comme l’hébreu et l’arabe.
- Abugida : une écriture où chaque lettre consonantique porte une voyelle que des marques peuvent modifier, comme le dévanagari et l’éthiopien.
- Syllabaire : une écriture avec un signe par syllabe, comme les kana et le cherokee.
- Logosyllabique : une écriture mêlant signes de mots et signes de sons, comme le cunéiforme et les caractères chinois.
- Codex : un livre de pages pliées reliées au dos, par opposition à un rouleau.
- Caractère mobile : un bloc fondu par caractère, assemblé dans un cadre pour l’impression et réutilisé.
- Translittération : la notation des lettres d’une écriture avec les lettres d’une autre.
Sources
- Korea Heritage Service, National Heritage Portal, Hunminjeongeum (Trésor national). https://www.heritage.go.kr/heri/cul/culSelectDetail.do?ccbaCpno=1111100700000 (consulté le 16 octobre 2026)
- Korea Heritage Service, Memory of the World in Korea: Hunminjeongeum Haerye. https://www.heritage.go.kr/heri/html/HtmlPage.do?pageNo=4_4_2_1&pg=%2Funesco%2FMemHeritage%2FMemHeritage_01.jsp (consulté le 16 octobre 2026)
- National Institute of Korean Language, About Hangeul, essai de Kang Chang-seok sur les limites des principes de conception (ㅁ, ㅂ et ㅍ). https://www.korean.go.kr/hangeul/short/004g.html (consulté le 16 octobre 2026)
- National Institute of Korean Language, About Hangeul: the letters (19 initiales, 21 voyelles, 27 finales). https://www.korean.go.kr/hangeul/principle/001.html (consulté le 16 octobre 2026)
- National Institute of Korean Language, About Hangeul: consonants. https://www.korean.go.kr/hangeul/principle/002.html (consulté le 16 octobre 2026)
- National Institute of Korean Language, About Hangeul: vowels. https://www.korean.go.kr/hangeul/principle/003.html (consulté le 16 octobre 2026)
- National Institute of Korean Language, questions-réponses en ligne sur la conception de ㄱ et ㆁ dans le Haerye. https://www.korean.go.kr/front/onlineQna/onlineQnaView.do?mn_id=&pageIndex=1&qna_seq=336058 (consulté le 16 octobre 2026)
- National Institute of Korean Language, Hunminjeongeum Explained in Plain Language (traductions du Haerye en coréen moderne et en anglais). https://www.korean.go.kr/front/etcData/etcDataView.do?etc_seq=693&mn_id=46&pageIndex=3 (consulté le 16 octobre 2026)
- Unicode Consortium, The Unicode Standard 16.0, chapitre 3, section 3.12, Conjoining Jamo Behavior. https://www.unicode.org/versions/Unicode16.0.0/core-spec/chapter-3/ (consulté le 16 octobre 2026)
- Unicode Consortium, The Unicode Standard 16.0, chapitre 7, Europe I (Greek and Cyrillic). https://www.unicode.org/versions/Unicode16.0.0/core-spec/chapter-7/ (consulté le 16 octobre 2026)
- Unicode Consortium, tables de caractères Greek and Coptic et Cyrillic. https://www.unicode.org/charts/PDF/U0370.pdf et https://www.unicode.org/charts/PDF/U0400.pdf (consulté le 16 octobre 2026)
- Unicode Consortium, Unicode 17.0.0 (159 801 caractères, CJK Extension J). https://www.unicode.org/versions/Unicode17.0.0/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 7, Europe-I (Latin, Greek, Cyrillic, Armenian, Georgian). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-7/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 8, Europe-II (Linear A, Runic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-8/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 9, Middle East-I (Hebrew, Arabic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-9/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 10, Middle East-II (Phoenician). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-10/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 11, Cuneiform and Hieroglyphs. https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-11/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 12, South and Central Asia-I (Devanagari, Bengali). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-12/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 13, South and Central Asia-II (Tibetan, Mongolian). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-13/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 16, Southeast Asia-I (Thai). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-16/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 18, East Asia (Han, Hiragana and Katakana, Hangul). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-18/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 19, Africa (Ethiopic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-19/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 20, Americas (Cherokee, Canadian Aboriginal Syllabics). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-20/ (consulté le 18 octobre 2026)
- Unicode Standard 17.0, chapitre 21, Notational Systems (Braille). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-21/ (consulté le 18 octobre 2026)
- British Museum, How to write cuneiform. https://www.britishmuseum.org/blog/how-write-cuneiform (consulté le 18 octobre 2026)
- The Metropolitan Museum of Art, Heilbrunn Timeline, The Origins of Writing. https://www.metmuseum.org/essays/the-origins-of-writing (consulté le 18 octobre 2026)
- British Museum, Everything you ever wanted to know about the Rosetta Stone. https://www.britishmuseum.org/blog/everything-you-ever-wanted-know-about-rosetta-stone (consulté le 18 octobre 2026)
- British Museum, Hieroglyphs resources. https://www.britishmuseum.org/hieroglyphs-resources (consulté le 18 octobre 2026)
- Smithsonian National Museum of Asian Art with Smarthistory, Oracle Bone, Shang Dynasty (S2012.9.445). https://smarthistory.org/oracle-bone/ (consulté le 18 octobre 2026)
- Israel Antiquities Authority, The Leon Levy Dead Sea Scrolls Digital Library. https://www.deadseascrolls.org.il/ (consulté le 18 octobre 2026)
- UNESCO Memory of the World, Hunminjeongum Manuscript. https://www.unesco.org/en/memory-world/hunminjeongum-manuscript (consulté le 18 octobre 2026)
- UNESCO Memory of the World, dossier de candidature, Hunmin Chongum (Journée du hangeul fixée en 1946). https://media.unesco.org/sites/default/files/webform/mow001/republic_of_korea_hunmin_chongum.pdf (consulté le 18 octobre 2026)
- UNESCO Memory of the World, Baegun hwasang chorok buljo jikji simche yojeol (vol. II). https://www.unesco.org/en/memory-world/baegun-hwasang-chorok-buljo-jikji-simche-yojeol-volii-second-volume-anthology-great-buddhist-priests (consulté le 18 octobre 2026)
- UNESCO Memory of the World, The King Ram Khamhaeng Inscription. https://www.unesco.org/en/memory-world/king-ram-khamhaeng-inscription (consulté le 18 octobre 2026)
- US National Library of Medicine, Native Voices timeline, 1821: Sequoyah's syllabary. https://www.nlm.nih.gov/nativevoices/timeline/270.html (consulté le 18 octobre 2026)
- US National Park Service, Kennesaw Mountain, Cherokee Language. https://www.nps.gov/kemo/learn/historyculture/cherokeelanguage.htm (consulté le 18 octobre 2026)
- New York Public Library, Cherokee syllabary developed by Sequoyah (85 signes, à l’origine 86). https://www.nypl.org/events/exhibitions/galleries/beginnings/item/15807 (consulté le 18 octobre 2026)
- American Foundation for the Blind, Louis Braille online museum, Books in Braille (1829). https://afb.org/about-afb/history/online-museums/life-and-legacy-louis-braille/braille-nvents-his-code/books (consulté le 18 octobre 2026)
- Resmî Gazete (Official Gazette of Türkiye), numéro 1030, 3 novembre 1928, loi 1353 sur les lettres turques. https://www.resmigazete.gov.tr/arsiv/1030.pdf (consulté le 18 octobre 2026)
- Dinh-Hoa Nguyen, Alexandre de Rhodes' dictionary (1651), Papers in Linguistics 19 (1986). https://doi.org/10.1080/08351818609389247 (consulté le 18 octobre 2026)
- Agency for Cultural Affairs, Japan, Jōyō kanji table (2136 caractères, 2010). https://www.bunka.go.jp/kokugo_nihongo/sisaku/joho/joho/kijun/naikaku/kanji/ (consulté le 18 octobre 2026)
- Saxon State and University Library Dresden (SLUB), Codex Dresdensis, exemplaire numérique. https://digital.slub-dresden.de/werkansicht/dlf/2967/1 (consulté le 18 octobre 2026)
- Saturno, Stuart and Beltrán, Early Maya writing at San Bartolo, Guatemala, Science 311 (2006). https://doi.org/10.1126/science.1121745 (consulté le 18 octobre 2026)
- Kansai University, Wakumon 34, table of hiragana and katakana source characters (d’après Morioka 2006). http://www2.kansai-u.ac.jp/shkky/wakumon/no-34/03lihong.pdf (consulté le 18 octobre 2026)
- British Library, Codex Sinaiticus, Add MS 43725 (codex de parchemin, 4e siècle). https://searcharchives.bl.uk/catalog/032-002169711 (consulté le 18 octobre 2026)
- Tsinghua University, Tsinghua bamboo slips (Royaumes combattants, 475 à 221 avant notre ère). https://www.tsinghua.edu.cn/en/info/1245/14429.htm (consulté le 18 octobre 2026)
- Noto fonts (Cuneiform, Egyptian Hieroglyphs, Phoenician, Runic, Ethiopic, Tibetan, Mongolian, Cherokee), SIL Open Font License 1.1, sous-ensembles utilisés dans cette exposition. https://github.com/notofonts (consulté le 18 octobre 2026)
- Calculs de cette page : codes syllabiques à partir de 0xAC00 + (L × 21 + V) × 28 + T ; correspondance des traits sur 32 points rééchantillonnés par trait.
Textes et simulations : CC BY-NC-SA 4.0, sauf mention contraire.
D'autres expositions
Braille : apprendre à lire et écrire, tester les signaux
Un point braille mesure 1,5 mm. Six points sur une grille de 2 par 3 donnent 64 motifs communs au braille coréen, anglais, japonais et musical.
Machine à coudre : comment se forme un point
L’aiguille d’une machine à coudre ne traverse jamais entièrement le tissu : à chaque point, le crochet entraîne plutôt son fil tout autour de la canette.
Caractères mobiles et presse à imprimer
Un caractère porte sa lettre à l’envers. Encrez-le, posez une feuille dessus, pressez, retournez-la, et la lettre se lit dans le bon sens.
Machine à écrire mécanique interactive : touche, ruban
Sur une machine à écrire pica, chaque lettre, espace et point fait avancer le chariot des mêmes 2,54 mm vers la gauche.
Comment fonctionne une imprimante 3D, couche par couche
Un cube de 20 mm imprimé en couches de 0,2 mm compte exactement 100 couches, chacune tracée par une buse de 0,4 mm de large.
Origami : plier et déplier 20 modèles pas à pas
Une grue demande environ 30 plis, un gobelet six. À chaque sommet plié à plat, le nombre de montagnes et de vallées diffère exactement de deux.