图 18跟着学馆
世界文字:比较韩文与另外 22 种文字
1446 年公布韩文的书说,ㄱ 描绘舌根封闭咽喉。这里将它与另外 22 种文字并列,从泥上的楔形到盲文。
这台设备无法显示 3D 模型。下面的讲解步骤可以直接阅读文字。
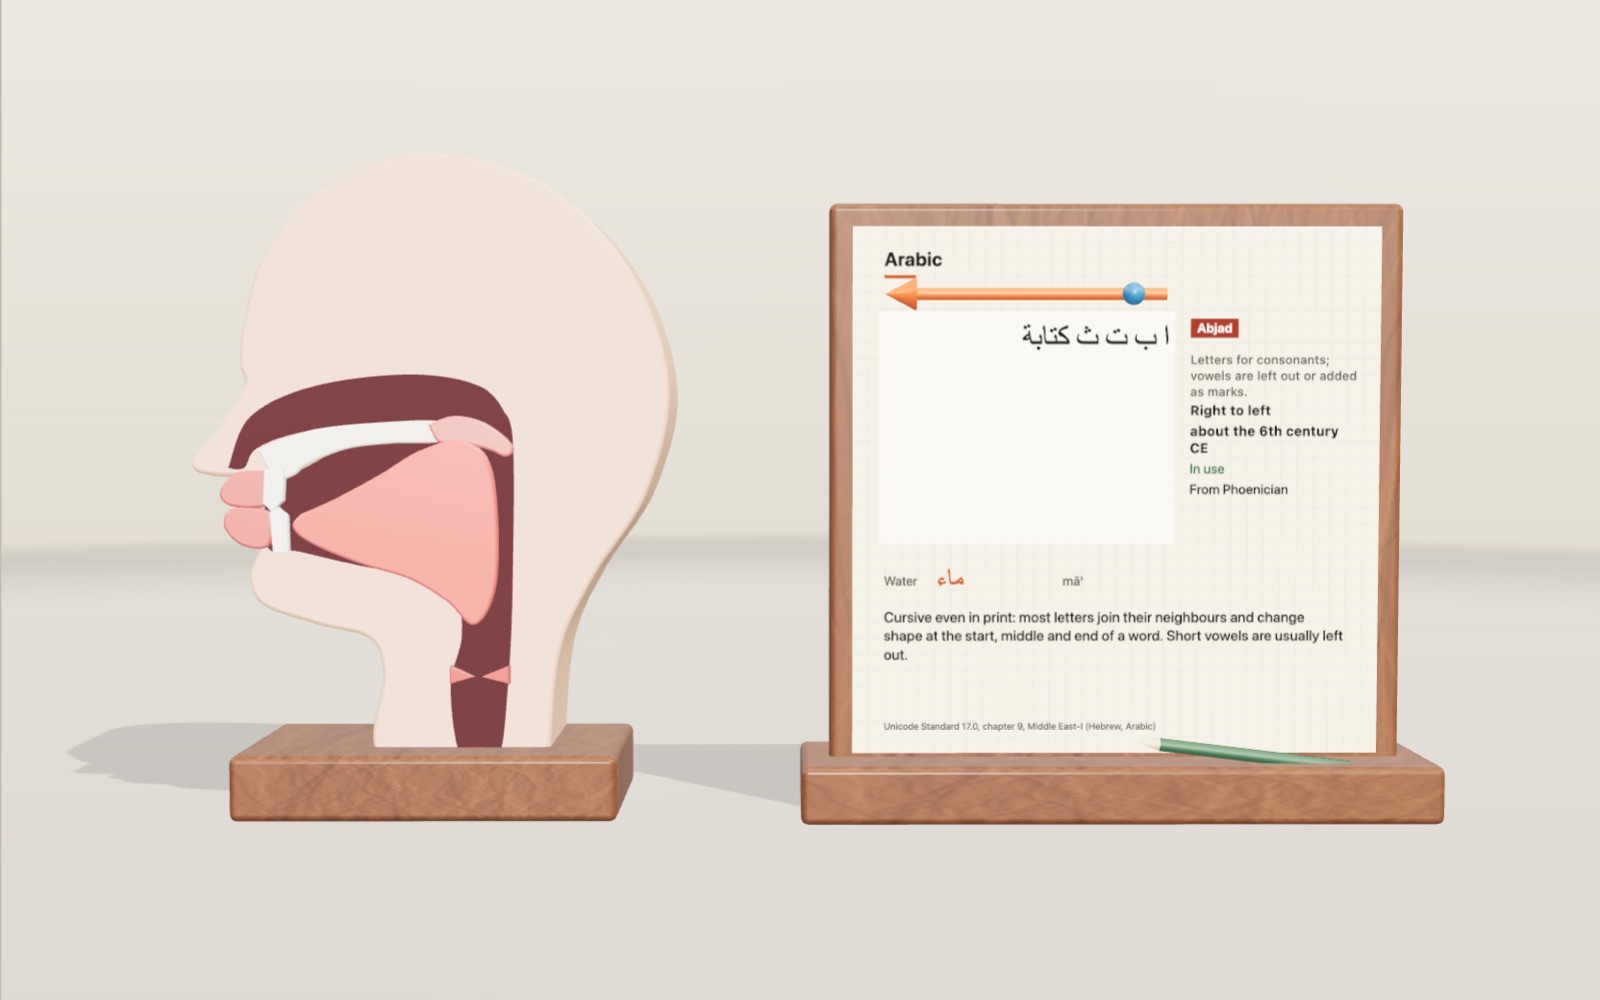
1 / 19 头部剖面与书写板左侧是沿正中剖开的头部,右侧是书写板。每个辅音都会带动舌头、嘴唇和软腭,字母本身以橙色出现在剖面上。
拖动可旋转,滚轮或双指缩放。
模型展示什么
慢慢说出韩语中表示河流的词 gang。发音开始时,舌后部向上抵住上腭,暂时阻住气流。记录这个音的字母是 ㄱ。根据 1446 年公布这套字母的书,它的形状描绘的正是这个动作。
舞台左侧是沿正中剖开的头部,如同解剖图谱中的图像:可以看到嘴唇、门齿、骨质的硬腭、后方垂下的软腭、舌头,以及向下延伸至声带的咽喉。选择五个基本辅音中的一个,舌头、嘴唇和软腭就会移动到发出该音的位置,字母本身则以橙色管线出现在剖面上。开启「气流」可以看到呼气的路径:发 ㄱ 时被挡在舌后,发 ㄴ 和 ㅁ 时从鼻腔流出,发 ㅅ 时挤过狭窄的缝隙。
右侧是一块有十二页内容的书写板。其中六页介绍韩文:五个基本字母、加画形成的字母、元音、音节拼合、带描摹功能的笔顺,以及希腊和西里尔大写字母对照表。另外六页将范围扩展到其他文字:23 种文字各自的资料卡、其中 22 种文字的「水」、13 种文字中的你的名字、与来源汉字并列的假名、三个时期的汉字,以及代替头部显示的五种 3D 书写材料。可以描摹的韩文、希腊、西里尔、汉字和假名字形并非字体排印。每个字形都根据以坐标保存的笔画列表,按人手书写的顺序和方向绘制,这也让书写板能够检查你写的笔画。其他文字使用字体排印,其中少见的文字配有小型字体文件。
从口腔画出的五个字母
希腊字母改编自腓尼基字母,拉丁字母又源于希腊字母,因此它们的形状经过漫长的继承与改造。韩文的设计思路则保留在书面记录中。这本书叫作《训民正音》,意思是「教导百姓的正确语音」;附有完整注解的《解例本》解释了每个字母的构造方法。
辅音从五个基本形状出发,各自描绘发出该音时主要起作用的器官。National Institute of Korean Language 将它们概括如下:
| 字母 | 1446 年的分类 | 形状表现的内容 |
|---|---|---|
| ㄱ | 牙音 | 舌后部抵住软腭 |
| ㄴ | 舌音 | 舌尖抵住上齿后方的齿龈 |
| ㅁ | 唇音 | 双唇闭合 |
| ㅅ | 齿音 | 牙齿 |
| ㅇ | 喉音 | 咽喉 |
关于 ㄱ 的原文是「象舌根閉喉之形」,即「模仿舌根封闭咽喉的形状」。像模型一样让头部面朝左,就容易看出两者的对应。舌头沿上腭向后延伸,然后在后部向下转折:一条横线向下折,正是 ㄱ。发 ㄴ 时,舌尖向上抵住前方的齿龈,舌身从那里向后延伸:一条竖线向右折。
ㅁ 是从正面看到的闭合嘴巴,形如方框。ㅅ 是尖尖的牙齿。ㅇ 是张开的咽喉,形如圆圈;在今天的基本字母中,也只有它位于音节开头时完全不发音。우유(牛奶)中的两个 ㅇ 都只是填补初声位置。
为更强的音增加笔画
五个字母不足以记录一种语言,因此其余字母都以它们为基础构造。规则很简单:在同一部位发出更强的音,就增加一笔。ㄴ 变成 ㄷ,ㄷ 再变成 ㅌ。ㅁ 变成 ㅂ,再变成 ㅍ;ㅅ 变成 ㅈ,再变成 ㅊ;ㅇ 变成 ㆆ,再变成 ㅎ。牙音组只有一步,从 ㄱ 到 ㅋ。
书写板第二页的每一行展示这样一个字母系列,新增的笔画用橙色表示。启动播放后,各行依次演示,每个字母在前一个完成后自行绘出。
有三个字母不遵循这个模式。ㆁ(软腭鼻音,今天在音节末尾用普通的 ㅇ 书写)、ㄹ 和 ㅿ 没有增加笔画,而是采用了各自的形状。1446 年的书将它们称为异体字。
这套体系还有另一种扩展方式。将普通字母并排写两次,就得到紧音辅音 ㄲ、ㄸ、ㅃ、ㅆ 和 ㅉ。National Institute of Korean Language 指出,平音、送气音和紧音(ㄱ、ㅋ、ㄲ)的三分对立直接反映在字形上:送气增加一笔,紧音则将字母重叠。
来自天、地、人的元音
元音遵循另一种思路。三个基本字母代表东亚哲学中的三才:圆点 · 表示天,水平线 ㅡ 表示地,竖线 ㅣ 表示站立于天地之间的人。
其余基本元音都由组合而成。在 ㅡ 上方放一个点就是 ㅗ,在下方就是 ㅜ。在 ㅣ 右侧放点就是 ㅏ,在左侧就是 ㅓ。用两点代替一点,就得到 ㅛ、ㅠ、ㅑ 和 ㅕ,即在相应元音前加一个短促的 y 音。1446 年的印本中,点确实是圆点。随着时间推移,它变成了今天书写的短笔画;书写板的元音页将两种形式上下并列展示。
较长的元音再次通过字母组合形成:ㅗ 与 ㅏ 组成 ㅘ,ㅜ 与 ㅓ 组成 ㅝ。字母创制时,ㅐ 和 ㅔ 也是由两个部分组成的元音,所以看起来像在 ㅏ 和 ㅓ 上增加一个 ㅣ。圆点元音本身已不再使用,因为它记录的音已经从语言中消失。
字母如何拼成音节方块
字母文字通常将字母排成一行。韩文也有分别表示辅音和元音的字母,但将它们写成方块,每个方块表示一个音节。表示蜜蜂的词 kkulbeol,不是将 ㄲㅜㄹㅂㅓㄹ 排成一行,而是写成两个方块 꿀벌。
一个方块最多有三个位置:初声辅音、中声元音和终声辅音。每个部分的位置取决于元音。对于 ㅏ 这样的直立元音,初声位于左侧;对于 ㅗ 这样的水平元音,初声位于上方;对于 ㅘ 这样的组合元音,初声嵌在转角处。终声始终放在下方。音节页用三种颜色勾出三个位置,每次选择都会重新绘制方块。
具体计算这些数字
现代拼写使用 19 个初声、21 个元音和 27 个终声,其中 16 个终声为单字母,11 个为 ㄺ 这样的组合。将「无终声」也计作一个选项,末尾位置就有 28 种可能。
Unicode 标准为每个可能的方块分别编码,并按固定顺序排列,因此任何音节的编码都能计算出来:
code = 0xAC00 + (initial × 21 + vowel) × 28 + final
对于 한,初声 ㅎ 的序号为 18,元音 ㅏ 的序号为 0,终声 ㄴ 的序号为 4。因此编码是 44032 + (18 × 21 + 0) × 28 + 4 = 54620,写作 U+D55C。同样的计算给出总数:19 × 21 × 28 = 11,172 个音节。无论你拼出哪个方块,书写板都会显示这项计算,角落的读数则显示电脑在该编码位置找到的字符。
笔顺以及书写板如何检查
韩文书写从上到下、从左到右,一笔一笔写。书写板的顺序遵循这个一般规则:ㄹ 先写顶部的折钩,再写中间的横线,最后写底部转角;한 中的字母则按初声、元音、终声排列。教材对少数字母的教法不同(ㅈ 有时教作两笔,有时三笔),因此这里的顺序应视为一种常见版本。
在书写板上画一笔时,系统会沿其长度等距重采样为 32 个点,预期笔画也采用同样处理。随后计算对应点之间的平均距离。如果小于书写方格宽度的 7.5%(完整音节为 6%),该笔就算通过。如果只有将其中一笔反向后才能匹配,就说明你写反了方向。如果它与后面的笔画比与当前笔画更匹配,就说明你跳过了笔画。对于 ㅇ 的圆圈,书写板还会尝试每个起点,因此能够分辨是起点不对,还是绕圈方向不对。未通过的笔画会闪红后淡出,读数会说明发生了哪种情况。
并列的希腊与西里尔字母
最后一页将十二个希腊大写字母与表示相同语音的西里尔字母并列。Unicode 标准将西里尔文字描述为九世纪在希腊文字基础上发展而来的文字,许多字母对仍有共同形状:Α 与 А、Γ 与 Г、Π 与 П、Φ 与 Ф。另一些则产生了差异。Δ 变成带脚的 Д,Λ 变成 Л,而 Σ 的音用 С 书写。有些字母对看起来与拉丁字母相同,读法却不同,例如 Ρ 和 Р 都表示 r。
每对字母都逐笔绘制,先以蓝色画希腊字母,再以红色画西里尔字母。希腊和西里尔大写字母没有统一的官方笔顺,因此这里仅采用右手书写者较自然的顺序。
模型省略了什么
头部是示意图,不是扫描图像。舌头轮廓有十三个控制点,在五个固定形状之间变化,而真正的舌头会连续改变形状。软腭绕一个铰接点摆动,咽喉部分仅显示会厌和声带。
字母与器官的对应关系是 1446 年的解释,不是测量结果。对于 ㄱ,书中说的是「舌根」,现代描述通常指舌后部抵住软腭,模型展示的是后者。研究者还指出,ㅂ 和 ㅍ 等字母难以仅用加画来解释。书写板的字母采用简单、等宽的线条绘制,便于跟随笔画。手写和毛笔字中的弯曲与粗细变化,并未在这种风格中呈现。
简史
世宗大王于 1443 年冬完成了 28 个字母。《训民正音解例本》于 1446 年农历九月雕版印刷。全书 33 叶:四叶为国王亲撰的正文,包括序文及各字母的读音;29 叶为郑麟趾领衔的八位集贤殿学者所作注解。注解分为制字、初声、中声、终声、合字及用字示例等部分。
1940 年,在安东一户人家发现了一部存本。它于 1962 年 12 月 20 日被指定为国宝,现由首尔的涧松美术馆收藏。1997 年 10 月,它被列入 UNESCO 世界记忆名录。最初 28 个字母中,四个不再用于标准拼写:圆点元音、ㆆ、ㆁ 和 ㅿ。因此剩下今天教授的 24 个基本字母。
按工作方式分类的二十三种文字
按「23 种文字」,书写板就会变成比较资料卡。列表从约公元前 3200 年在乌鲁克压入泥土的楔形文字,一直延伸到 1829 年在巴黎出版的盲文。每张卡都列出文字类型、书写方向、其来源给出的最早年代、是否仍在日常使用、已知的来源文字、示例、「水」的写法以及简短介绍。控制区下方的横条可以逐一切换文字,舞台下方的目录列出全部 23 种,并提供筛选功能。
彩色标记指出类型,应先看类型,因为它说明单个符号代表什么。
全音素文字分别使用不同字母表示辅音和元音。希腊文字是列表中最早这样做的文字;拉丁、西里尔、亚美尼亚、格鲁吉亚以及如尼文字也遵循相同思路。辅音文字记录辅音,省略大部分元音。腓尼基文字只有 22 个辅音字母,没有其他字母。希伯来和阿拉伯文字至今仍这样运作:读者依据语言知识补出元音,也可以为儿童、宗教经文或少见词加上点或小符号。Unicode 标准对希伯来文字说得很清楚:除礼仪文本外,通常省略元音点。
元音附标文字让每个辅音字母自带一个元音,并用附标改变它。在天城文中,क 是 ka;加上 ि 就变成 कि,即 ki;加上怛达点,元音就消失。泰文、藏文和孟加拉文来自同一婆罗米文字家族,大体以相同方式运作。埃塞俄比亚文字也是元音附标文字,但外观不同:每个辅音有七种形式,分别对应各个元音序列,在基础符号上附加笔画和环形。ለ、ሉ、ሊ、ላ 分别是 le、lu、li、la。
音节文字每个音节使用一个没有可见组成部分的符号。本展中的两种是日语假名和 Sequoyah 的切罗基文字。切罗基文字如今有 85 个符号,最初版本有 86 个。假名的两套系统各有 46 个基本符号。
语素音节文字将表示整词的符号与表音符号混合使用。楔形文字、埃及圣书体、汉字和玛雅文字都属于这一类,因此它们也都有数百或数千个符号。许多汉字将提示意义的部分与提示读音的部分组合起来。
韩文单独标为特征文字,因为字形记录了发音方式:五个基本辅音中的舌头或嘴唇位置、表示较强语音的附加笔画,以及元音的点、横线和竖线。盲文标为点码。两列六个凸点产生 64 种图案,Unicode 标准指出,没有哪一种图案拥有固定意义,各种语言会自行分配。
行文朝哪个方向
书写板中的大多数文字从左向右书写,但也有例外。打开比较资料卡时,橙色箭头竖立在书写板前,蓝色小珠沿箭头按书写方向移动。
腓尼基、希伯来和阿拉伯文字都从右向左书写。阿拉伯文字还有另一层难度:即使印刷体也是连写的,因此大多数字母与下一个字母相连,同一个字母在词首、词中和词尾形状不同。埃及圣书体可以朝两个方向书写,其中的人、鸟和动物符号面向行首。读者与符号正面相对。书写板上的圣书体从右向左,因此每个符号都经过镜像处理,面朝右方。开启「反向书写」,整行会改为从左向右,符号也会转向新的行首。
蒙古文从上向下书写,各列从左向右排列。这并不常见;竖排的中文、日文和韩文书籍,各列从右向左排列。竖排时,箭头朝下,示例下方另有一个短箭头指出列的排列方向。书写板采用排字引擎的方法绘制蒙古文:先水平塑形,再顺时针旋转四分之一圈,这也是蒙古文字体设计时预定的用法。
「反向书写」适用于每种文字,但并不代表它们真实的书写方式,而是用来展示发生了哪些变化。从右向左排列的拉丁文字仍能辨读,但每个词看起来都不对;把阿拉伯文字按相反方向逐字排列,会失去连笔,这说明其字形很大一部分存在于字母之间的连接,而不只是字母本身。
二十二种文字中的同一个词
「同一个词」将 22 种文字中的「水」并列展示,每种都使用这种文字今天主要记录的语言,或它过去使用时记录的主要语言,下方附有拉丁字母转写。英语 water 与俄语 вода、印地语 पानी、泰语 น้ำ、阿姆哈拉语 ውሃ 和切罗基语 ᎠᎹ 并排。楔形文字用一个符号 𒀀 书写苏美尔语 a。圣书体用三条波动的水纹。盲文用五个方格书写 water。
将 22 块字卡放在一起,就能一眼看出类型差别。语素音节文字用一两个符号表示整个词。全音素文字需要四五个字母。辅音文字在腓尼基文和希伯来文中写作 m-y-m,不写元音。这一页没有玛雅文字,因为它的符号尚未纳入 Unicode;玛雅资料卡改为展示已编码的玛雅数字:点为一,横条为五,贝壳为零。
用其他文字书写你的名字
「你的名字」将名字用 13 种文字重新拼写。可以输入拉丁字母或韩文。工具先将名字转换为一个简短的语音列表。韩文按照修订版罗马字表逐字母转写,因此 마주환 变成 majuhwan。拉丁字母依据一个小型双字母组合表读取:sh、ch、th、ph、ng、ee、oo 等。然后每种文字以各自方式拼写这些语音。
拼写方式显示了文字的类型。片假名和埃塞俄比亚文字需要用一个符号同时表示辅音和元音,因此 Maria 用片假名写作 マリア,用埃塞俄比亚文字写作 ማሪያ。天城文以辅音加元音符号书写为 मारिया,并对不带元音的辅音使用怛达点。阿拉伯和希伯来文字记录辅音,以长元音字母表示元音,这是这些文字拼写外国名字的通常方式;希伯来文字在词尾还会改用词尾形式 ם、ן、ף、ץ。希腊和西里尔文字几乎逐字对应。盲文拼写拉丁字母,并在前面加大写标记。
书写板明确说明:这是依据规则表重新拼写,实际拼法往往不同。没有应用音变规则的韩语名字罗马字转写可能显得奇怪;按照官方表格,Kim 可能写成 Gim。各国有惯用的姓名拼法,任何表格都无法预测。工具旨在展示文字如何运作,而不是生成护照用名。
假名的汉字来源与汉字演变
「假名源自汉字」将 15 个假名与它们的来源汉字并列。平假名来自整个汉字的草书形式:あ 来自 安,い 来自 以,か 来自 加。片假名取用汉字的一部分:ア 是 阿 的左边,イ 是 伊 的左边,エ 是去掉水旁的 江。对应关系依据关西大学一篇论文中的表格,该表引用了 Morioka 的假名起源图解辞典。下方的一项任务要求配对其中六组。
「汉字演变」绘出六个字的三个阶段:约公元前 1300 至 1050 年的商代甲骨文字形、小篆字形和楷书。太阳最初是内部带标记的圆圈,最后成为内部有横线的长方形。水最初是两旁带水滴的弯曲河流;楷书中,河流成为中间的竖钩,水滴成为两侧笔画。甲骨文和篆书图形是为模型制作的简化版本,因此展示的是各字形的构思,而非某一件铭刻。
毛笔笔顺
笔顺页现在有第二行:八个汉字和十二个假名。笔顺播放时,毛笔沿笔迹移动;「回看笔顺」让你手动拖动,向前或向后查看笔画。水 有四笔:中间的竖钩、左侧部分、右上短笔和右下长捺。木 先写横,再写竖,然后写左右两侧的撇捺。山 先写中间,再将左侧与底部一笔写完,最后写右侧。
你可以在书写板上描摹其中任何一个字。系统采用与韩文相同的匹配测试,判断每笔的位置、方向和顺序是否正确。关闭「毛笔」,可以看到普通笔宽的线条。
人们写在什么上面
「书写材料」将头部替换为五件物品,每次一件,书写板会说明每一件。
泥板最古老。楔形文字最初用于乌鲁克等城市的面包和啤酒配给记账,British Museum 将其描述为使用了超过 3,000 年的文字。书吏将削切的芦苇末端压入湿泥,每压一次留下一个楔形,因此符号都是楔形的组合,也因此楔形文字很少有曲线。模型泥板有七行排列整齐的楔形组合,旁边放着一根芦苇。
纸莎草卷来自埃及。纸莎草茎条以直角交叉铺成两层,经压制、干燥成片,再将纸片粘接成卷。模型展示一张以黑墨和红墨书写圣书体纵列的纸页,余下的纸卷在旁边。
早在纸张出现之前,竹简就承载着中国文字。文字从上向下写在窄条上,各条再用绳子并排编连。清华大学收藏的战国竹简,年代为公元前 475 至 221 年,保存了 70 多篇文献,其中 60 多篇已失传超过 2,000 年。将竹简编成一束,自然形成了纵列从右向左排列的中国古书方向。
羊皮纸册子本由动物皮折成书页,在书脊装订。四世纪抄写的希腊文《西奈抄本》是现存最早实例之一;British Library 将其编目为一部羊皮纸册子本。正文全部采用大写,词与词之间不留空格,正如模型书页所示。
最后是金属活字。每块金属上铸一个字,将字块排入框架,上墨后压印在纸上。活字上的每个字都是镜像,模型也展示了反向的字面。UNESCO 记载,《直指》于 1377 年 7 月在清州兴德寺使用金属活字印成,其下卷由法国国家图书馆收藏。
一个国家更换文字时
舞台下方的事件列表包括数次文字更替。1928 年 11 月 1 日,土耳其通过第 1353 号法律,以拉丁字母替代记录土耳其语的阿拉伯文字;官方公报于 11 月 3 日刊登该法律。印度尼西亚语和马来语曾用阿拉伯文字,如今使用拉丁字母;阿塞拜疆语则从西里尔文字改用以土耳其文为基础的拉丁字母。越南语以带有许多附加符号的拉丁字母 chữ Quốc ngữ 书写,其拼写源自传教士的工作;Alexandre de Rhodes 于 1651 年在罗马印行的辞典使用了这种拼写。
另一些变化保留文字体系,但精简了字表。日本 2010 年的常用汉字表列出 2,136 个通用字;现代韩文拼写去掉四个字母后,留下今天教授的 24 个基本字母。新的文字也仍在出现:Sequoyah 于 1821 年完成切罗基音节文字,几年后切罗基议会便用它出版双语报纸 Cherokee Phoenix。James Evans 在 1830 年代末为阿尔冈昆诸语言设计了音节文字,今天因纽特语使用者仍在使用。
将每种文字纳入同一标准
除玛雅文字外,23 张资料卡上的每个字母都是 Unicode 字符。2025 年 9 月 9 日发布的 Unicode 17.0 收录 159,801 个字符。新增加的 CJK 扩展 J 区加入 4,298 个表意文字,使已编码汉字总数超过 100,000。韩文音节是特例:Unicode 没有逐个列出 11,172 个方块,而是将它们按可由公式重现的顺序排列,音节页展示了该公式的运算。
有塑形规则的文字,仅有字符列表还不够。阿拉伯字母必须连写,天城文辅音必须与元音附标及其他辅音组合,蒙古文字母随位置变化,泰文元音符号则位于辅音的上、下、前或后。书写板将这些工作交给浏览器的排字引擎。对于大多数设备没有的少见文字,展览依据 SIL Open Font License 加载小型 Noto 字体子集,总共约 116 KB,仅包含这里绘制的字符。
自己试一试
控制区下方有七项任务。从列表中选出三种从右向左书写的文字。判断四种文字中哪一种只写辅音。在音节拼合器中构造表示鸡的 닭;它的终声是双辅音 ㄺ,Unicode 计算结果为 U+B2ED。将六个假名与来源汉字配对。选出五种文字中最古老的一种。按笔顺描摹 水。输入一个有两个或更多音节的名字,阅读它的埃塞俄比亚文字拼写。已完成任务的勾选会保留在你的设备上。
常见问题
为什么 ㄱ 像舌后部?
1446 年的注解说,ㄱ 模仿舌根封闭咽喉的形状。从面朝左的侧面看,舌头沿上腭下方向后延伸,再在后部向下转,正好对应 ㄱ 的横线和竖线。
ㅇ 不发音吗?
在音节开头是这样。它只填补初声位置,如 우유。在音节末尾,它读作鼻音,如 gang 的末尾。1446 年,这个鼻音有自己的字母 ㆁ,后来与 ㅇ 合并。
韩文可以写多少个音节?
Unicode 编码了 19 × 21 × 28 = 11,172 个预组音节方块。大多数从未出现在实际词语中,但书写板上每一个都能拼出来。
不再使用的四个字母怎么了?
圆点元音因所记录的音消失而停用。ㆆ、ㆁ 和 ㅿ 也不再用于现代标准拼写,现代拼写使用 24 个基本字母。
笔顺固定吗?
从上到下、从左到右的一般规则适用于所有教材。少数字母的教法略有不同,因此书写板只接受它展示的顺序,并在你跳步时提示。
为什么希腊和西里尔字母很像?
西里尔文字于九世纪在希腊字母基础上发展,许多大写字母保留了希腊字形。Unicode 标准指出,现存最早的西里尔文本是十世纪的古教会斯拉夫语手稿,其形成过程的细节已经失传。
书写板如何判断一笔写错了?
它将你笔画上等距分布的 32 个点,与预期笔画上的 32 个点比较。平均间距小于方格宽度的 7.5%,就算匹配。将同样的测试反向执行,或与后面的笔画比较,就能判断你是否写反或跳步。
可以描摹自己拼出的音节吗?
可以。在音节页拼好一个方块,按「描摹这个字」。书写板会按初声、元音、终声的顺序书写。
哪一种文字最古老?
这里的文字中,楔形文字和埃及圣书体最古老,都可追溯到约公元前 3200 年。书写板依据 British Museum,将楔形文字的年代追溯到乌鲁克账目。在要求从五种文字中选出最古老文字的任务里,答案是楔形文字,因为选项中没有圣书体。
辅音文字与元音附标文字有何区别?
辅音文字记录辅音,省略元音或将其作为可选附标,如希伯来和阿拉伯文字。元音附标文字也从辅音出发,但每个辅音自带元音,附标会改变该元音;天城文 क 是 ka,कि 是 ki。辅音文字仅凭字母不能判断元音,元音附标文字则总能判断。
为什么有些文字从右向左书写?
书写方向很早就确定了,并从母体文字传给后继文字。腓尼基文字从右向左,希伯来和阿拉伯文字保留了这个方向。希腊文字曾经历逐行交替方向的时期,后来固定为从左向右,拉丁和西里尔文字继承了这一方向。书写板展示每种文字的通常方向,「反向书写」展示反过来是什么样子。
为什么圣书体符号转向了?
表示人和动物的圣书体符号面向行首。Unicode 保存的符号朝左,这是从左向右行文所需的方向。书写板从右向左书写,因此将每个符号镜像处理,使其继续面向行首。
为什么「水」的页面没有玛雅文字?
玛雅符号尚未纳入 Unicode,因此没有标准的输入或存储方式。只有玛雅数字已经编码。玛雅资料卡因此绘制数字,而非字母。
我的名字拼对了吗?
大概不完全正确。工具逐种文字,依据规则表重新拼写语音。它不知道某国对某个名字的惯用拼法,韩文名字也在不应用音变规则的情况下转写为罗马字。结果展示各文字如何构词,并非翻译。
术语
- 初声、中声、终声(choseong、jungseong、jongseong):韩文音节方块的三个位置。
- 基本字母:根据发音器官绘出的五个辅音之一,或 ·、ㅡ 和 ㅣ 三个元音之一。
- 加画(gahoek):增加一笔,将字母变为同一部位发出较强语音的字母。
- 异体字:ㆁ、ㄹ 和 ㅿ,它们使用各自的形状,而不是增加笔画。
- 软腭:上腭后部的肌肉部分。降下时,允许气流从鼻腔流出。
- 解例:1446 年书中的注解部分,解释字母的构造与使用。
- 预组音节:作为一个 Unicode 字符编码的完整韩文方块。
- 辅音文字:记录辅音、省略大部分元音的文字,如希伯来和阿拉伯文字。
- 元音附标文字:每个辅音字母自带元音,并可用附标改变元音的文字,如天城文和埃塞俄比亚文字。
- 音节文字:每个音节使用一个符号的文字,如假名和切罗基文字。
- 语素音节文字:将表词符号与表音符号混用的文字,如楔形文字和汉字。
- 册子本:将折叠书页在书脊装订成的书,与卷轴相对。
- 活字:每个字分别铸成一个字块,排入框架印刷,并可重复使用。
- 转写:用另一套文字的字母记录一套文字的字母。
参考资料
- Korea Heritage Service, National Heritage Portal, Hunminjeongeum (National Treasure). https://www.heritage.go.kr/heri/cul/culSelectDetail.do?ccbaCpno=1111100700000 (核对于 2026 年 10 月 16 日)
- Korea Heritage Service, Memory of the World in Korea: Hunminjeongeum Haerye. https://www.heritage.go.kr/heri/html/HtmlPage.do?pageNo=4_4_2_1&pg=%2Funesco%2FMemHeritage%2FMemHeritage_01.jsp (核对于 2026 年 10 月 16 日)
- National Institute of Korean Language, About Hangeul, Kang Chang-seok 关于设计原则局限的文章 (ㅁ、ㅂ 和 ㅍ). https://www.korean.go.kr/hangeul/short/004g.html (核对于 2026 年 10 月 16 日)
- National Institute of Korean Language, About Hangeul: the letters (19 initials, 21 vowels, 27 finals). https://www.korean.go.kr/hangeul/principle/001.html (核对于 2026 年 10 月 16 日)
- National Institute of Korean Language, About Hangeul: consonants. https://www.korean.go.kr/hangeul/principle/002.html (核对于 2026 年 10 月 16 日)
- National Institute of Korean Language, About Hangeul: vowels. https://www.korean.go.kr/hangeul/principle/003.html (核对于 2026 年 10 月 16 日)
- National Institute of Korean Language, 关于解例中 ㄱ 和 ㆁ 设计的在线问答. https://www.korean.go.kr/front/onlineQna/onlineQnaView.do?mn_id=&pageIndex=1&qna_seq=336058 (核对于 2026 年 10 月 16 日)
- National Institute of Korean Language, Hunminjeongeum Explained in Plain Language (解例的现代韩文及英文译本). https://www.korean.go.kr/front/etcData/etcDataView.do?etc_seq=693&mn_id=46&pageIndex=3 (核对于 2026 年 10 月 16 日)
- Unicode Consortium, The Unicode Standard 16.0, 第 3 章,第 3.12 节,Conjoining Jamo Behavior. https://www.unicode.org/versions/Unicode16.0.0/core-spec/chapter-3/ (核对于 2026 年 10 月 16 日)
- Unicode Consortium, The Unicode Standard 16.0, 第 7 章,Europe I (Greek and Cyrillic). https://www.unicode.org/versions/Unicode16.0.0/core-spec/chapter-7/ (核对于 2026 年 10 月 16 日)
- Unicode Consortium, 编码表 Greek and Coptic 和 Cyrillic. https://www.unicode.org/charts/PDF/U0370.pdf 和 https://www.unicode.org/charts/PDF/U0400.pdf (核对于 2026 年 10 月 16 日)
- Unicode Consortium, Unicode 17.0.0 (159,801 个字符,CJK Extension J). https://www.unicode.org/versions/Unicode17.0.0/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 7 章,Europe-I (Latin, Greek, Cyrillic, Armenian, Georgian). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-7/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 8 章,Europe-II (Linear A, Runic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-8/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 9 章,Middle East-I (Hebrew, Arabic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-9/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 10 章,Middle East-II (Phoenician). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-10/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 11 章,Cuneiform and Hieroglyphs. https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-11/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 12 章,South and Central Asia-I (Devanagari, Bengali). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-12/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 13 章,South and Central Asia-II (Tibetan, Mongolian). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-13/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 16 章,Southeast Asia-I (Thai). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-16/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 18 章,East Asia (Han, Hiragana and Katakana, Hangul). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-18/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 19 章,Africa (Ethiopic). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-19/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 20 章,Americas (Cherokee, Canadian Aboriginal Syllabics). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-20/ (核对于 2026 年 10 月 18 日)
- Unicode Standard 17.0, 第 21 章,Notational Systems (Braille). https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-21/ (核对于 2026 年 10 月 18 日)
- British Museum, How to write cuneiform. https://www.britishmuseum.org/blog/how-write-cuneiform (核对于 2026 年 10 月 18 日)
- The Metropolitan Museum of Art, Heilbrunn Timeline, The Origins of Writing. https://www.metmuseum.org/essays/the-origins-of-writing (核对于 2026 年 10 月 18 日)
- British Museum, Everything you ever wanted to know about the Rosetta Stone. https://www.britishmuseum.org/blog/everything-you-ever-wanted-know-about-rosetta-stone (核对于 2026 年 10 月 18 日)
- British Museum, Hieroglyphs resources. https://www.britishmuseum.org/hieroglyphs-resources (核对于 2026 年 10 月 18 日)
- Smithsonian National Museum of Asian Art with Smarthistory, Oracle Bone, Shang Dynasty (S2012.9.445). https://smarthistory.org/oracle-bone/ (核对于 2026 年 10 月 18 日)
- Israel Antiquities Authority, The Leon Levy Dead Sea Scrolls Digital Library. https://www.deadseascrolls.org.il/ (核对于 2026 年 10 月 18 日)
- UNESCO Memory of the World, Hunminjeongum Manuscript. https://www.unesco.org/en/memory-world/hunminjeongum-manuscript (核对于 2026 年 10 月 18 日)
- UNESCO Memory of the World, 申报表,Hunmin Chongum (1946 年设立韩文日). https://media.unesco.org/sites/default/files/webform/mow001/republic_of_korea_hunmin_chongum.pdf (核对于 2026 年 10 月 18 日)
- UNESCO Memory of the World, Baegun hwasang chorok buljo jikji simche yojeol (vol. II). https://www.unesco.org/en/memory-world/baegun-hwasang-chorok-buljo-jikji-simche-yojeol-volii-second-volume-anthology-great-buddhist-priests (核对于 2026 年 10 月 18 日)
- UNESCO Memory of the World, The King Ram Khamhaeng Inscription. https://www.unesco.org/en/memory-world/king-ram-khamhaeng-inscription (核对于 2026 年 10 月 18 日)
- US National Library of Medicine, Native Voices timeline, 1821: Sequoyah's syllabary. https://www.nlm.nih.gov/nativevoices/timeline/270.html (核对于 2026 年 10 月 18 日)
- US National Park Service, Kennesaw Mountain, Cherokee Language. https://www.nps.gov/kemo/learn/historyculture/cherokeelanguage.htm (核对于 2026 年 10 月 18 日)
- New York Public Library, Cherokee syllabary developed by Sequoyah (85 个字符,原有 86 个). https://www.nypl.org/events/exhibitions/galleries/beginnings/item/15807 (核对于 2026 年 10 月 18 日)
- American Foundation for the Blind, Louis Braille online museum, Books in Braille (1829). https://afb.org/about-afb/history/online-museums/life-and-legacy-louis-braille/braille-nvents-his-code/books (核对于 2026 年 10 月 18 日)
- Resmî Gazete (Official Gazette of Türkiye), 第 1030 期,1928 年 11 月 3 日,关于土耳其字母的第 1353 号法律. https://www.resmigazete.gov.tr/arsiv/1030.pdf (核对于 2026 年 10 月 18 日)
- Dinh-Hoa Nguyen, Alexandre de Rhodes' dictionary (1651), Papers in Linguistics 19 (1986). https://doi.org/10.1080/08351818609389247 (核对于 2026 年 10 月 18 日)
- Agency for Cultural Affairs, Japan, Jōyō kanji table (2,136 个字,2010 年). https://www.bunka.go.jp/kokugo_nihongo/sisaku/joho/joho/kijun/naikaku/kanji/ (核对于 2026 年 10 月 18 日)
- Saxon State and University Library Dresden (SLUB), Codex Dresdensis, 数字副本。 https://digital.slub-dresden.de/werkansicht/dlf/2967/1 (核对于 2026 年 10 月 18 日)
- Saturno, Stuart and Beltrán, Early Maya writing at San Bartolo, Guatemala, Science 311 (2006). https://doi.org/10.1126/science.1121745 (核对于 2026 年 10 月 18 日)
- Kansai University, Wakumon 34, 平假名和片假名来源汉字表(据 Morioka 2006). http://www2.kansai-u.ac.jp/shkky/wakumon/no-34/03lihong.pdf (核对于 2026 年 10 月 18 日)
- British Library, Codex Sinaiticus, Add MS 43725 (羊皮纸册子本,4 世纪). https://searcharchives.bl.uk/catalog/032-002169711 (核对于 2026 年 10 月 18 日)
- Tsinghua University, Tsinghua bamboo slips (战国,公元前 475 至 221 年). https://www.tsinghua.edu.cn/en/info/1245/14429.htm (核对于 2026 年 10 月 18 日)
- Noto fonts (Cuneiform, Egyptian Hieroglyphs, Phoenician, Runic, Ethiopic, Tibetan, Mongolian, Cherokee), SIL Open Font License 1.1, 本展使用的子集。 https://github.com/notofonts (核对于 2026 年 10 月 18 日)
- 本页计算:音节编码采用 0xAC00 + (L × 21 + V) × 28 + T;笔画匹配采用每笔重采样的 32 个点。
解说文章与模拟采用 CC BY-NC-SA 4.0 许可,另有说明的除外。
更多展品
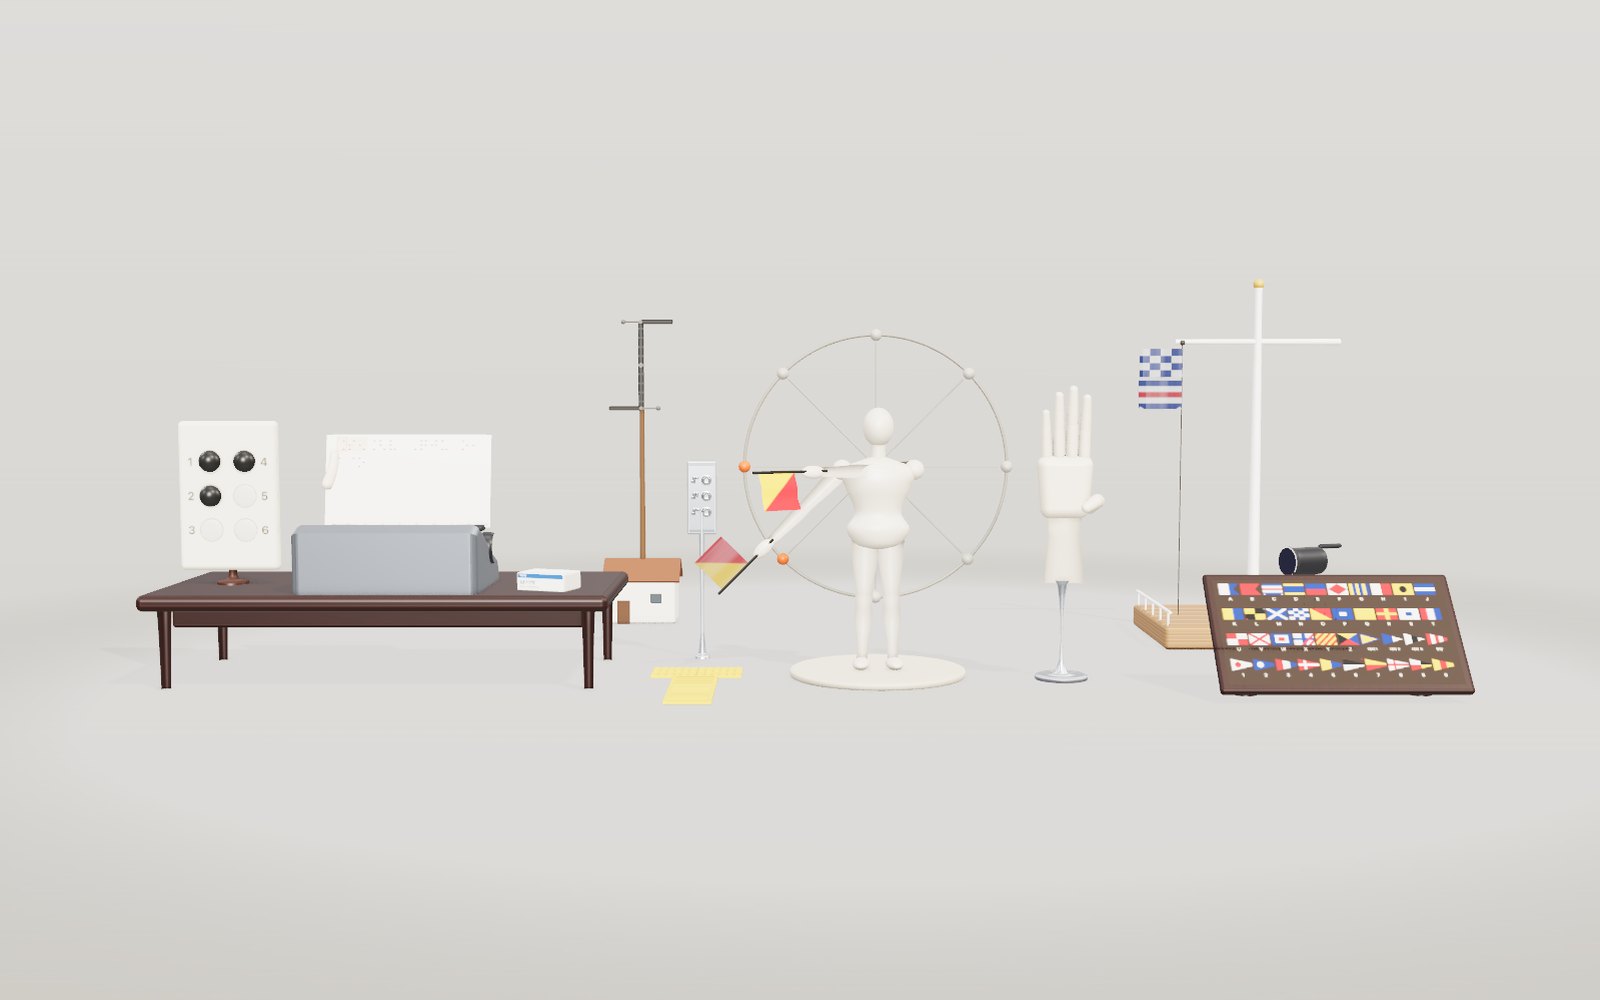
盲文、旗语与手指字母:编码原理与转换体验
一个盲文凸点直径为 1.5 mm,六个点排成 2 列 3 行,产生 64 种点形,供韩语、英语、日语及音乐盲文共同使用。
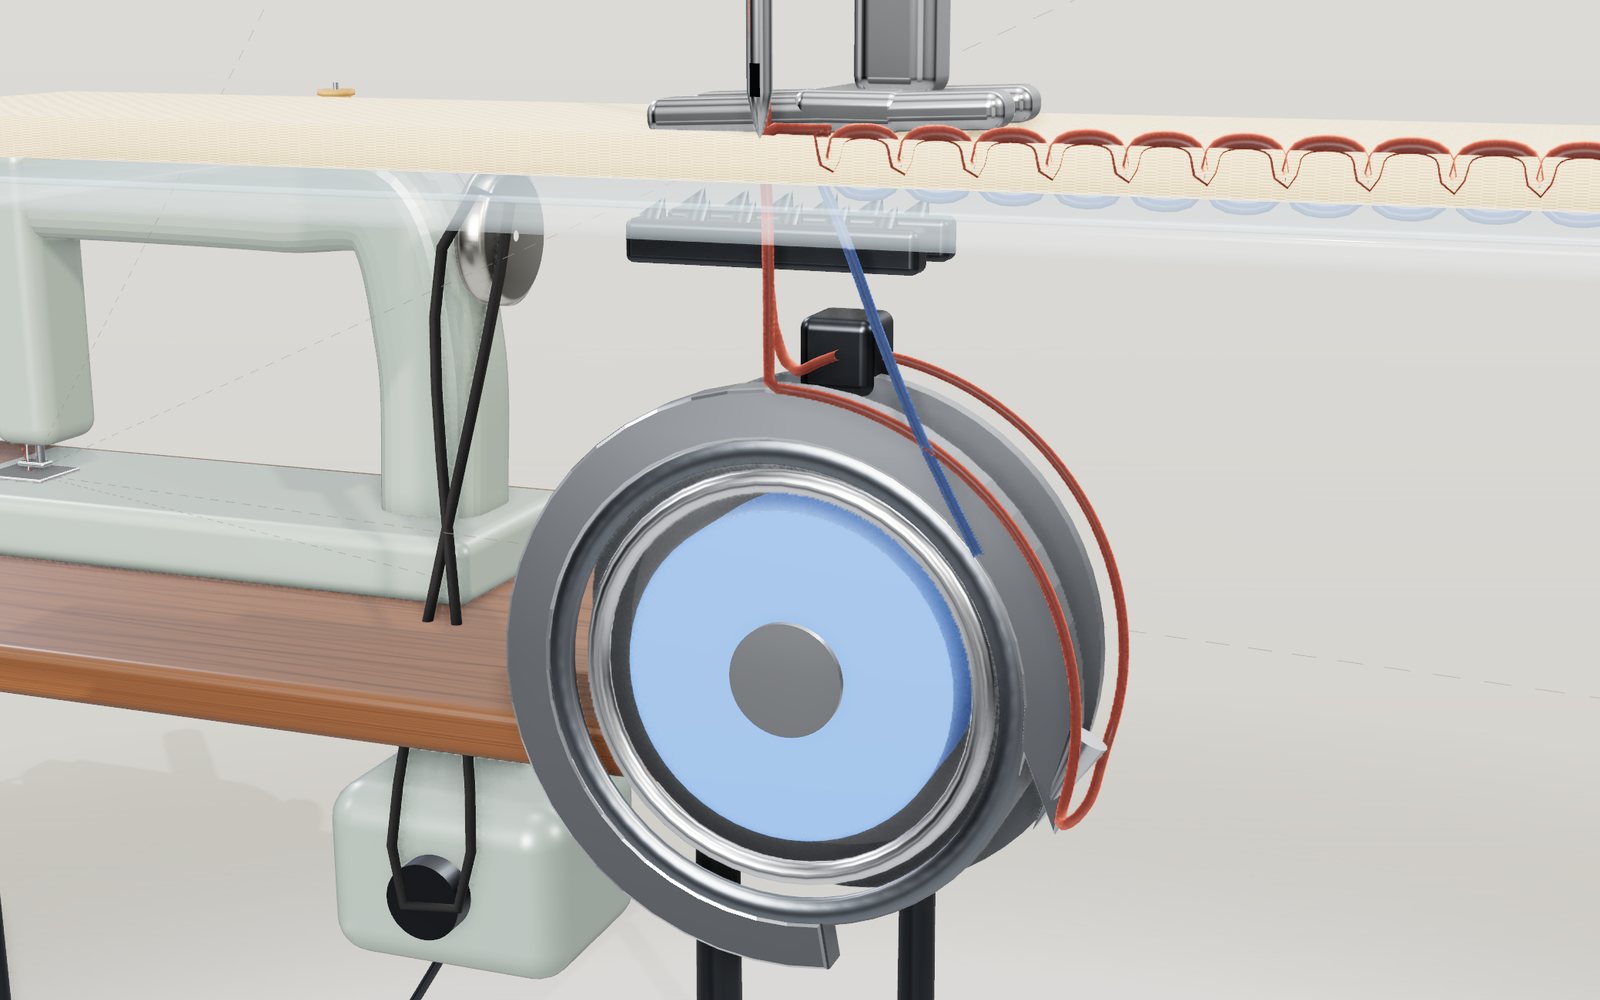
缝纫机原理:一针是怎样缝成的
缝纫机针从不完全穿过布料:每缝一针,旋梭都会带着针上的线绕梭芯一整圈。
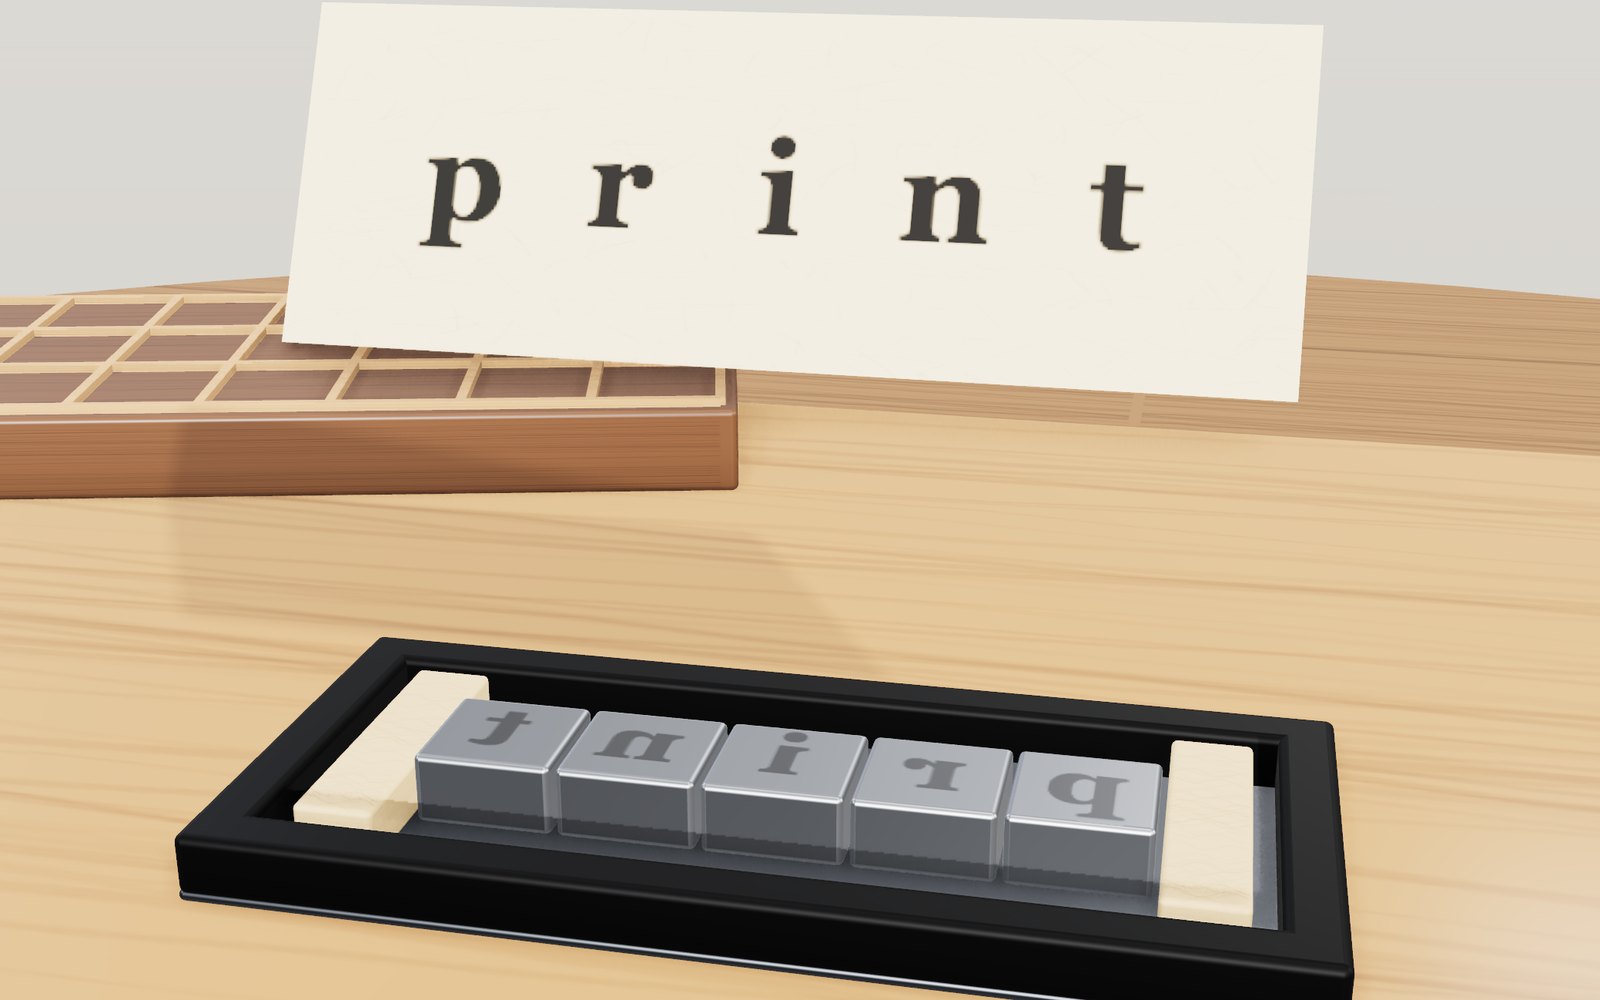
活字印刷:排出名字,了解印刷机原理
活字上的字是反向的。给它上墨,覆纸压印,再翻转纸张,字就恢复正常方向。
打字机原理:亲手打字,观察手动机构
在 pica 打字机上,每个字母、空格和句号都让字车向左移动相同的 2.54 mm。
3D 打印机:逐层成形的原理
20 mm 立方体以 0.2 mm 层高打印,恰好有 100 层,每层都由 0.4 mm 宽的喷嘴画出。
折纸:逐步折叠与展开 20 个模型
纸鹤约需 30 次折叠,杯子只需六次;你折出的每个平折点,山折与谷折的数量都恰好相差二。